
VALL-E、NaturalSpeech 2、SwanVoice 对比
同为零样本 TTS,三篇论文赌的是三个生成单元:VALL-E 把语音当 codec 语言模型,NaturalSpeech 2 用扩散生成连续隐向量,SwanVoice 一次生成整段对话。
三条路线
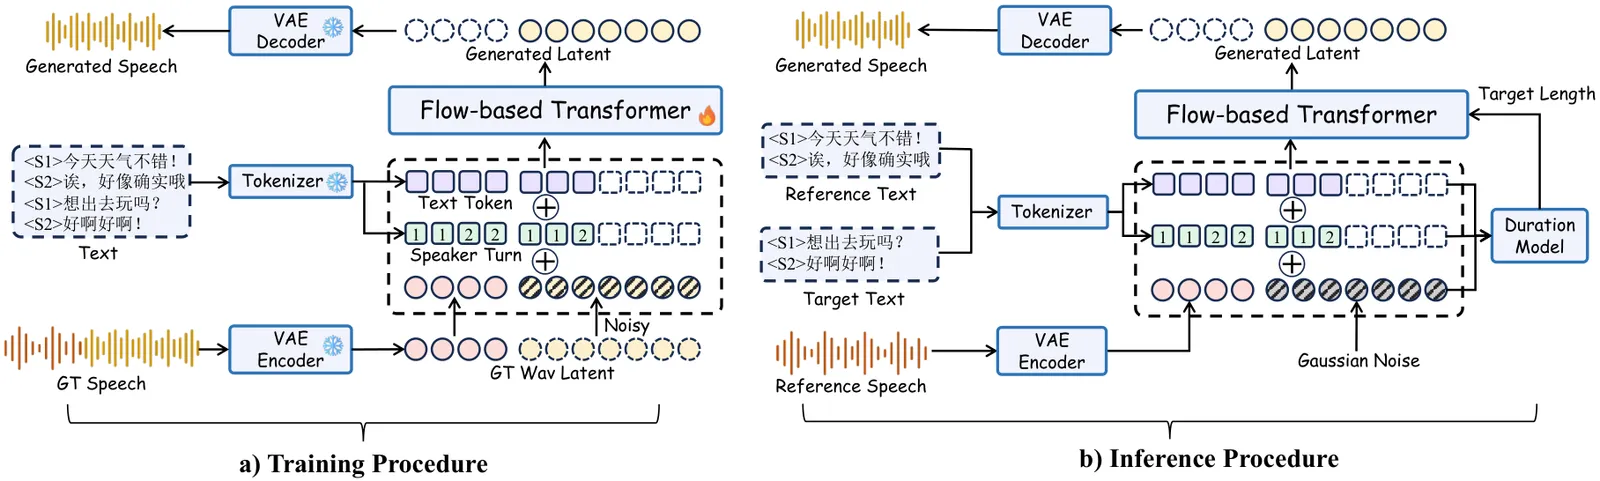
这三篇论文解的是同一个问题:没见过的人,只给一小段提示音,合成出他的声音。分歧在于「生成的基本单元」是什么。VALL-E 赌的是接口:语音压缩成离散 codec token 之后,文本转语音就变成语言建模,文本大模型那套 scaling 打法全部照搬。NaturalSpeech 2 赌的是信号:韵律本质是连续的声学变化,所以保留 codec 的连续隐向量,用扩散模型来生成,而不是从左到右逐 token 预测。SwanVoice 赌的是对象:对话本身就是一段连续的音频,唯一能让跨轮音色、节奏、情绪不散掉的办法,是把整段对话放在一次生成里完成。
所以这不是「同一个模型的三个版本,新的赢旧的」。每篇论文改的是栈里不同的层:表示、生成器、生成单元。下面的数字会告诉你,三篇论文之间能直接对比的东西其实很少。
关键数字
| 维度 | VALL-E | NaturalSpeech 2 | SwanVoice |
|---|---|---|---|
| 训练数据 | 6 万小时英文语音 | 4.4 万小时语音加歌唱 | 自建配对语料 SwanData-Speech,规模页内未给出 |
| 语音表示 | 离散 codec token | 连续 codec 隐向量 | 25 Hz VAE 隐变量 |
| 生成器 | 自回归语言模型 | 扩散模型 | 流匹配 Diffusion Transformer |
| 零样本提示 | 3 秒声音片段 | 语音提示 | 零样本,按说话人轮次条件化 |
| 生成单元 | 单句话 | 单句话,外加歌唱 | 一次生成整段独白或 1-4 人对话 |
| 核心声明 | 自然度与说话人相似度超过作者所测的上一代零样本 TTS | 在韵律相似度、音色相似度、鲁棒性、音质上全面超过此前系统 | 在自建 SwanBench-Speech 的丰富度与韵律层次两项上高于所有被测开源基线 |
| 点名的弱项 | 跳字、重复、长文本漂移,以及克隆带来的授权与冒用风险 | 扩散采样延迟;歌唱对音高节奏极敏感 | 词级内容准确率:可能读错或漏字 |
这张表更值得读的是它没有的东西:没有任何一行是三个系统在同一基准、同一指标下的得分。VALL-E 和 NaturalSpeech 2 各自挑了基线、各自定协议、各自用自己的数据报提升;SwanVoice 的头名数字来自 SwanBench-Speech,这套基准和「丰富度」「层次」两个指标都是同一团队提出的,衡量的是表现力而非念对没有。数据规模也和其它一切纠缠在一起:6 万小时英文语音和 4.4 万小时语音加歌唱是两种训练体制,单独看哪个数字都解释不了质量差。所以本页不给三者排 1-2-3,只做一件事:把每条路线映射到它适合的场景,并点出每篇论文自己承认的弱项。
各篇真正在优化什么
VALL-E 优化的是接口。 它的贡献不在某个 MOS 表格,而在一次重构:先用神经音频 codec 把语音 token 化,再训一个条件语言模型,从文本加提示片段生成 codec token。6 万小时英文预训练加 3 秒注册音,让零样本声音克隆第一次有了「上下文学习」的手感;同一套接口还会保留提示音里的情绪和房间声学。失败模式也是自回归的老问题:token 序列会跳字、重复、长输出漂移;而 3 秒就能克隆一个声音这件事本身,决定了它必须面对授权与冒用风险,也直接影响了它的发布姿态。
NaturalSpeech 2 优化的是声学自然度。 它保留了 codec,但保留的是连续隐向量,再用扩散模型在文本和语音提示条件下生成这些向量。时长与音高预测器同样吃提示音,说话风格是从参考音频里直接带过来的,而不是逐 token 重新猜。论文用 4.4 万小时数据同时做零样本语音和零样本歌唱,论据是扩散模型对连续韵律变化的刻画比离散预测更直接。代价在 serving 侧:扩散采样带来延迟和算力问题,而歌唱合成对音高、节奏的容错极低。
SwanVoice 优化的是跨轮一致性。 它把逐轮合成再拼接的做法拆出三个失败模式:同一说话人跨轮音色漂移、对话节奏断裂、情绪每到轮次边界就清零。它的解法是架构性的:用 25 Hz VAE 把长音频压到可建模的帧率;原始文本条件化加停顿符号和拼音替换保住发音线索;流匹配 DiT 直接吃说话人轮次结构,把对话布局当成一段连续隐变量一次生成。训练按课程式推进:独白、混合数据、真实对话,之后再用 DiffusionNFT 后训练,用音素级奖励抠发音、用说话人相似度奖励锁住音色。论文点名的弱项是词级内容准确率,而且说得很直白:表现力领先,但把每个字念对这件事还落后。
怎么选
- 单句声音克隆,要最简单的 scaling 故事。 VALL-E 开创的 codec 语言模型路线最成熟:表示和训练配方都被人吃透了,一小段提示就够。如果你的负载是「一个片段一个说话人」,并且能管好安全面,从这里开始。
- 要表现力韵律或歌唱。 NaturalSpeech 2 是本组里唯一明确覆盖零样本歌唱的系统,它的提示感知时长与音高预测器就是为韵律迁移准备的。预算里要留扩散采样的成本,音高敏感的内容单独验收。
- 多人对话。 SwanVoice 的单次生成是唯一把跨轮一致性做进模型、而不是事后打补丁的设计,支持 1 到 4 个说话人。当对话的听感比逐字准确更重要时选它;拿去做旁白之前,先用自己的文本测词错误率。
- 凡是准确性至上的场景,不管选哪篇。 三篇论文都在自己的评测里报自己的赢。生产选型请在自己的文本上跑全部候选,把可懂度、说话人相似度、失败案例摆到同样显眼的位置。
局限与存疑
这个对比最大的局限是排不了名。三篇论文在不同的数据上测不同的东西:VALL-E 报对自挑基线的自然度和相似度;NaturalSpeech 2 在含歌唱的 4.4 万小时上报韵律、音色、鲁棒性、音质四项提升;SwanVoice 报的是自家基准上自家提出的表现力指标。这些数字不能跨行搬运。
第二个存疑是延迟,而且按生成器分成三派。自回归 codec LM 按 token 计费,长输出会漂移;扩散在推理时按采样步数付费;SwanVoice 一次生成整段对话,这正是它一致性优势的来源,但摘要层面没交代流式行为和内存占用。交互式应用里,这个维度可能比表里任何一行都重要。
最后是声音克隆的安全问题三篇并不对称。VALL-E 的 3 秒注册音恰恰是它成为本组最强冒用风险的原因;同样的属性出现在任何后继系统上,都该配同样的发布纪律。
常见问题
三篇论文谁用的训练数据最多?
按论文报告的数字,VALL-E 的 6 万小时英文语音略多于 NaturalSpeech 2 的 4.4 万小时语音加歌唱。但这个对比比看上去弱:小时数覆盖的内容、语言、采集体制都不同,数据规模和其它设计选择缠在一起,单独看说明不了质量。
三个模型能上同一张榜排名吗?
不能,这正是本页反复强调的保留意见。每篇论文都用自己的基线和指标做评测,SwanVoice 的头名结果来自同一工作提出的 SwanBench-Speech,丰富度和层次两个指标衡量的是表现力而非念对率。三者的同口径对比在这些论文里不存在。
为什么 SwanVoice 丰富度和层次得分最高,却仍然会念错字?
因为两组指标测的不是一件事。丰富度和层次刻画表现力与韵律结构,整段对话一次生成在这里占优;词级内容准确率取决于发音建模,而这正是 SwanVoice 点名的弱项,它的 DiffusionNFT 后训练专门加了一个音素级奖励来补。把两类指标当成两条轴分别读,而不是一条此消彼长的曲线。
只有 NaturalSpeech 2 能合成歌唱吗?
在本页这三篇里,是:零样本歌唱合成是 NaturalSpeech 2 的明确目标,语音与歌唱一起训练。VALL-E 面向英文语音,SwanVoice 面向独白与对话语音。如果需求里有歌唱,这一刀就能切掉另外两个选项。
生产环境的语音克隆功能该选哪个方法?
先把生成单元对上产品:单句克隆用 codec LM,要韵律或歌唱用扩散隐向量,对话场景用单次整段生成。然后在自己的文本上评测每个入围候选,词错误率、说话人相似度、延迟都自己量——三篇论文的头名数字没有一行是在你的数据上产出的。