
ACE-Ego-0、Humanoid-GPT、DragMesh-2 对比
同一瓶颈三种押注:遥操作演示扩不起来。ACE-Ego-0 搬人类第一视角视频进预训练,Humanoid-GPT 造 20 亿帧数据再蒸馏,DragMesh-2 拆掉关节驱动只留接触物理。
同一个瓶颈
三篇论文的起点是同一个判断,Robots Need More than VLA and World Models 这篇立场论文把它说得最直白:机器人领域算力过剩、监督稀缺。遥操作演示采得慢、贵、还绑死本体,所以「多采数据、训更大的 VLA」这条路,没法像语言模型那样靠堆量翻倍。立场论文点了四个缺失接口(数据、具身、世界模型、奖励),任务是把海量没有动作标签的行为影像,转成策略能训练的监督信号。
三篇系统各自认领了一个接口去做:
- ACE-Ego-0 攻数据接口的进口:把 1479 小时人类第一视角视频转成机器人形态的伪动作,和真机演示倒进同一个预训练池。
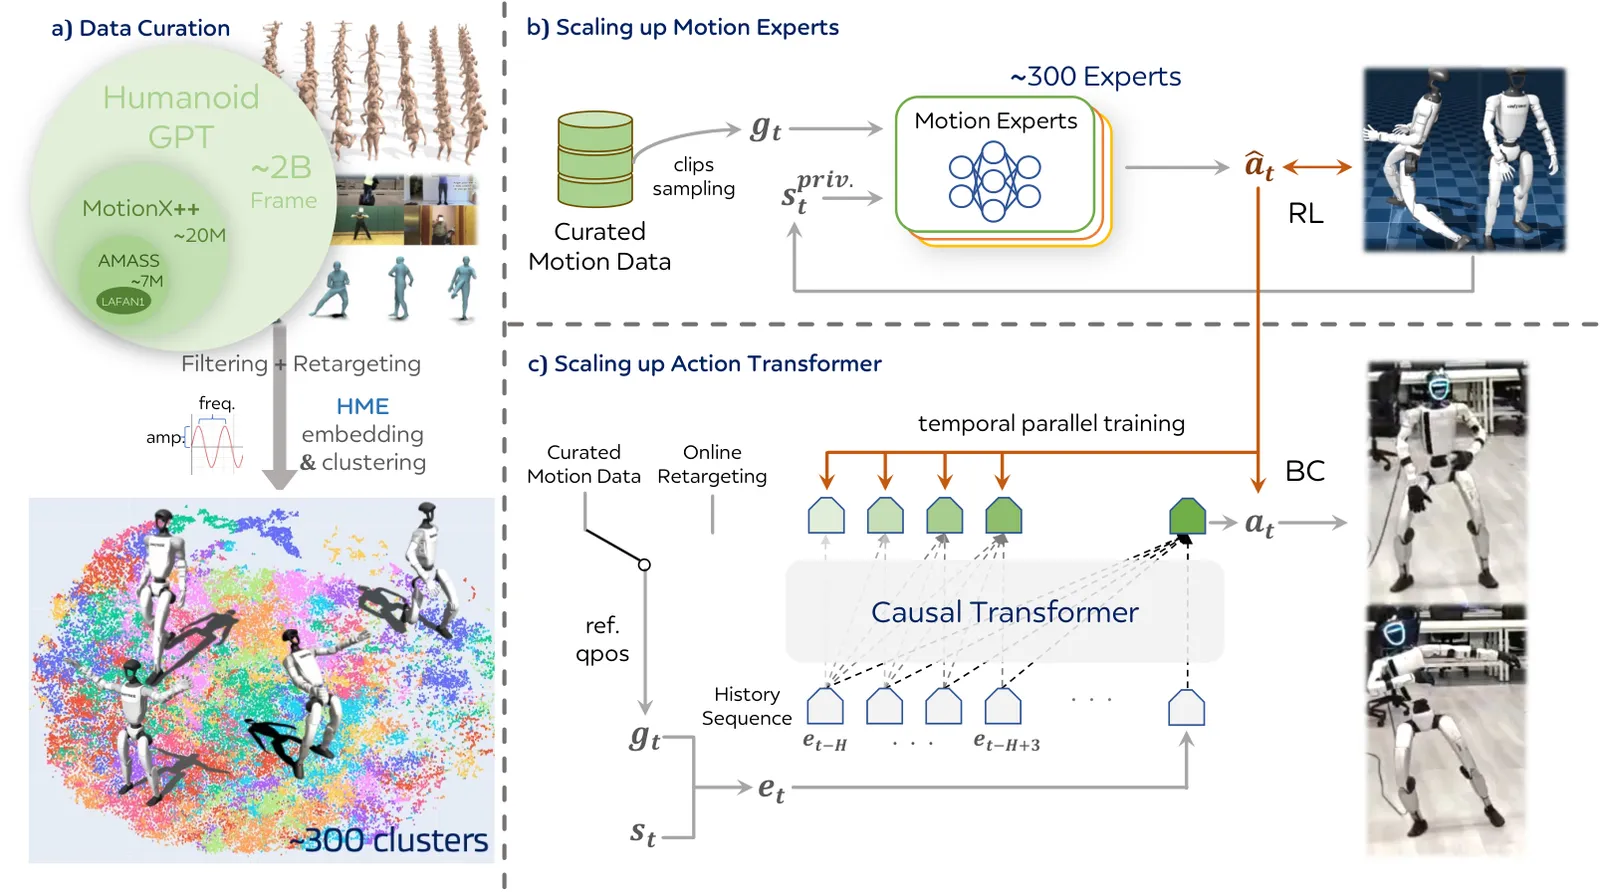
- Humanoid-GPT 从供给侧攻数据接口:自己造 20 亿帧重定向动作,先训约 384 个专职 RL 专家,再蒸馏进一个因果 Transformer。
- DragMesh-2 攻的是奖励与诚实度:把铰接物体操作里的驱动捷径拆掉(物体关节没有动作通道,门只能被手拖着开),让基准本身变成探针,检验训练信号在诚实物理下还剩多少。
三篇互不引用,却都在 2026 年年中几周内出现,回答同一个问题,策略互不兼容,这正是它们该同页对比的原因。
ACE-Ego-0 买到什么:1479 小时视频换 +4.5 分
ACE-Ego-0 的预训练池是 6013 小时:4534 小时机器人演示,加 1479 小时完全没有动作记录的人类第一视角视频。一条五级流水线(筛选片段、滤出操作段、重建三维手部、把 MANO 姿态参数化成相机系伪动作、丢弃坏样本)把人类影像转成 22 维双臂动作流,再用形态 token 和「按物理时长 2 秒切 chunk」的方式与机器人数据对齐。
真正扛结果的是一个信任分配细节:位置通道权重 1.0,旋转和夹爪通道权重 0.001。人类视频只管手往哪走,朝向和抓取基本静音,因为重建的手部姿态位置准、其他都弱。消融奖励了这种粗暴:去掉可靠性加权人类损失,RoboCasa 从 72.8% 掉到 69.2%,跌 3.6 分,比去掉形态 token(1.9)和时序对齐 chunk(1.1)都大。
头条数字:六个真机 ARX 双臂任务平均成功率 78.3%,高于 pi-0.5 的 71.7% 和 GR00T-N1.7 的 35.6%;RoboCasa GR1 TableTop 上 72.8%,压过 DIAL 的 70.2%;RoboTwin 2.0 简单 / 困难两档 91.12% / 90.62%。人类视频在起作用的干净证据是数据消融:纯机器人数据 68.3%,加入人类视频 72.8%,固定架构涨 4.5 分。数据稀缺场景里,34 条机器人演示(覆盖 0.062 平方米工作区)加 419 条人类片段(覆盖 0.296 平方米,广 4.8 倍),把扫方块成功率从 10% 拉到 40%,因为人类影像补上了遥操作没碰到过的区域。
Humanoid-GPT 买到什么:200 倍数据和一名全能跟踪器
Humanoid-GPT 的赌注是:动作跟踪扩不起来,原因和早期 NLP 一样,数据太少、模型太小。它把 AMASS、LAFAN1、MotionMillion、PHUMA 和自采数据统一成 20 亿帧重定向语料,称比此前跟踪数据集大 200 倍。单策略泛训会变「软」的老问题,用「先训专家再蒸馏」解决:按谐波动作嵌入聚类,训约 384 个各管一摊的 PPO 专家,再经 DAgger 蒸馏成一个 22.1M 到 80.4M 参数的 GPT 式因果 Transformer,直接输出各关节 PD 目标。
结果读起来像缩放定律论文:仿真跟踪成功率 92.58%,平均每关键点误差 40.99mm,模型和数据两条线都干净上涨,单张 RTX 4090 单步低于 1.5ms。真机也跑了:物理人形上四段舞蹈,MPJPE 在 0.0856 到 0.1180 rad 之间,明显差于仿真的 0.0735 rad,这是它诚实的 sim-to-real 自白。
借这套配方的人要注意两条告诫。第一,从 2 亿帧加到 20 亿帧,收益已经很边际,作者自己解读为当前模型容量下进入数据受限区;20 亿帧没有买来第二条缩放曲线。第二,它是跟踪器不是规划器:跟参考轨迹走,参考从哪来不在讨论范围。
DragMesh-2 买到什么:一个能抓住「标称成功坍缩」的度量
DragMesh-2 问的是另外两篇完全不碰的问题:把政策的拐棍抽掉,训练信号长什么样?多数操作基准悄悄给物体关节配了控制器,门是脚本开的,手只是搭便车。DragMesh-2 把拐棍撤了:51 自由度的 SMPL-X 手只控制手,洗碗机门、抽屉只在手和把手持续接触被拖动时才动,策略看不到 RGB、深度、力觉、触觉,只有运动学。
PICA(物理感知接触训练)从运动历史里重建接触:门控线性注意力编码器扫最近的交互块,辅助头预测四个接触响应信号(物体关节响应、手掌与把手距离、脱离风险、跟踪应力),奖励里加接触保持和脱离惩罚,训练时阻尼在 [1.0, 2.0] 区间随机化。
头条是一个劈叉数字,劈叉本身就是论点:标称阻尼下成功率 0.89,4 倍阻尼下 0.56,只在 7 个 GAPartNet 物体上测。只用状态的 PPO 是 0.58 / 0.27,Transformer-PPO 崩到 0.35 / 0.09。消融两半都复现不了整体:单 GLA 编码器 0.65 / 0.56 / 0.36,单 PICA 信号 0.75 / 0.71 / 0.43,完整系统 0.89 / 0.80 / 0.56。
全文最有迁移价值的是一个关于指标的警告:训练从 150 轮拉到 500 轮,标称成功率从 0.90 升到满分 1.00,而 4 倍阻尼成功率从 0.55 掉到 0.10,动作饱和度爬到 0.99。按标称数字选 checkpoint,选中的恰恰是接触能力最差的那一个。脚本式轨迹跟踪基线在分布内反而赢 PICA(1 倍下 1.00),负载下平均只追平(4 倍下 0.71);平行夹爪原语在所有阻尼下卡在 0.14。灵巧手的价值,恰好体现在标称数字说不出来的地方。
关键数字
| 维度 | ACE-Ego-0 | Humanoid-GPT | DragMesh-2 |
|---|---|---|---|
| 监督来源 | 4534 小时机器人演示 + 1479 小时人类视频伪动作 | 20 亿帧重定向数据,蒸馏自约 384 个 PPO 专家 | 不添数据,7 个 GAPartNet 物体上从运动学推断接触 |
| 头条结果 | 6 个真机 ARX 双臂任务平均 78.3%(pi-0.5:71.7%,GR00T-N1.7:35.6%) | 仿真跟踪成功率 92.58%,MPKPE 40.99mm | 1 倍阻尼 0.89,4 倍阻尼 0.56(纯状态 PPO:0.58 / 0.27) |
| 诚实度探针 | 人类视频在 RoboCasa 值 +4.5;去掉可靠性损失掉 3.6 分 | 2 亿到 20 亿帧收益边际;真机 MPJPE 0.086 到 0.118 rad,仿真 0.0735 | 150 到 500 轮:1 倍 0.90 升到 1.00,4 倍从 0.55 掉到 0.10 |
| 真机证据 | 有:ARX 双臂,每任务 30 次试验 | 有:4 段舞蹈,RTX 4090 单步低于 1.5ms | 没有,只有仿真,特权状态 |
| 消融信号 | 可靠性加权是最大单组件(3.6,人类视频增益共 4.5) | 模型(22.1M 到 80.4M)与数据两条缩放线都干净 | 单 GLA 0.65 / 0.56 / 0.36;单 PICA 信号 0.75 / 0.71 / 0.43 |
| 边界 | 只做桌面;池子里没有灵巧手、力、力矩数据 | 是跟踪器不是规划器;最大只测到约 80M 参数 | 7 个物体、纯仿真、无视觉力觉触觉 |
把三列当成三种货币。ACE-Ego-0 的分来自真机广任务成功率,Humanoid-GPT 的来自超大动作语料上的仿真跟踪精度,DragMesh-2 的来自少量接触密集物体在动力学漂移下的成功率。三者不可兑换,表里没有任何一行是正面同场对决。
怎么选
- 瓶颈是演示采集时长、任务是桌面操作:先学 ACE-Ego-0 的思路。人类第一视角视频相对遥操作近乎免费,+4.5 的 RoboCasa 增益在固定架构上测得,「位置全信、旋转和夹爪静音」的加权技巧嫁接成本低。
- 你握得住仿真器、需要全身或高动态技能:「先训一堆 RL 专家、再蒸馏成一个因果 Transformer」是这条里唯一展示出缩放行为且能实时推理的配方。但它的天花板要预算进去:作者自己的数据显示,在这些模型规模上,过了 2 亿帧收益递减。
- 任务是接触密集(门、抽屉、锁扣、带载插装):先读 DragMesh-2,再信任何标称成功率。就算不换架构,那两个抓住坍缩的诊断(脱离风险代理、动作饱和度监控)也值得直接收养。
- 你在决定整个领域的力气往哪使:立场论文的四接口是地图。ACE-Ego-0 和 Humanoid-GPT 都在造数据接口;而 DragMesh-2 隐性要求的那种接触可用的奖励接口,三篇里还没有谁造出来。
局限与存疑
三篇论文从未在同一个任务上交过手,所以上文每一句跨论文比较都是设计层判断,不是测量。ACE-Ego-0 测桌面操作,Humanoid-GPT 测动作跟踪,DragMesh-2 测 7 个仿真铰接物体;能同时赢三个基准的策略还不存在,这三篇也都没训出来。
缺失的实验恰好坐在交集上。把 Humanoid-GPT 的专家蒸馏管线拉到 DragMesh-2 的阻尼随机化任务上,按 4 倍阻尼成功率而不是标称成功率选 checkpoint,一次就能回答本页回答不了的问题:造出来的数据买到的是接触能力,还是只有广度?反方向看,ACE-Ego-0 自己的消融说明它的视频管线把旋转和夹爪通道静音了,预训练池里也没有力、力矩数据,而这正是 DragMesh-2 证明阻尼一漂就缺的那路信号。数据接口和接触接口在纸上互补,组合起来没人测过。
小一点的 caveat:ACE-Ego-0 那个 10% 到 40% 是单任务、每次 10 回合,也就是 1/10 对 4/10;Humanoid-GPT 的真机证据是四段舞;DragMesh-2 的真机定量证据为零。三处缺口作者自己都披露了,而复现预算时它们全都作数。
常见问题
三篇方法各需要多少训练数据?
ACE-Ego-0 预训练用 6013 小时(4534 机器人 + 1479 人类视频)。Humanoid-GPT 用 20 亿帧重定向数据,作者称比此前跟踪数据集大 200 倍,并报告从 2 亿加到 20 亿帧增益很小。DragMesh-2 不添加数据:7 个 GAPartNet 物体,阻尼在 [1.0, 2.0] 区间随机化。
ACE-Ego-0 真比 GR00T-N1.7 高 42.7 个百分点吗?
在六个 ARX 双臂任务上,是:78.3% 对 35.6%,每任务 30 次试验。读的时候记住 GR00T 是没在这个本体上专门调过的通用模型,任务也只是窄窄一 slice。更公平的对比是对 pi-0.5 的 +6.6,那是同档次的强基线;外加固定架构上人类视频 +4.5 的受控消融。
Humanoid-GPT 能在真机上跑吗?
能,但证据面窄:物理人形上四段舞蹈,MPJPE 在 0.0856 到 0.1180 rad,而仿真报 0.0735 rad。推理在单张 RTX 4090 上单步低于 1.5ms。论文里其余一切是仿真。
为什么 DragMesh-2 说 0.89 是个会骗人的数字?
因为 0.89 是标称阻尼下的数。同一策略在 4 倍阻尼下只有 0.56;而那个标称满分(训 500 轮而不是 150 轮)的 checkpoint,在 4 倍阻尼下掉到 0.10,动作饱和度 0.99。按标称指标选模型,选中的恰是动力学一漂表现最差的那个。
一个机器人团队应该先试哪种方法?
看瓶颈下菜。演示数据稀缺、做桌面任务,走 ACE-Ego-0 的进口策略;有仿真器、需要高动态全身技能,走 Humanoid-GPT 的造数据蒸馏配方;任务靠接触,那就先把 DragMesh-2 的两个诊断收养了,架构换不换另说。