
PhysBrain、RATs、RLDX-1 对比:机器人上岗前的本领从哪来
PhysBrain 从人类视频挖物理先验,RATs 靠玩耍攒代码技能库,RLDX-1 给 VLA 加运动、记忆、触觉三条流;附三条路线的真机数字与适用边界。
这三篇论文问的是同一个问题,只是切入点不同:新任务到来时,机器人的本领应该已经存在哪儿?传统的机器人学习从任务到来才开始计时:针对这条指令采演示、设奖励、再训练。PhysBrain 1.0、RATs 和 RLDX-1 都把学习往前挪,但挪去了三个完全不同的位置:一个去挖人类第一视角视频里已经录下的物理理解,一个让机器人自己玩、把战果存成可复用代码,一个干脆重写策略的感官、让任务期的学习变得不那么必要。三篇互不引用,都在 2026 年年中前后出现,真正的分野在于各自默认你已经拥有什么:数据、算力,还是硬件。
PhysBrain 1.0:从人类已有的视频里挖本领
PhysBrain 1.0 从最便宜的一侧进攻数据瓶颈。遥操作机器人演示采集慢、还得按形态重采,而互联网上的人类第一视角视频(Ego4D、EgoDex、EPIC)浩如烟海,只是没有机器人能照抄的动作标签。论文的主张是:动作标签从来不是值钱的部分。它的管线把原始视频当源代码,分三层编译:先抽结构化场景元信息,再用 Depth Anything v3 做深度感知的空间关系增强,最后生成有物理依据的问答对。用这些问答预训练 VLM,再适配成机器人策略,并把保住通用视觉语言能力列为适配阶段的明确目标。
真机证据来自单个 Franka 平台,每个设定 50 次试验,对比 pi0.5 基线:单物体蔬菜抓取从 47.1% 提到 63.3%,长程语义指令从 31.0% 提到 45.0%。长程那 14 个百分点更能说明问题,因为长程指令恰恰是大多数策略最先崩的地方。诚实的警告要一起读:这是技术报告,广义的 VLM 与仿真赢面(ERQA、PhysBench、LIBERO、RoboCasa)没有给出可核对的逐基准表格,适配后 VLM 能力保留多少也没有量化。
RATs:机器人自己给自己写本领
RATs(Robotics Agent Teams)完全不花训练预算。指令到来之前,挂在仿真器上的一组 LLM agent 自己提出练习目标,用 Python code-as-policy 去尝试,验证并诊断结果,再把成功蒸馏进可复用技能库。每个 agent 查的都是同一个冻结的 gemini-3.1pro-preview,不做任何微调。目标选择靠内在动机:新颖度乘上一个在成功率约 50% 处取峰的能力前沿项 4r(1-r),让机器人练那些新鲜但学得会的东西。技能有可靠性生命周期(Experimental,使用至少 3 次且成功率过 50% 升 Verified,使用 10 次以上且成功率不超 20% 降 Deprecated),失败被压缩成教训而不是丢弃。
标志性成绩出自论文自己的高难度基准:LIBERO-PRO 平均成功率从无玩耍 code-as-policy agent 的 23.2% 提到 43.8%(60 个留出任务、600 次试验),同榜上 VLA 模型 pi0.5 只有 12.8%,OpenVLA 是 0.0%。MolmoSpaces 上从 21.0% 到 38.0%(400 次试验)。最值得记住的是消融:好奇玩耍单独把基线执行器从 24.7% 抬到 32.3%,多 agent 执行器单独无玩耍就有 36.3%,两者合起来 44.3%。也就是说,约 20 个点里的大头属于框架,不属于玩耍。迁移测得很保守:把冻结技能库塞进另一个 agent 跑真机,加 8.8 个点(30.0% 到 38.8%)。400 次评测试验里 391 次至少调用了一个学来的技能,共 5,169 次,平均每轮约 12.9 次。而且 43.8% 依然意味着多数试验失败。
RLDX-1:把本领装进感官
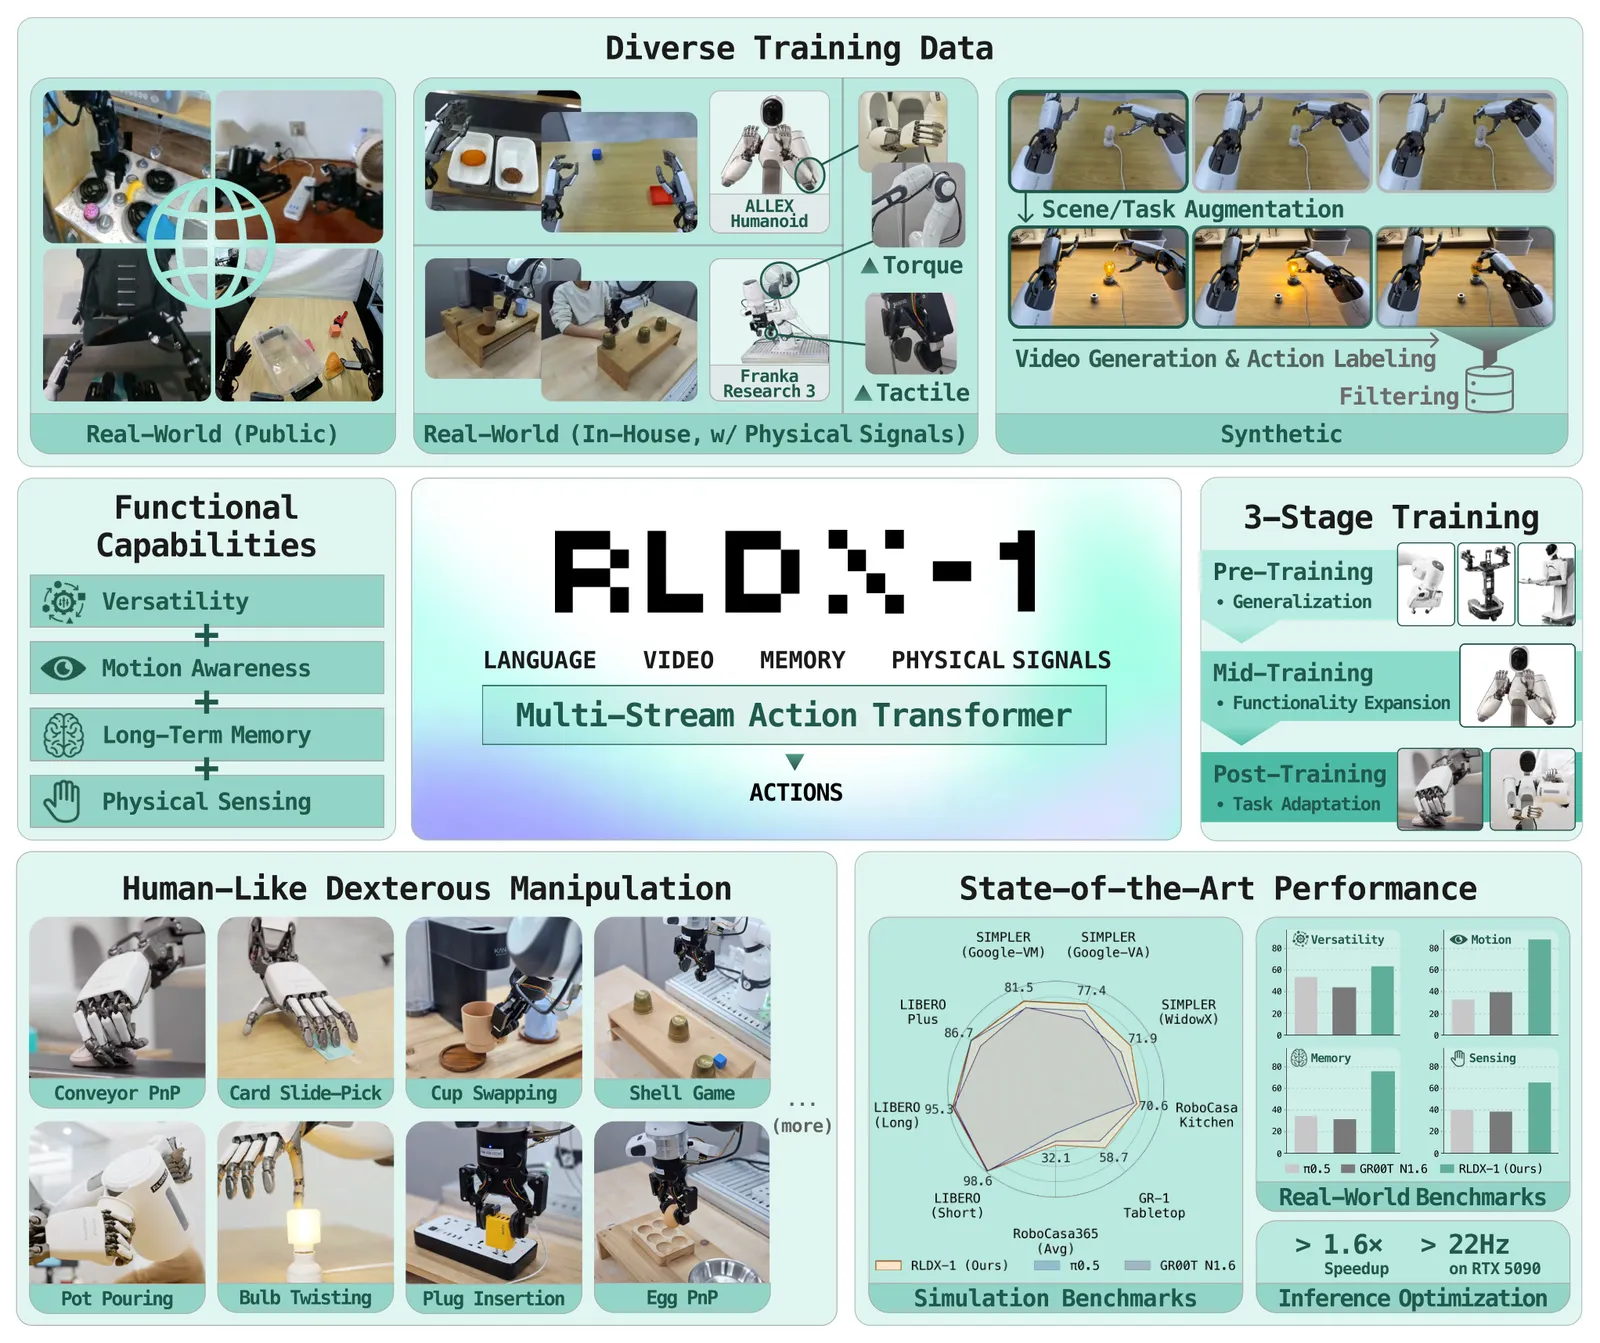
RLDX-1 的论点是:缺的本领从来不在数据里,在感官里。标准 VLA 把一张图加一句指令映射成一个动作,遇到快、接触密集、有先后顺序的任务就崩:静止帧看不出运动,无状态策略忘了两秒前看到的东西,纯视觉模型对力一无所知。RLDX-1 在 Qwen3-VL 8B 骨干上装三个模块:视觉编码器第 9 层算时空自相似度的运动模块、保留最近三份压缩场景特征的记忆队列,以及一个物理流预测未来触觉与力矩信号的多流动作 Transformer,逼模型提前预判接触。
代价是实打实的:跨形态 150 万条轨迹预训练(64 张 H200 跑 10 万步),外加中段训练和后训练,权重不放出。回报也恰好集中在论点预测的地方:用 ALLEX 仿人手抓飞行物体,87.5% 对 pi0.5 的 29.2%;盒中选物 91.7%,pi0.5 和 GR00T N1.6 都只有约 30%;LIBERO-Plus 86.7% 对 GR00T N1.6 的 72.6%;接近饱和的 LIBERO 上 97.8% 对 96.7%,聊胜于无。推理经静态图转换提速 1.63 倍,RTX 5090 上每步 43.7 毫秒。
关键数字
| 维度 | PhysBrain 1.0 | RATs | RLDX-1 |
|---|---|---|---|
| 上岗前存下什么 | 人类第一视角视频编译出的物理问答先验 | 50 轮自提玩耍攒出的、经验证的 code-as-policy 技能库 | Qwen3-VL 8B 上加装的运动、记忆、力预测三模块 |
| headline 数字 | Franka 抓取 63.3% 对 pi0.5 的 47.1%(50 次试验,同一手臂) | LIBERO-PRO 43.8% 对无玩耍基线 23.2%(600 次试验,60 任务) | 抓飞行物体 87.5% 对 pi0.5 的 29.2%(ALLEX 手) |
| 训练成本 | VLM 预训练加适配;数据是免费人类视频 | 零梯度训练:冻结 gemini-3.1pro-preview 加推理期 agent 回路 | 64 张 H200 跑 10 万步、150 万条轨迹;权重未放出 |
| 最大基线差 | 抓取 +16 点、长程 +14 点,均对 pi0.5 | 比无玩耍 agent +20.6;同榜 pi0.5 仅 12.8、OpenVLA 0.0 | 抓取 +58.3;LIBERO-Plus 对 GR00T N1.6 +14.1;LIBERO 基本打平 |
| 迁移证据 | 仅真实 Franka;跨形态真机未证 | 技能搬进另一个真机 agent:+8.8(30.0% 到 38.8%) | 真实 OpenArm 未见物体、未见任务均 54.2%,pi0.5 为 37.5% 和 45.8% |
| 诚实探针 | 50 次试验小样本;适配后遗忘未量化 | 单执行器就有 36.3%,说明框架贡献最大 | 优势在饱和基准上消失(LIBERO 97.8 对 96.7) |
| 与其他两家同口径? | 否:自家 Franka 协议 | 否:自家仿真基准与 agent 框架 | 否:自家 ALLEX 与 OpenArm 设定,作者自评 |
三列是三种货币:PhysBrain 报真机成功率,RATs 报仿真成功率加严格的跨 agent 真机迁移,RLDX-1 报自家硬件上对公开基线的成绩。中间各行的每个数字都出自拥有该列的论文、在其自家设定下测得;全表没有任何一行是两家在同一任务上同场测的。
怎么选
- **没有机器人数据、没有训练预算,但有仿真器和 LLM API:**先走 RATs 路线。纯玩耍加经验证的 code-as-policy 技能库,用冻结模型把 LIBERO-PRO 从 23.2% 推到 43.8%;+8.8 的真机迁移是把技能库塞进另一个 agent 测出来的,是更严的考法。
- **手里只有海量人类视频,任务是桌面操作:**PhysBrain 模式是最便宜的数据飞轮。别期待超出实测的效果:单臂各 50 次试验,是方向的证据,不是规模的证据。
- **任务灵巧、快速或接触密集,且硬件栈自己说了算:**RLDX-1 的论点(运动、记忆、预测力是缺失的感官)由 87.5% 对 29.2% 的抓取差距支撑得最干净。前提要备好:触觉或力矩信号、64 张 H200 级训练,而且放不出权重可抄。
- **可以叠加:**三条轴基本正交。RATs 式框架可以包住 RLDX-1 策略或 PhysBrain 初始化的 VLM;RLDX-1 的物理流预测的恰恰是 PhysBrain 视频管线抽不出来、RATs 验证器只能看成二值成败的那份接触信号。这个组合还没人发过。
局限与存疑
三家从未在任何基准上同场。PhysBrain 评在 Franka 手臂上,RATs 评在 LIBERO-PRO 与 MolmoSpaces 上,RLDX-1 评在 LIBERO 系加自家 ALLEX 手与 OpenArm 上。唯一的共同参照是 pi0.5,它在其中两篇里当基线:RATs 的 LIBERO-PRO 榜上只有 12.8%,RLDX-1 的抓取任务上是 29.2%;这是两个不同任务、不同设定,不能排在一起。上文任何跨论文的句子都是设计层面对比,不是测量。
各自还有自报口径的问题。PhysBrain 的 headline 靠单个形态上每设定 50 次试验,广义基准赢面没有可核对表格。RLDX-1 最亮的成绩出自专有硬件、作者自评,权重不放出,对 pi0.5 和 GR00T N1.6 的比较都建立在自家评测上。RATs 的全部效果系于一个冻结骨干(gemini-3.1pro-preview),换弱模型玩耍还有没有用未知;验证器误差也无界,把失败误判成成功的验证器会存进坏技能,可靠性分层要等记了若干次账之后才抓得到。
缺失的实验就在三者交叉处:拿 RATs 的玩耍回路包住 RLDX-1 的多流策略,测一测自发技能库与工程感官在接触密集任务上能不能复利。那一跑才能回答这一页回答不了的问题。
常见问题
PhysBrain 1.0、RATs、RLDX-1 里,哪个完全不用机器人数据就能试?
RATs 不需要机器人数据,只要仿真器和 LLM API,因为技能是玩耍期间写出来并验证的代码,不是网络权重。PhysBrain 也从没有机器人动作的数据(人类第一视角视频)出发,但默认你跑得动 VLM 预训练与适配管线。RLDX-1 在另一端:跨形态 150 万条机器人轨迹、64 张 H200 的预训练。
为什么 RLDX-1 抓飞行物体赢 pi0.5 五十八个点,LIBERO 上却只赢一个点?
因为它新增的三样感官瞄准的恰恰是静态基准测不到的东西:运动模块、记忆队列、触觉力矩预测流,在物体快速移动、接触力决定成败、策略需要在短时序上推理时才要紧。LIBERO 已近饱和,97.8% 对 96.7% 几乎不说明问题;87.5% 对 29.2% 的抓取成绩才是这套架构论点真正受检验的地方。
RATs 的 LIBERO-PRO 43.8% 和 RLDX-1 的 LIBERO-Plus 86.7%,谁更高?
排不了序。LIBERO-PRO 和 LIBERO-Plus 是任务分布不同的两个基准,本对比里的论文没有一个两边都跑过。诚实的读法是各自基准内对基线:RATs 比无玩耍 agent 高 20.6 个点,同榜 pi0.5 只有 12.8%、OpenVLA 0.0%;RLDX-1 在 LIBERO-Plus 上比 GR00T N1.6 高 14.1 个点。
PhysBrain 1.0 的先验、RATs 的玩耍、RLDX-1 的感官,能组合吗?
原则上可以,而且三条轴几乎不重叠:PhysBrain 供来自人类视频的岗前知识,RATs 供可包住任意策略的推理期框架与技能库,RLDX-1 供架构级的感官。已发表的最接近证据是 RATs 技能库能搬进另一个真机 agent(+8.8 点),说明这种叠加有戏;全组合没人测过。
哪一家的真机证据最硬?
家家都有,也家家在最该硬的地方偏软。PhysBrain 的 Franka 数字(抓取 63.3%、长程 45.0%,各 50 次试验)直接但样本小。RATs 的 +8.8 迁移是间接证据,但方法上更严,因为技能库搬进的是另一个 agent。RLDX-1 的 ALLEX 抓取和 OpenArm 数字最惊人,但出自专有硬件、作者自评。