
LoRA 和全量微调的区别:精度相近,权重不同
标准任务上 LoRA 与全量微调只差一分以内,可训练参数少一万倍;但它靠的是入侵维度,这些方向承担了遗忘,起初有利,持续训练下反而吃亏。
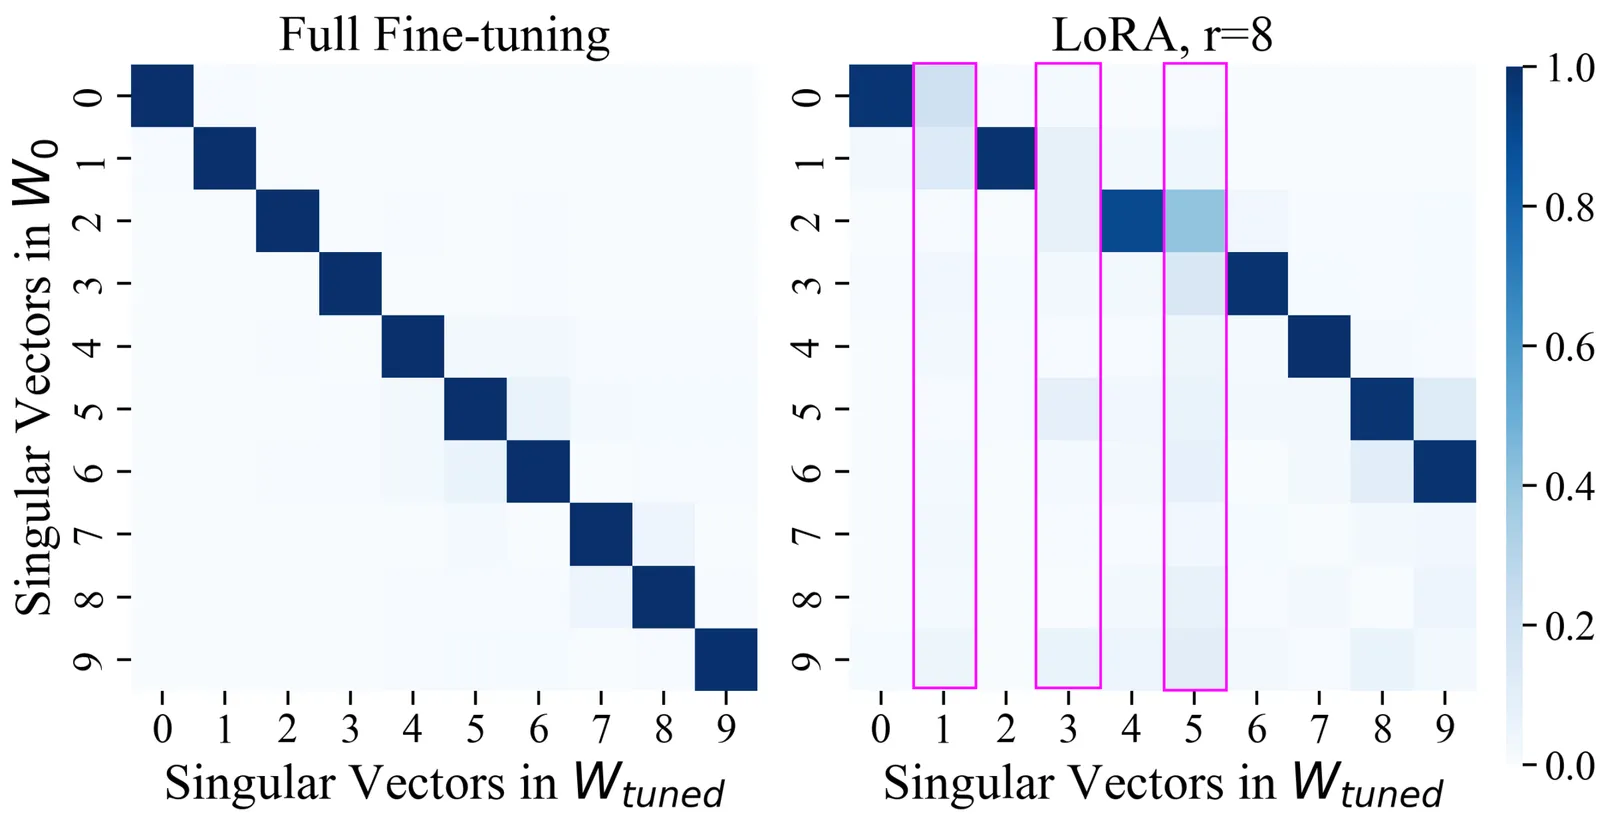
两种方法各自改动了什么
全量微调更新每一个参数。对 175B 的模型来说,每个任务就是第二份 175B 副本,外加优化器状态,Adam 下每个权重还要再多两个张量。LoRA 冻结预训练矩阵 W,只训练一个低秩修正 B·A,秩 r 通常在 1 到 64 之间。部署时把 B·A 加回 W,合并后的模型形状不变、没有额外延迟,这点不同于往前向路径里插模块的适配器层。
2021 年的 LoRA 论文量的是这笔交易的成本面:相比用 Adam 全量微调 GPT-3 175B,可训练参数最多少一万倍、GPU 显存少 3 倍,而在 RoBERTa、DeBERTa、GPT-2 和 GPT-3 上精度持平或更好。2024 年 MIT 的研究 LoRA vs Full Fine-tuning: An Illusion of Equivalence 量的是权重面,发现两种方法学到的并不是同一个东西。LoRA 训练的矩阵里含有入侵维度:奇异值很大、却与每一个预训练奇异向量近乎正交的新方向。全量微调的矩阵则让排名靠前的奇异向量留在预训练留下的位置附近。精度相同,解不同。
关键数字
| 测量项 | 全量微调 | LoRA | 设置与出处 | 同一套评测? |
|---|---|---|---|---|
| 可训练参数,GPT-3 175B | 175B | 最多少 10000 倍 | LoRA 论文,Adam | 是 |
| 训练时 GPU 显存 | 1 倍 | 约 1/3 | GPT-3 175B,LoRA 论文 | 是 |
| 额外推理延迟 | 无 | 把 B·A 合并进 W 后无 | LoRA 论文 | 是 |
| 每任务产物大小 | 数百 GB | 数 MB | LoRA 论文 | 是 |
| RoBERTa-base MNLI 准确率 | 0.8745 | r=8 0.8704,r=16 0.8739 | 入侵维度论文表 2,alpha = 2r | 是 |
| RoBERTa-base QQP 准确率 | 0.9152 | r=8 0.9093 | 同上 | 是 |
| 靠前奇异向量中的入侵维度 | 无 | 有;秩越高越少 | 入侵维度论文,RoBERTa 与 LLaMA2-7B | 是 |
| 任务精度匹配时的遗忘 | 更多 | 默认设置下更少 | 入侵维度论文图 6 | 是 |
| alpha 或学习率激进时的遗忘 | 基线 | 可能超过全量微调 | 入侵维度论文第 4 节 | 是 |
| 六个任务顺序微调 | 早期任务保持更好 | 累积入侵维度,保持更差 | 入侵维度论文图 9 | 是 |
| 事后修复:缩小入侵维度,LLaMA2-7B MetaMath r=16 | 不适用 | 遗忘降 28.2%,精度降 2.7% | 入侵维度论文表 4 | 不适用 |
| 同一修复,RoBERTa QQP r=8 | 不适用 | 遗忘降 45.0%,精度降 0.6% | 入侵维度论文表 3 | 不适用 |
成本行来自一篇论文,行为行来自另一篇,而行为行用的模型都不超过 7B。这张表说明不了 70B 规模或量化基座下这笔交易长什么样。
LoRA 的节省从哪来
节省是真的,而且会叠加。冻结权重不需要优化器状态,这是显存少 3 倍的来源。只存 A 和 B,让一个任务变成几 MB 的文件,这才让人群规模的个性化成为可想象的事:立场论文 On the Scaling of PEFT 主张在一个万亿参数基座上挂一百万个用户适配器,正是因为横向扩展的单位是适配器而不是基座。Code2LoRA 更进一步,用超网络直接生成代码仓库的适配器而不是训练它,在不花任何提示 token 装仓库上下文的情况下达到 66.2% 的仓内精确匹配。这些设计在全量微调下都不可能,因为每个变体都是一个完整模型。
遗忘这笔交易,和那个关键的但书
LoRA 通常遗忘更少,入侵维度论文表明即使任务精度匹配时也成立,所以它不是欠拟合的假象。原因是结构性的:低秩更新改写不了预训练的谱,基座的大部分靠构造就保住了。但同一篇论文表明,LoRA 确实有的那部分遗忘集中在入侵维度上,而入侵维度的数量取决于超参数。把 alpha 或学习率调高,任务精度完全相同的 LoRA 运行可能比全量微调遗忘更多。泛化最好的运行入侵维度最少。两个杠杆能减少它们:更高的秩(r=64 及以上在谱上更接近全量微调),以及在固定正交 A 上只训练 B。
持续学习把常规建议翻了过来。每一轮 LoRA 都添加自己的入侵维度,六个顺序任务之后,LoRA 模型在早期任务上比全量微调的模型更差。如果你的工作流是同一个基座反复更新,全量微调的税换来的是记忆保持。
怎么选
- 一个基座上很多任务、风格或用户;单卡;适配器以文件形式交付: LoRA。这正是方法为之设计的场景,成本表一锤定音。
- 单个任务需要大幅行为迁移(新语言、新模态头、重度领域适配): 全量微调,或高秩 LoRA,并且心里清楚成本已经在逼近全量微调。
- 对同一模型随时间反复微调: 全量微调,或者 LoRA 定期合并再开新适配器,避免入侵维度叠加。
- 无论如何用 LoRA 时: 秩取 16 或更高,alpha 和学习率保持适中;如果预训练分布上的损失重要,训练后检查入侵维度并缩小它们,论文表明这能在不到 1 分精度的代价下找回大部分遗忘。
局限与存疑
支撑”持平”说法的精度对比是 7B 以内模型上的分类和短生成任务;前沿规模的微调在两篇论文里都是空白。入侵维度分析针对原版 LoRA,DoRA 等变体只在附录里出现。遗忘用预训练损失和留出任务衡量,它们是能力损失的替身而不是直接测量。而最有实用价值的结果,训练后缩小入侵维度,只是被演示了,没有变成带推荐系数的流程。把 2021 年论文的”媲美全量微调”当成定论的人,接下来该读 2024 年论文的”并非总是”。
常见问题
LoRA 和全量微调一样好吗?
任务精度上通常只差一分以内:RoBERTa-base MNLI 全量微调 0.8745,LoRA 秩 8 是 0.8704,秩 16 是 0.8739。权重上不一样:LoRA 的解含有全量微调没有的入侵维度,它们影响遗忘和持续学习。
LoRA 比全量微调遗忘更少吗?
默认设置下是,精度匹配时也成立。但 alpha 或学习率高时 LoRA 可能遗忘更多,顺序训练多个任务时因为入侵维度累积,早期任务保持得更差。
LoRA 相比全量微调能省多少显存?
LoRA 论文报告,用 Adam 微调 GPT-3 175B 时 GPU 显存少 3 倍、可训练参数最多少一万倍,因为冻结权重不需要优化器状态,每个任务只存小的 A 和 B 矩阵。
选 LoRA 而不是全量微调时,秩该用多少?
入侵维度研究发现秩 64 及以上入侵维度更少、行为更接近全量微调,秩 1 到 8 最多。实用下限是 16,配合适中的 alpha,如果在意遗忘,训练后再检查并缩小剩余的入侵维度。