
LoRA 与全量微调等价吗:入侵维度论文解读
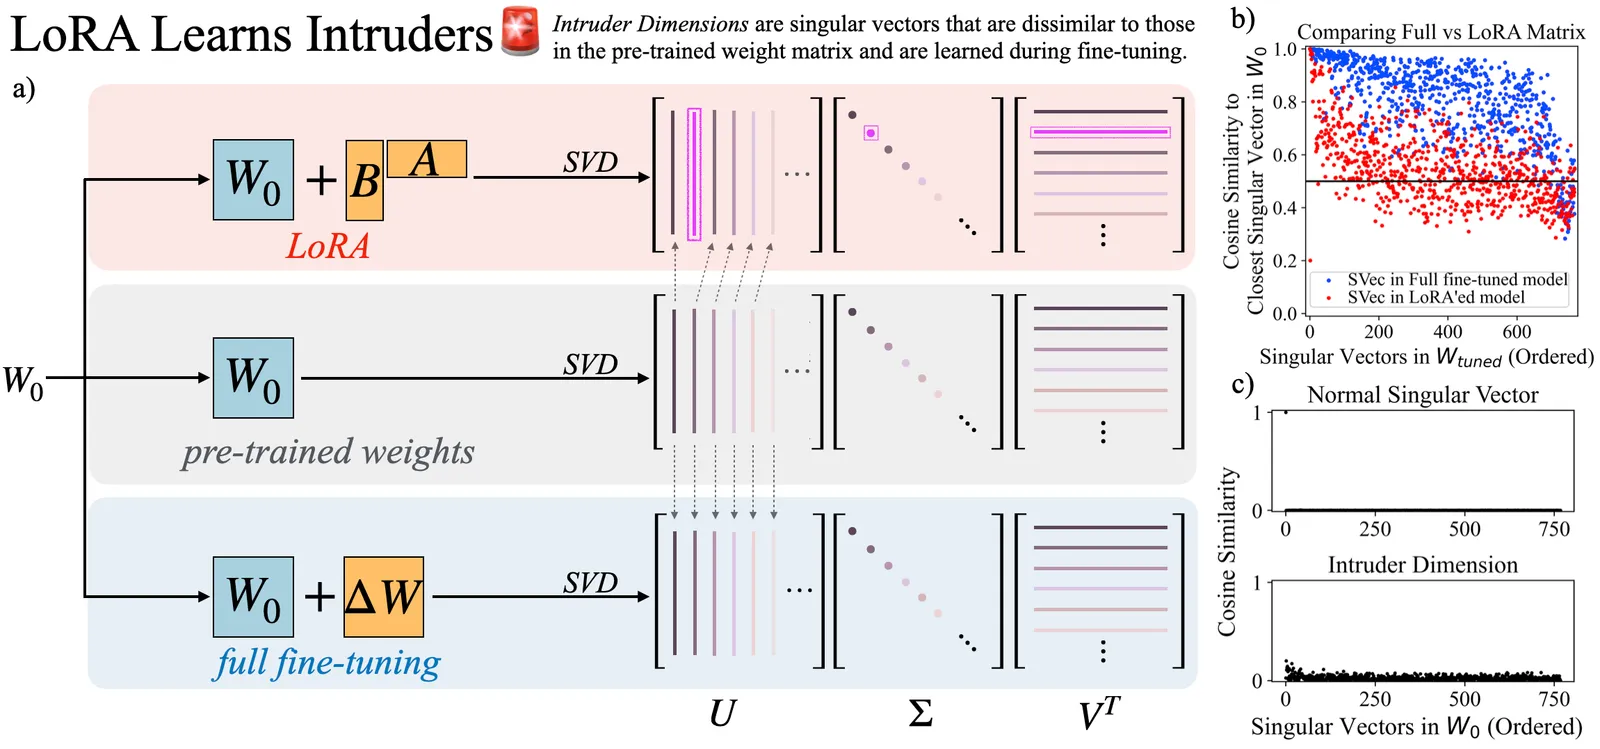
MIT 发现 LoRA 和全量微调准确率相近但权重不同:LoRA 会引入与预训练奇异向量近乎正交的高秩新方向,即入侵维度,它们承担了大部分遗忘,训练后缩小它们几乎不损失任务精度。
快速答案
论文问的是:当 LoRA 和全量微调达到相同准确率时,它们学到的是同一个解吗?答案是否定的。看微调后权重矩阵的奇异值分解,LoRA 训练的矩阵里出现了奇异值很大、却与预训练矩阵中任何方向都近乎正交的新奇异向量,作者称之为入侵维度。全量微调的矩阵没有这种东西,它们排名靠前的奇异向量仍然贴近预训练方向。入侵维度重要,是因为遗忘由它们承担:训练后缩小它们的奇异值,预训练分布上的损失能下降两位数百分比,而多数设置下任务准确率只动不到 1 分。读过 LoRA 那句”低秩适配可以媲美全量微调”,想知道这句话漏掉了什么,这篇论文就是参考文献。
入侵维度是什么
取一个预训练权重矩阵,微调它,比较前后的奇异向量。LLaMA2-7B 上的全量微调让相似度矩阵接近单位阵:训练后第 k 个奇异向量大致还指向训练前第 k 个的方向。LoRA 给出的图景不同。微调后矩阵排名靠前的奇异向量里,出现了与任何预训练奇异向量的最大余弦相似度都低于阈值的新方向(论文扫描了阈值,正文用 0.5),而且它们排名很高,也就是奇异值很大。检测流程是算法 1:对微调后前 k 个奇异向量,逐个找最相似的预训练奇异向量;相似度低于阈值就是入侵者。
论文在 RoBERTa-base 的六个分类任务,以及在 Alpaca、MetaMathQA、Magicoder-Evol-Instruct 上微调的 LLaMA-7B 和 LLaMA2-7B 上都展示了这个规律。入侵维度在低秩 LoRA 中出现,数量随秩增大而减少;r=64 及以上时 LoRA 的解在谱结构上更像全量微调。图 5 追踪了一个入侵维度的训练过程:它很早出现,奇异值不断增长,排名随训练推进而上升。
关键结果
- 相同准确率,不同权重(表 2,RoBERTa-base,alpha = 2r): MNLI 全量微调 0.8745,LoRA r=8 0.8704,r=16 0.8739;QQP 全量 0.9152,LoRA r=8 0.9093。准确率差距不到 1 分,谱结构却有质的差别。
- 拟合程度相同时 LoRA 仍然遗忘更少(图 6): LLaMA2-7B 用无关的留出任务衡量,RoBERTa 用预训练伪损失衡量,在下游准确率相同的条件下 LoRA 保留了更多预训练分布。作者把”LoRA 遗忘更少”这一已有发现推进了一步,排除了欠拟合这个解释。
- 但并非总是如此: 换不同的 LoRA alpha 和学习率,任务准确率几乎相同的 LoRA 运行表现出截然不同的泛化,包括 LoRA 比全量微调遗忘更多的情况。入侵维度最少的运行泛化最好。
- 入侵维度导致遗忘(表 3、表 4): 训练后把每个矩阵里排名最高的入侵维度缩小,预训练损失的下降远大于准确率的下降。RoBERTa QQP r=8:遗忘降 45.0%,准确率降 0.6%;MNLI r=8:遗忘降 19.8%,准确率降 0.6%。LLaMA2-7B MetaMath r=16:遗忘降 28.2%,准确率降 2.7%;Magicoder r=16:遗忘降 13.2%,准确率降 0.1%。在 RoBERTa 上把入侵维度减半,准确率损失始终不到 2%。
- 持续学习(图 9): 依次在六个任务上训练,全量微调对早期任务的保持好于 LoRA,因为 LoRA 会跨任务累积入侵维度。
- 什么能减少入侵维度: 更高的秩、固定一个随机正交的 A 只训练 B(图 10),以及更低的学习率或 alpha(附录 A.4)。
两种方法为什么分道扬镳
论文的机制解释落在乘积参数化上。全量微调用一个梯度更新整个矩阵,第一步的梯度是与数据对齐的秩一项之和。LoRA 分别更新 B 和 A,而 A 在初始化时是随机的,更新 BA 相当于把梯度投影过一个随机的低维子空间,得到的方向没有理由与预训练谱对齐。附录 A.2 显示,给预训练矩阵加一个随机向量就能很好地复现入侵维度,A.3 推导了两种更新规则第一步的差异。这也解释了为什么在固定正交 A 上只训练 B 能大幅减少入侵维度。
局限与存疑
模型是 RoBERTa-base 和 7B 的 LLaMA 变体;入侵维度在 70B 级模型或 QLoRA 式量化下是否同样表现,没有测试。遗忘用预训练损失和留出任务准确率衡量,两者都是用户真正关心的能力损失的代理指标。缩小入侵维度是事后诊断,不是训练配方;论文证明它有效,但没有给出选择缩放因子的固定方案。研究覆盖的是原版 LoRA,附录 O 只简要看了变体,关于 DoRA 或秩稳定变体的结论应查该附录而不是默认成立。结合本文与原版 LoRA 结果的正面对比见 LoRA 和全量微调的区别。
常见问题
按这篇论文,LoRA 和全量微调的区别是什么?
两者通过不同的权重变化达到相近的任务准确率。LoRA 引入入侵维度,即与预训练谱近乎正交的高秩新奇异向量;全量微调则让排名靠前的奇异向量保持贴近预训练方向。
LoRA 比全量微调遗忘更少吗?
通常是,论文确认即使任务准确率匹配时也成立。但这取决于超参数:某些 alpha 和学习率设置下 LoRA 比全量微调遗忘更多,而那些运行的入侵维度也更多。
LoRA 微调后缩小入侵维度会发生什么?
遗忘大幅下降而准确率几乎不动。RoBERTa QQP、r=8 时,预训练损失的遗忘降 45%,准确率降 0.6%;LLaMA2-7B MetaMath、r=16 时遗忘降 28.2%,准确率降 2.7%。
哪些 LoRA 设置产生的入侵维度更少?
更高的秩(r=64 及以上更像全量微调)、在固定正交 A 上只训练 B 矩阵,以及更低的学习率或 alpha。跨多个任务持续微调则相反,会累积入侵维度。