
序列建模 · Transformer · 高效 AI · 长上下文
Mamba 和 Transformer 的区别:吞吐、精确回忆与规模
Mamba 用固定大小的选择性状态换掉注意力的平方计算和 KV 缓存:解码吞吐 5 倍、3B 上打平两倍大的 Transformer,但精确回忆仍属于注意力。
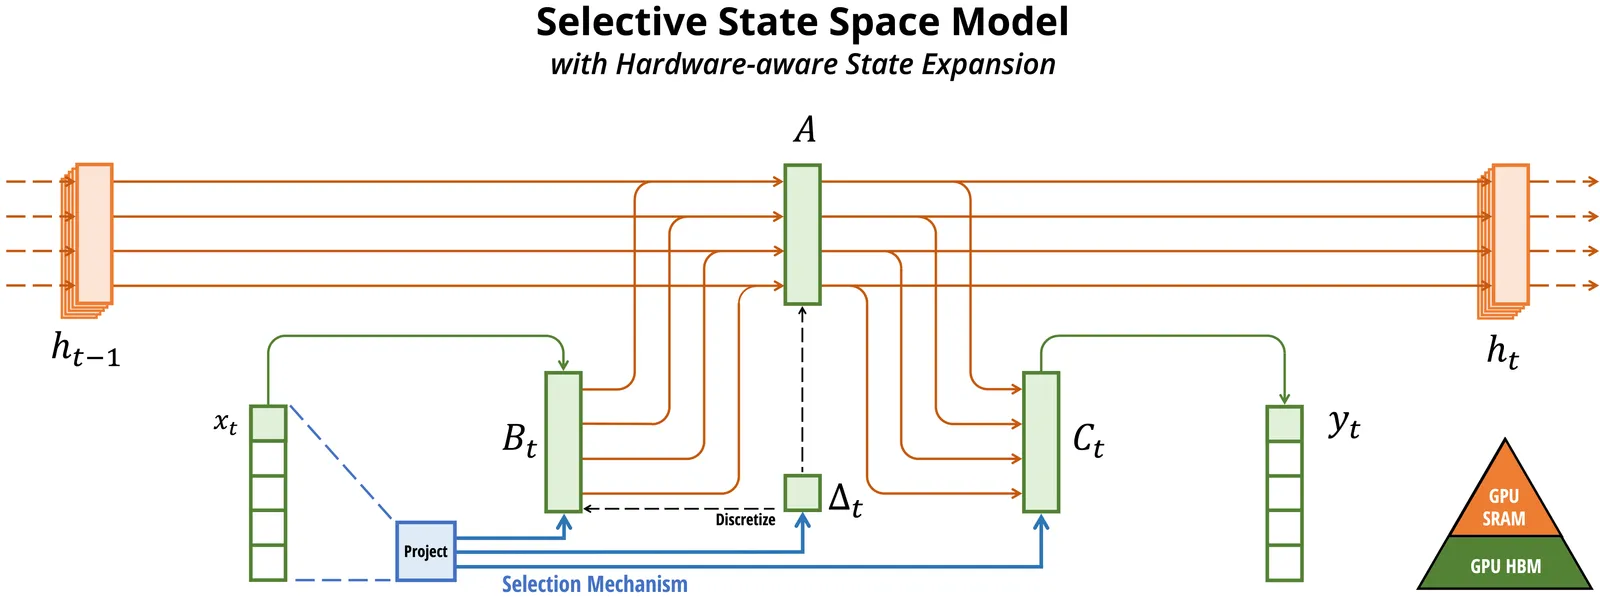
两种架构各自记住什么
两种设计对同一个问题给出了不同答案:模型对已经看过的 token 记住什么?
Transformer 全部记住。每个先前的 token 都在缓存里留下 key 和 value,每个新 token 给它们全部打分。这就是为什么任意两个位置之间的路径长度是常数,为什么模型能从 5 万个位置之前精确取回一个 token,也是为什么每个 token 的计算量随上下文增长、缓存无界膨胀。FlashAttention 靠不把注意力矩阵写进 GPU 显存把这件事提速 2 到 4 倍,但它没改平方级的 FLOP 数,改的是显存搬运。
Mamba 记住一个固定大小的摘要。选择性状态空间层把隐状态逐 token 往前传,让输入通过依赖输入的步长和投影决定往状态里写什么、让什么衰减。状态不增长,所以第 100 万个 token 的解码代价和第 100 个一样,也没有 KV 缓存需要换页。代价是状态是一种有损压缩:当时没选择保留的东西就没了。
2026 年的 On Subquadratic Architectures 把 Mamba-2、xLSTM 和 Gated DeltaNet 放进同一个门控框架,表明在次二次方家族内部,用哪种门决定了状态能算什么。这对本文的对比很重要:2026 年的”Mamba”是设计空间里的一个点,不是注意力的全部替代方案。
关键数字
| 测量项 | Transformer | Mamba 或 SSM | 设置与出处 | 同一套评测? |
|---|---|---|---|---|
| 自回归解码的推理吞吐 | 1 倍 | 5 倍 | Mamba 论文,参数量相同 | 是 |
| 每 token 计算量随上下文的变化 | 随长度增长(总量平方级) | 常数 | 设计 | 是,由定义决定 |
| token 之间携带的状态 | KV 缓存,线性增长 | 固定大小隐状态 | 设计 | 是 |
| 3B 规模的语言建模 | 基线 Transformer | Mamba-3B 胜过同尺寸、打平两倍尺寸 | 预训练困惑度与下游评测,Mamba 论文 | 是 |
| 质量仍在提升的最长序列 | 未报告 | 真实数据上到 100 万长度 | Mamba 论文 | 否 |
| Path-X 上超过随机水平的最长上下文 | 16K,61.4%,使用 FlashAttention | Mamba 未报告 | FlashAttention 论文 | 否 |
| IO 感知带来的精确注意力提速 | 2 到 4 倍,GPT-2 1K 端到端 3 倍 | 不适用 | FlashAttention | 不适用 |
| 长度 2048 的状态跟踪(奇偶、S3) | 论文框架下受 TC0 上限约束 | Mamba-2 从未超过 0.352;xLSTM[1:1] 1.000 | 训练长度 128,次二次方研究 | 是,SSM 家族内部 |
| 外推到 2048 的计数(多数表决) | 未跑 | Mamba-2 0.241;Gated DeltaNet 0.268;xLSTM[1:0] 0.763 | 同一研究 | 是,SSM 家族内部 |
| 1000 万参数的时间序列 GIFT-Eval | 未跑 | Mamba-2 MASE 0.767 / CRPS 0.525;xLSTM[3:1] 0.733 / 0.508 | 同一研究;8000 万参数时收敛 | 是,SSM 家族内部 |
| 有正面对比证据的最大规模 | 前沿模型是 Transformer 或混合架构 | 约 3B(Mamba),4 亿(2026 研究) | 两篇论文 | 否 |
前四行是人们搜”mamba vs transformer”时真正想要的对比,全部来自 Mamba 论文自己的受控实验。下面几行是 SSM 变体之间的比较,不是和注意力比;放在这里是因为它们解释了 Mamba 的固定状态在哪里失效,而这正是它在回忆任务上输给注意力的同一个原因。
5 倍从哪来,哪里没有
吞吐收益是解码阶段的结果。生成时 Transformer 每出一个新 token 都要重读不断增长的 KV 缓存,上下文越长越受显存带宽限制;Mamba 更新的是常数大小的状态,每 token 代价是平的。Mamba 论文报告同尺寸下推理吞吐高 5 倍,并且质量在百万 token 序列上还在提升,而那正是稠密注意力不可行的区间。
训练是另一回事。时不变的 SSM 可以算成一次全局卷积,很快。参数一旦依赖输入,这条捷径就没了,Mamba 的答案是把展开的状态留在 SRAM 里的硬件感知并行扫描。这和 FlashAttention 对注意力做的是同一类事:算法上的优势只有配上尊重 GPU 显存层级的 kernel 才显现。两种架构的头条速度都不能自动迁移到无法融合算子的框架里。
精确回忆是结构性的取舍
注意力能寻址任何先前的 token,因为每个 token 都还在。循环状态做不到,它只保留选择机制当时决定留下的东西。Mamba 论文直接点名了这一点:需要精确回忆任意先前 token 的任务,比如复制和精确检索,可能更适合显式注意力。次二次方研究在合成任务上把机制讲具体了:在长度 128 训练、长度 2048 测试,Mamba-2 在计数上崩溃(多数表决准确率 0.241),奇偶和置换复合(S3)从未解出,而输入门和遗忘门分离且为指数形式的 xLSTM 变体在多数表决上外推到 0.763,在奇偶和 S3 上达到 1.000。门控的数学形式决定了固定状态能否把一个计数保持到训练长度之外,Mamba-2 绑定的门做不到。
这就是为什么领域走向了混合架构而不是纯 SSM。在 Mamba 堆叠里穿插几层注意力,用一小部分 KV 缓存的代价找回精确回忆的通路;Mamba 论文预见了这一点,2025 和 2026 年大多数生产级”Mamba”模型都是这么建的。
怎么选
- 长上下文检索、大海捞针任务、有远距离引用的代码: Transformer,或带注意力层的混合架构。精确回忆是固定状态唯一被证明无法保证的事。
- 解码吞吐受限、流式、端侧、几十亿参数以内的模型: Mamba 类层。5 倍解码和 3B 打平的结果就是证据,而且恰好在这个规模最强。
- 8K 以下上下文的稠密 Transformer: 你想省的代价本来就小。FlashAttention 级 kernel 已经去掉了大部分显存开销,Mamba 的优势很难观察到。
- 2026 年在次二次方层之间选型: 别默认 Mamba。次二次方研究发现 xLSTM 变体在 4 亿参数的代码预训练上领先 0.90 到 1.81 个 HumanEval 点,在状态跟踪上领先,差距在更大的时间序列规模上消退。在你任务的基本原语上测试门控变体。
局限与存疑
受控的 Mamba 对 Transformer 证据止步于 3B 参数附近,2026 年的次二次方对比在代码上只到 4 亿、时间序列只到 8000 万,而它自己的差距在那里已经缩小或反转。纯选择性 SSM 在几百亿参数上能否打平注意力,这些论文没有测;业界实际选择的答案是混合架构,这本身就承认了回忆差距是真的。表里 Transformer 一侧也比看上去更旧:2017 年那篇论文测的是翻译不是语言建模,所以每一行的”Transformer 基线”都是 SSM 论文自己按自己的配方训出来的那个 Transformer。而且这几篇论文都没有报告在同等实际耗时预算下,Mamba 对 FlashAttention Transformer 的长上下文精确检索基准,那才是部署决策真正需要的数字。
常见问题
Mamba 比 Transformer 快吗?
解码时快:Mamba 论文报告同参数量下推理吞吐高 5 倍,因为 Mamba 更新固定大小的状态而不是重读不断增长的 KV 缓存。训练和短上下文下差距很小,而且配 FlashAttention 的 Transformer 相对朴素注意力已经找回了 2 到 4 倍。
同等规模下 Mamba 的质量能追平 Transformer 吗?
在 3B 规模,Mamba 论文报告 Mamba-3B 在预训练困惑度和下游评测上胜过同尺寸 Transformer、打平两倍尺寸的 Transformer。几百亿参数上没有可比的受控结果,那个规模的生产模型是 Transformer 或混合架构。
为什么 Transformer 在复制和精确回忆上胜过 Mamba?
因为注意力把每个先前 token 都留在 KV 缓存里可寻址,而 Mamba 把历史压缩进固定大小的状态,只能取回选择机制当时决定保留的内容。2026 年的次二次方研究在合成任务上展示了同一个上限:长度 2048 的奇偶和 S3 上 Mamba-2 不超过 0.352,而换一种门控的 xLSTM 达到 1.000。
和 xLSTM、Gated DeltaNet 对比,Mamba 还是最好的次二次方架构吗?
不是全面领先。在 2026 年的次二次方研究里,xLSTM 变体在 4 亿参数的代码预训练、计数和状态跟踪外推、小规模时间序列预测上都领先 Mamba-2,只是 Mamba-2 在 8000 万参数时把 CRPS 追回 0.005。决定结果的是层用哪种门,而不是 Mamba 这个名字。