
扩散语言模型和自回归的区别:并行解码的真实代价
8B 的掩码扩散语言模型已能在 MMLU 上打平同尺寸自回归模型、在 GSM8K 上领先,只用六分之一的 token,还解决了反转诅咒。解码速度、短提示条件生成和服务栈成熟度仍偏向自回归。
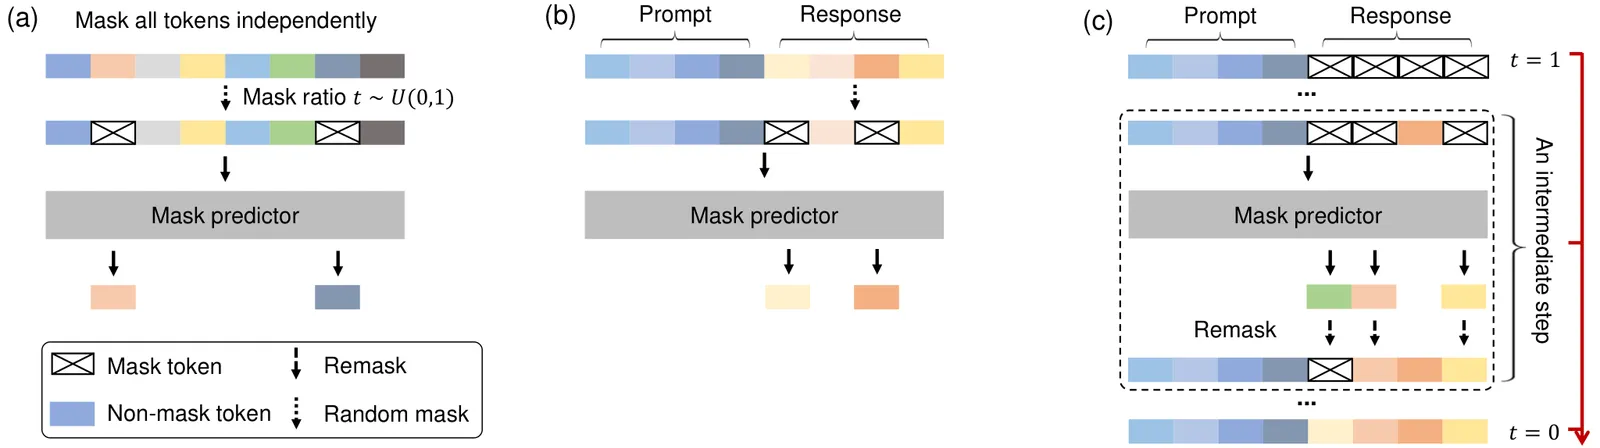
分解一个句子的两种方式
自回归模型把序列的联合概率写成下一个 token 条件概率的链,从左到右生成,每次前向出一个 token,缓存 key 和 value 让每步开销大致相同。Llama 3 是这套配方在大规模上的参照:一个 405B 稠密 Transformer,超过 15T token 训练,128K 上下文,外加 8B 和 70B 两个兄弟。
掩码扩散语言模型从不选方向。训练时按随机比例独立地掩掉序列中的每个 token,一个双向 Transformer 学习一次预测所有被掩的 token。生成从全掩码的画布开始,按固定步数反向运行这个过程:预测,保留有把握的 token,重新掩掉其余的,重复。SEDD 在 2023 年把分数匹配推广到离散数据,给这一家族一个有理论依据的损失,一年后的独立 复现研究 确认了它的困惑度和延迟结论;LLaDA 在 2025 年把它扩展到 8B 参数、2.3T token,第一次和同尺寸自回归模型公平交手。
两种分解意味着不同的失效模式。自回归按 token 付费,但每个 token 都以它之前的全部内容为条件。并行去掩按步付费,但在标准表述下同一步内的 token 是彼此独立预测的,这就是 FeF-DLLM 瞄准的因子分解误差。
关键数字
| 测量项 | 自回归 | 扩散语言模型 | 设置与出处 | 同一套评测? |
|---|---|---|---|---|
| GSM8K,8B 基座,4-shot | 53.1(LLaMA3 8B) | 70.7(LLaDA 8B) | LLaDA 论文 | 是 |
| MMLU,8B 基座,5-shot | 65.4 | 65.9 | LLaDA 论文 | 是 |
| 反转诗句补全 | 34.3(GPT-4o) | 42.4(LLaDA 8B Instruct) | LLaDA 论文 | 是,相同提示 |
| 达到该水平的预训练 token | 15T(LLaMA3) | 2.3T,0.13M H800 小时 | LLaDA 论文,各自报告的预算 | 否,不同实验室 |
| 指令微调后的聊天基准 | LLaMA3 8B Instruct 领先 | LLaDA 8B Instruct 小幅落后 | LLaDA 论文 | 是 |
| 相对此前扩散语言模型的困惑度 | 不适用 | 低 25% 到 75% | SEDD 论文 | 扩散家族内部 |
| 相对 GPT-2 的困惑度 | GPT-2 基线 | 有竞争力,胜过 GPT-2 | SEDD 论文,尺寸匹配 | 是 |
| 不用温度技巧的生成困惑度 | 未退火的 GPT-2 | 好 6 到 8 倍 | SEDD 论文 | 是 |
| 达到同等质量所需算力 | 1 倍网络评估次数 | 少 32 倍 | SEDD 论文 | 是 |
| 推理延迟 | GPT-2 基线 | 最多高效 4.5 倍 | SEDD 复现研究 | 是 |
| HellaSwag、ARC、WinoGrande | GPT-2 级 | 大致持平 | SEDD 复现研究 | 是 |
| 短提示下的条件生成 | 更强 | 略弱 | SEDD 复现研究 | 是 |
| 修复因子分解误差 | 不适用 | 平均 +5.04 分,3.86 倍提速 | FeF-DLLM,GSM8K / MATH / HumanEval / MBPP | 扩散家族内部 |
| MoE 每个解码块触及的专家数 | 逐 token 路由 | 块路由后 69.5 → 14.6,保留 99.11% 精度 | dMoE,LLaDA2.0-mini | 扩散家族内部 |
第一组行是唯一一次配方相同的 8B 正面对比,而且出自扩散一方自己的论文。SEDD 各行是 GPT-2 规模。最后两行是扩散解码器和自己比,放在这里是因为它们显示了工程投入的去向。
扩散赢在哪
方向是最干净的结构性优势。掩码是对称的,扩散语言模型没有内置的从左到右偏置,要求把序列倒着补全的任务在结构上不会更难。LLaDA 在反转诗句补全上 42.4% 对 GPT-4o 的 34.3% 是该引用的数字;基准很小,但这是自回归模型靠构造继承下来的弱点,一个质的能力差异。同一性质还免费带来填空,以及以任意位置 token 为条件的能力,SEDD 在 GPT-2 规模上展示过。
样本效率是意料之外的优势。LLaDA 用 2.3T token 达到 LLaMA3-8B 级别的 MMLU 和 17 分的 GSM8K 领先,而 LLaMA3 报告的是 15T。训练语料不同,把它当作提示性而非受控结果,但这和多数人对非自回归目标的预期正好相反。
并行是承诺中的优势,也是最没定论的。SEDD 用比自回归采样少 32 倍的网络评估次数达到相近质量,复现研究测得比 GPT-2 低至多 4.5 倍的延迟。在 8B 规模,LLaDA 自己的论文更谨慎:质量随步数取舍,也没有成熟的 KV 缓存对应物,调优过的自回归服务栈每 token 仍可能更便宜。
自回归仍然赢在哪
成熟度。多年的 RLHF、推测解码、分页 KV 缓存和量化都以从左到右生成为前提。LLaDA 8B Instruct 在若干聊天基准上落后于 LLaMA3 8B Instruct,论文把原因归于后训练配方更年轻,而不是目标函数。
条件生成。复现研究发现 SEDD 在短提示生成上略弱于 GPT-2,而这正是聊天的常见情形。
步内连贯性。标准扩散解码器独立预测同一步内的 token,所以 FeF-DLLM 的精确前缀条件分解在 GSM8K、MATH、HumanEval、MBPP 上平均多拿 5.04 分;它在去噪器内部用推测解码找回这种连贯性,相对顺序修复仍报告 3.86 倍提速。自回归默认就有这种连贯性。
稀疏模型的服务。扩散解码并行去掩一块 token,逐 token 的 MoE 路由让一块触及的专家远多于单个 token:LLaDA2.0-mini 上每块 69.5 个不同专家。dMoE 的块级路由把它降到 14.6,保留 99.11% 精度,提速 1.14 到 1.66 倍。自回归 MoE 从来没有这个问题。
怎么选
- 现在就上生产的聊天、智能体、代码助手: 自回归。工具链差距大于基准差距。
- 填空、编辑、两侧都有锚点的受限生成: 扩散语言模型。这是目标函数擅长的事,没有哪个自回归技巧能干净地复现。
- 答案顺序不该重要的推理任务,或反转式检索: 扩散语言模型值得一试,LLaDA 的 GSM8K 和反转结果是证据。
- 在意 token 多于在意服务成本的研究预算: 扩散语言模型。LLaDA 2.3T token 的结果是两列里最强的样本效率数据点。
- 部署稀疏扩散模型: 准备采用块级路由或等价方案,逐 token 路由会浪费 MoE 大部分的显存节省。
局限与存疑
唯一受控的 8B 对比在扩散一方的论文里,基线由作者自己训练。没有前沿规模的扩散语言模型被训练过,样本效率优势能否越过 8B 是未知数。延迟声明要么在 GPT-2 规模测量,要么以步数取舍的形式报告,没有在生产服务器上对着带推测解码的自回归栈量过每秒 token 数。而且这里的两篇来源是针对扩散解码特有问题的工程修复,这既是进展的迹象,也是栈不成熟的迹象。
常见问题
对比自回归语言模型,扩散语言模型更好吗?
不是全面更好。8B 规模上 LLaDA 在 MMLU 上打平 LLaMA3(65.9 对 65.4),在 GSM8K 上领先(70.7 对 53.1),训练 token 更少,但它的指令微调版在聊天基准上落后,解码栈也不成熟。
扩散 LLM 和自回归 LLM 对比,谁的解码更快?
取决于规模和设置。GPT-2 规模上 SEDD 用少 32 倍的网络评估次数达到相近质量,延迟最多低 4.5 倍。8B 规模上 LLaDA 的质量取决于去噪步数,又没有 KV 缓存的对应物,调优过的自回归服务每 token 仍可能更便宜。
扩散语言模型和自回归语言模型在生成文本的方式上有什么区别?
自回归模型从左到右一次预测一个 token,以前缀为条件。扩散语言模型从全掩码序列出发,每步并行去掩许多 token,没有固定方向,因此能填空和双向条件生成,但在步内引入因子分解误差。
为什么扩散 LLM 在反转诅咒上比自回归模型表现更好?
因为它们的训练目标在掩码下是对称的,不带从左到右的偏置。LLaDA 8B Instruct 在反转诗句补全上得 42.4%,GPT-4o 是 34.3%。