
Mistral 7B 对比 Llama 2:一个 7B 模型如何改写开源基线
Mistral 7B 以约一半参数在全部基准上击败 Llama 2 13B,靠 GQA、滑动窗口注意力和 Apache 2.0;Llama 2 提供 70B 档位和首份公开 RLHF 配方。
两句话版本
Mistral 7B 是 2023 年 9 月发布的 70 亿参数开源模型,采用 Apache 2.0 协议,参数量约为 Llama 2 13B 的一半,却在作者跑过的每一项基准上都赢了这个 13B 模型。早两个月发布的 Llama 2 是 Meta 的 7B/13B/70B 模型家族,它的贡献在另一条线上:第一次把完整的 RLHF 对话流水线写成公开文档,并附上可商用的权重。“小模型该是什么水平”的共识被这场对比重置过,但它被引用最多的数字背后藏着一个大多数转述都略去的评测口径问题。
关键数字
这场对比里最干净的一张表来自 Mistral 7B 论文的 Table 2:Mistral 团队用同一套评测流程跑了 Mistral 7B、Llama 2 7B、Llama 2 13B 和 Code Llama 7B。下表全部数字出自这一张表。
| 基准(shot 数) | Llama 2 7B | Llama 2 13B | Mistral 7B | 对 13B 的差值 |
|---|---|---|---|---|
| MMLU(5-shot) | 44.4 | 55.6 | 60.1 | +4.5 |
| HellaSwag(0-shot) | 77.1 | 80.7 | 81.3 | +0.6 |
| WinoGrande(0-shot) | 69.5 | 72.9 | 75.3 | +2.4 |
| PIQA(0-shot) | 77.9 | 80.8 | 83.0 | +2.2 |
| ARC-Easy(0-shot) | 68.7 | 75.2 | 80.0 | +4.8 |
| ARC-Challenge(0-shot) | 43.2 | 48.8 | 55.5 | +6.7 |
| NaturalQuestions(5-shot) | 24.7 | 29.0 | 28.8 | −0.2 |
| TriviaQA(5-shot) | 63.8 | 69.6 | 69.9 | +0.3 |
| HumanEval(0-shot) | 11.6 | 18.9 | 30.5 | +11.6 |
| MBPP(3-shot) | 26.1 | 35.4 | 47.5 | +12.1 |
| MATH(4-shot maj@4) | 3.9 | 6.0 | 13.1 | +7.1 |
| GSM8K(8-shot maj@8) | 16.0 | 34.3 | 52.2 | +17.9 |
这张表里真正解释问题的是三个规律。第一,差距大的地方恰好是推理密集的地方:GSM8K +17.9、MBPP +12.1、HumanEval +11.6、MATH +7.1。第二,在纯知识型任务上,7B 的容量天花板藏不住:Mistral 7B 在 NaturalQuestions 上反而输给 Llama 2 13B 0.2 分,TriviaQA 只领先 0.3。第三,常识和阅读类基准落在中间,个位数差距。Mistral 论文自己也这么划线:它估计模型在推理和理解上相当于 3 倍参数量的 Llama 2,但在知识上只有约 1.9 倍,因为知识存储受参数量硬约束,7B 就是比 13B 存得少。
为什么两篇论文给出的 Llama 2 分数不一样
拿上面的表去对 Meta 自己的 Llama 2 论文,会发现 Llama 2 那两列对不上:Meta 报告的 MMLU 5-shot 是 7B 45.3、13B 54.8;Mistral 重跑同一批模型得到 44.4 和 55.6。两个数都”真”。差异来自评测 harness:提示词格式、答案抽取、few-shot 采样方式,足以让小模型的分数上下浮动约一分。诚实的跨论文比较方法是:个位数以内的差距一律当噪声,且每张表只在自己 harness 内部用。
| 测量项 | Mistral 7B(Mistral harness) | Llama 2 70B(Meta 自己的论文) | 同口径? |
|---|---|---|---|
| MMLU(5-shot) | 60.1 | 68.9 | 否 |
| GSM8K(8-shot) | 52.2 | 56.8 | 否 |
| HumanEval(0-shot) | 30.5 | 29.9 | 否 |
| BIG-Bench Hard(3-shot) | 未报告 | 51.2 | n/a |
即使给 harness 误差留出余地,Llama 2 70B 仍是两者中原始能力更强的模型:两篇论文各自的表里它 MMLU 领先 Mistral 7B 8.8 分。Mistral 7B 的主张从来不是”最强开源模型”,而是”单位参数、单位成本最强”,在 7B 尺度上这个主张无可争议。
多出来的能力密度从哪来
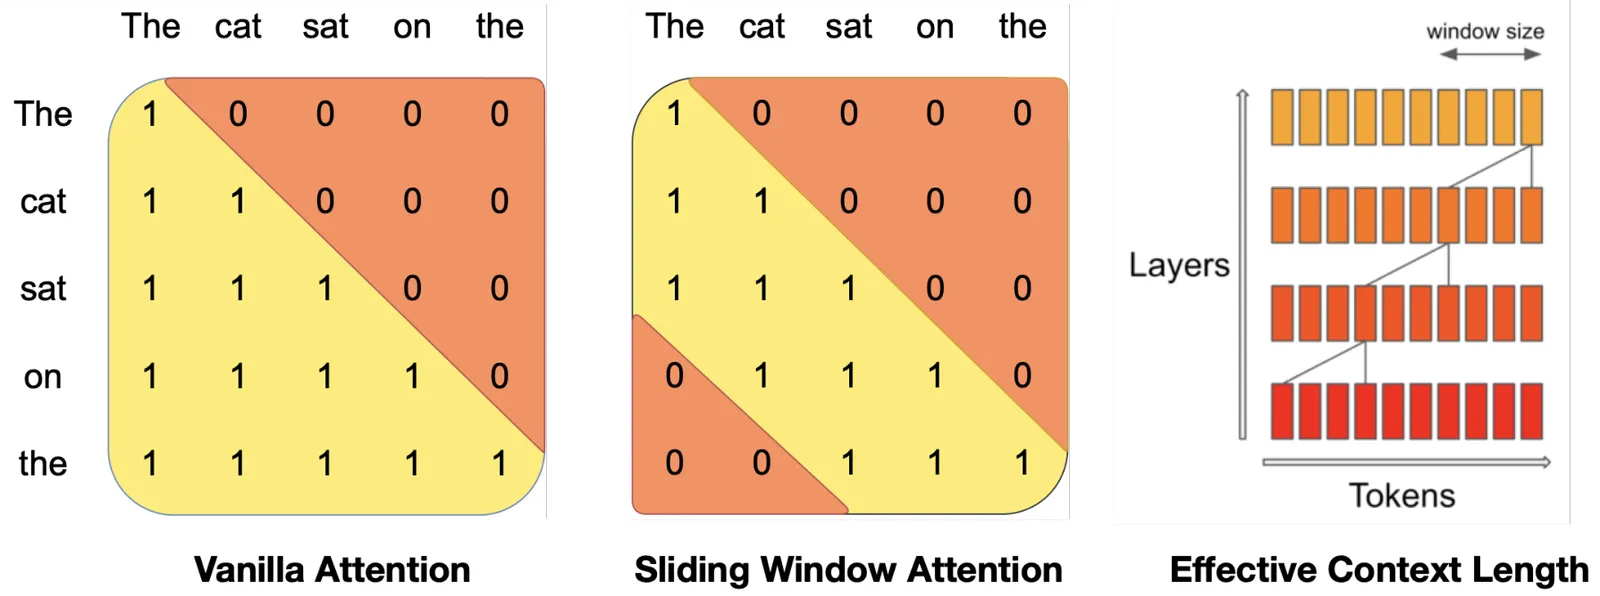
两个架构杠杆做了机械层面的工作,目标都是压低推理成本。分组查询注意力(GQA) 缩小 KV cache:Llama 2 7B/13B 给全部 32 个注意力头各配一对 K/V 头,而 Mistral 7B 是 32 个查询头共享 8 个 KV 头,每 4 个查询头共用一组。KV cache 越小,每生成一个 token 的显存带宽越小,吞吐越高,这正是真实部署的瓶颈。滑动窗口注意力(SWA) 限制每个 token 能看多远:窗口 4,096 token,但 32 层窗口逐层叠加,理论信息跨度约 13.1 万 token,滚动缓冲 cache 复用固定显存块,Mistral 报告 16K 序列长度下有 2 倍加速。标称上下文 8,192 token,是 Llama 2 4,096 的两倍。
但这里有个诚实的警告,也是大多数”Mistral 吊打 Llama”文章跳过的部分:训练数据未公开。Mistral 论文对预训练数据组成只字未提,指令微调版也只用了 Hugging Face 上的公开数据集、不含专有数据。因此无法把胜利干净地拆成”架构功劳”和”数据配比功劳”。NaturalQuestions 和 TriviaQA 两行就是证据:如果全靠架构,知识密集型任务不该对一个多 60 亿参数的模型走平。
Llama 2 有的、Mistral 7B 没有的东西
规模档位。 Llama 2 提供 7B、13B、70B 三个档位,70B 正面对决强于 Mistral 7B。如果任务要吃满这一代模型的能力上限,两者里只有 70B 可选。
一份写下来的对话配方。 Llama 2-Chat 的贡献是文档化,后来成了开源对齐的事实教材:几万条高质量 SFT 样本(Meta 的结论很直白:质胜量,收到约 2.7 万条就停手)、140 多万条内部人工偏好对比(含开源数据共 290 万条)、两套分开的奖励模型(一个管有用性、一个管安全性,因为混成一个会把两边都拖差),再加上拒绝采样与 PPO 的多轮迭代,以及让系统指令在多轮对话里不被遗忘的 Ghost Attention。你要搭自己的对齐流水线,Llama 2 的论文告诉你怎么做;Mistral 7B 的论文对后训练几乎什么都没说。
一个有条件的协议,和真正的自由。 Llama 2 社区协议允许月活 7 亿以下的商用,但禁止用它的输出去训练别的模型:是开放权重,不是开源。Mistral 7B 直接上 Apache 2.0:商用、再分发、微调,基本无附加条件。对产品团队来说,这个差别常常比任何基准都更决定性。
对话模型:MT-Bench 和一次网络投票
指令微调版的对比里,Mistral 7B Instruct 的 MT-Bench 得分是 6.84 ± 0.07,Llama 2 13B Chat 是 6.65,10 分制的评委打分上领先 0.19,是小幅优势,不是碾压。论文还报告了一次公开投票的对决:Mistral 的输出被偏好 5,020 次,Llama 2 13B Chat 是 4,143 次(截至 2023 年 10 月 6 日,共 9,163 票,约 54.8%)。第二个数字只能当方向性参考:它来自开放投票平台,不是受控的成对实验,两边输出生成的时点也不同。Meta 给 Llama 2-Chat 70B 对 ChatGPT 做的人工评测(36% 胜、31.5% 平)同样是厂商自评,且口径与 Mistral 的不可直接互换。
怎么选
- 7B 到 13B 尺度的基座模型,用于微调或端侧部署: Mistral 7B,所有维度都占优:同口径分数更高、参数减半、8 个 KV 头对 32 个、8K 上下文带 13.1 万理论跨度、Apache 2.0。
- 这一代模型的能力上限,成本其次: Llama 2 70B。Mistral 7B 论文没有任何地方否认 70B 更强。
- 在搭对齐流水线、想要一份可参考的公开文档: Llama 2 的 RLHF 章节(双奖励模型、拒绝采样加 PPO、Ghost Attention)仍然是更好的教材。
- 商用产品、协议摩擦敏感: Mistral 7B 的 Apache 2.0 完全绕开 Llama 2 的 7 亿月活条款和输出限制条款。
- 2026 年的新部署: 两个都别选,它们都是前辈;这条线的直接后继是站上的 Llama 3。这场对比的价值在于解释为什么当代开源模型默认把 GQA 和宽松协议配对;选当代模型,然后用本页这套评测纪律去验。
局限与存疑
这场对比有种表格修不了的非对称:Meta 披露了训练规模(2 万亿 token)和流水线细节,但数据配比同样没公开;Mistral 数据和训练规模都没披露。所以”胜利归因”在本质上是悬而未决的。对话模型的三组数字来自三种评法(评委打分的 MT-Bench、开放投票、厂商自评的人工评测),不应混排成一张榜。滑动窗口注意力的长上下文召回,也就是超出 8,192 标称上下文之外的部分,是理论跨度主张,不是实测检索结果。而且这里所有数字都停在 2023 年底,开源权重基线此后已经换过好几轮:把本页当谱系和评测方法学来读,别当今日选型指南。
常见问题
Mistral 7B 比 Llama 2 强吗?
同等或更小尺度上,是的,可测量。在 Mistral 论文自己的 harness 里,Mistral 7B 在全部 12 项报告基准上击败 Llama 2 13B,数学和代码差距最大(GSM8K +17.9、MBPP +12.1、HumanEval +11.6)。对上 Llama 2 70B 则不然:两篇论文各自的表里 70B 的 MMLU 领先 8.8 分,尽管口径不同。
为什么 Mistral 7B 参数更少反而更强?
一部分是架构(分组查询注意力让 KV 头从 32 减到 8,滑动窗口注意力让长序列更便宜;这些降低的是推理成本,不直接让模型更聪明),另一部分是没公开的训练配方。论文自己的分析给主张划了界:推理和理解上 Mistral 7B 相当于 3 倍以上参数的 Llama 2,知识上只有约 1.9 倍;而知识基准上它打平甚至输给 13B,这正是”数据与配方收益叠在容量受限的模型上”的特征。
Mistral 7B 和 Llama 2 的协议差别是什么?
Mistral 7B 是 Apache 2.0:商用、再分发、微调,基本无限制。Llama 2 是 Meta 社区协议:月活 7 亿以下可商用,但禁止用 Llama 2 的输出去改进其他模型。实务上 Apache 2.0 是法务默认可过的;Llama 2 协议则需要一次明确的产品决策。
Mistral 7B Instruct 和 Llama 2 13B Chat 哪个对话更好?
MT-Bench 上 Mistral 7B Instruct 6.84 ± 0.07 对 Llama 2 13B Chat 的 6.65;Mistral 论文的公开投票是 5,020 比 4,143。两组数字都是厂商自报、口径不同,读作”大致同级、Mistral 略优”可以,别读成精确排名。
滑动窗口注意力意味着 Mistral 7B 有 13 万 token 上下文吗?
不。标称上下文是 8,192 token。约 13.1 万是 4,096 窗口在 32 层叠加后的理论信息跨度估计,说的是信息最多能传多远,不是在那么远的距离上实测过召回质量。8K 当可用上下文,更大的数字只是成本模型的推导值。