
DeepSeek V4 架构解读:CSA、HCA、mHC 与 Muon
DeepSeek V4 保留 V3 的 MoE,把注意力改为先压缩再稀疏,在双随机约束下加宽残差流,用 Muon 训练大多数矩阵;1M 下 KV 缓存只有 V3.2 的 10%。
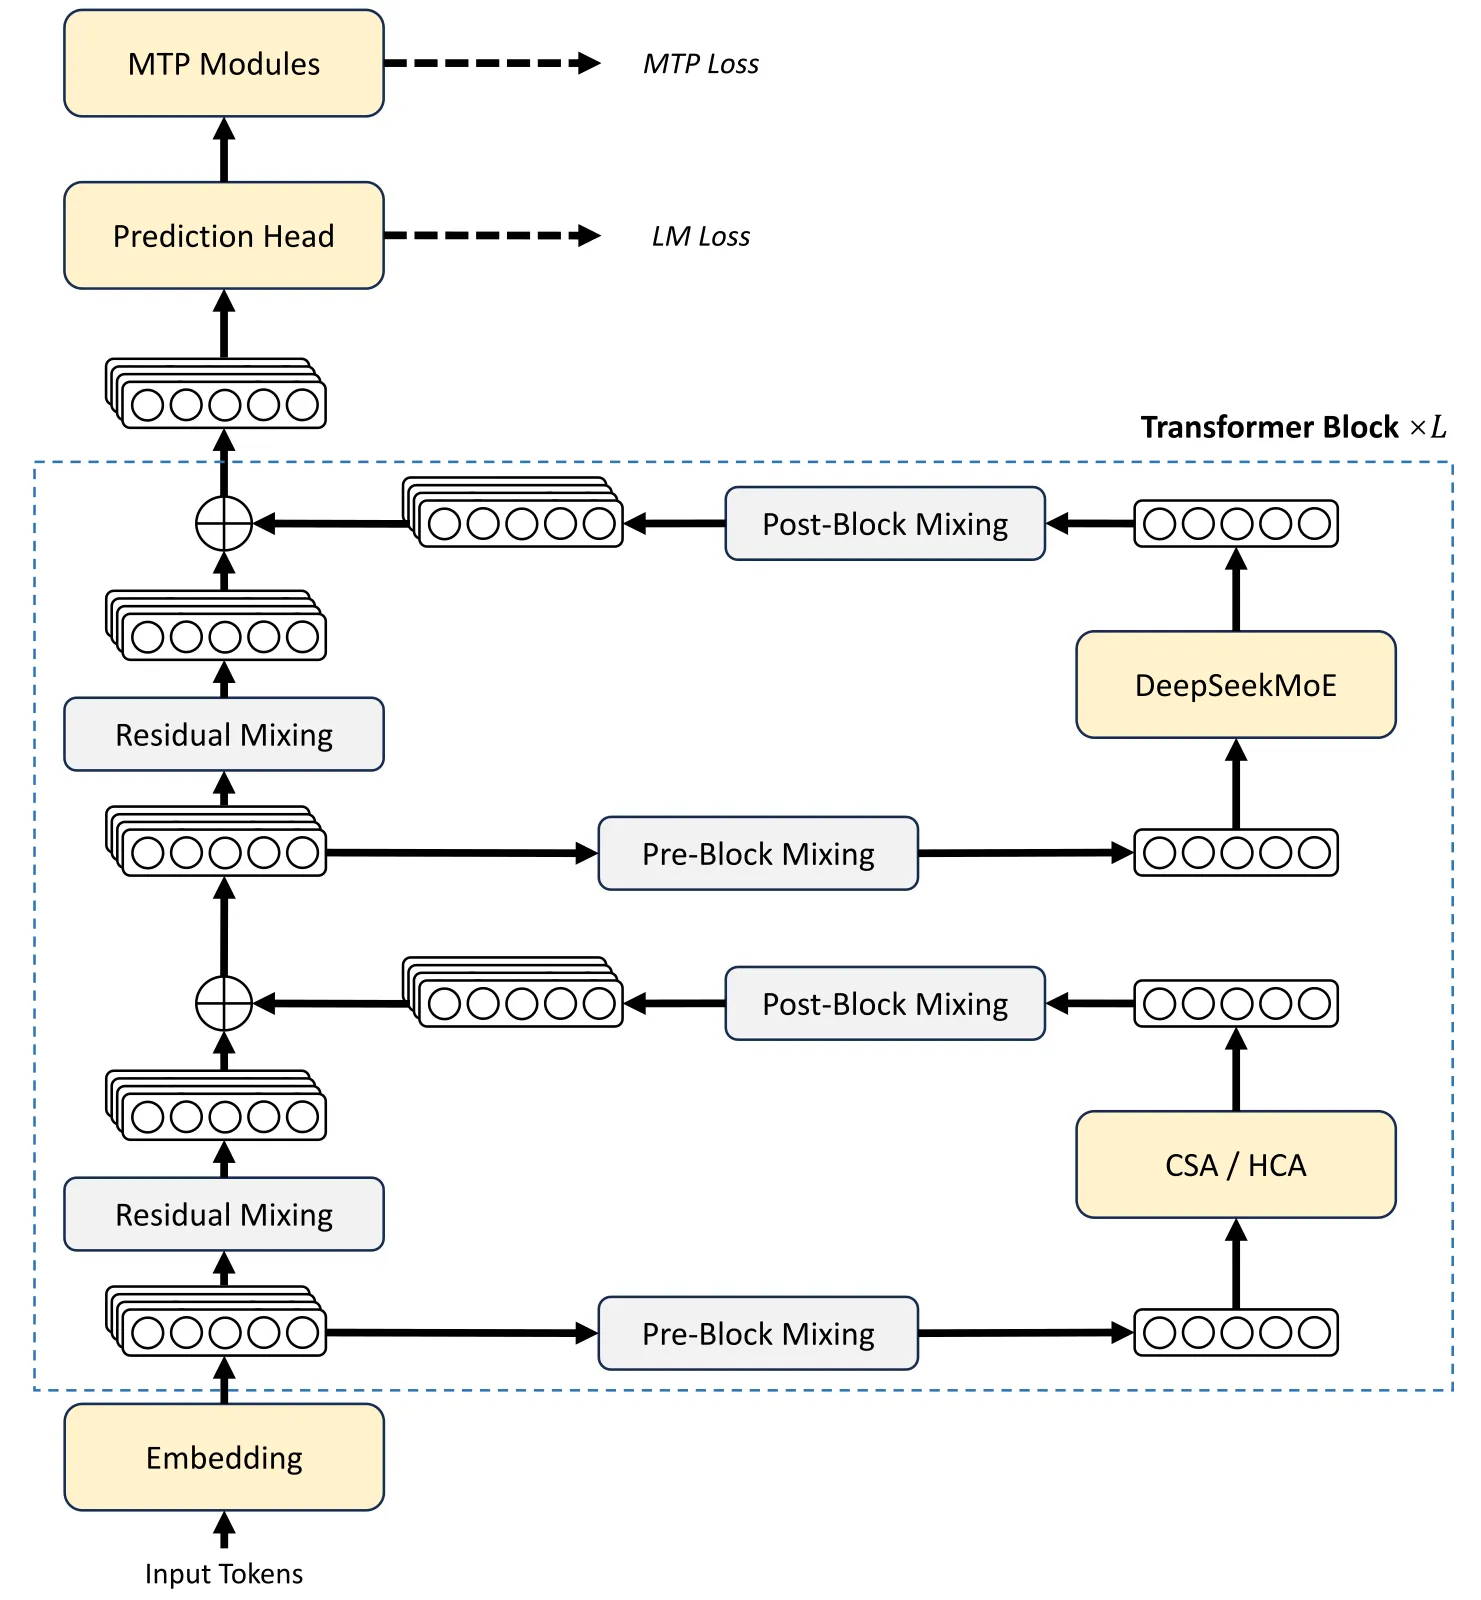
架构一览
先看没变的部分。DeepSeek-V3 贡献了 DeepSeekMoE 前馈设计,细粒度路由专家加共享专家、无辅助损失的负载均衡,以及既作训练目标又作推测解码草稿的多 token 预测。V4 继承了这一切,连同 128K 词表、token 切分和中间填充的数据策略,以及 FP8 式低精度训练的立场,如今路由专家权重进一步用 FP4。两个尺寸发布:V4-Pro 总参数 1.6T、激活 49B,V4-Flash 总参数 284B、激活 13B。V3.2 激活 37B。
新的有三样。注意力层在两种设计之间交替,压缩稀疏注意力和重度压缩注意力,都为让一百万 token 上下文变便宜而造。残差连接变成流形约束超连接,一条加宽后在深层堆叠下仍稳定的残差流。大多数权重矩阵的优化器由 AdamW 换成 Muon。技术报告 把这些列为 V4 能常规运行 1M token 上下文的原因。
关键数字
| 组件 | V3 / V3.2 | V4 | 出处 | 同一套评测? |
|---|---|---|---|---|
| 总参数 / 激活参数 | V3.2:激活 37B | Pro 1.6T / 49B;Flash 284B / 13B | V4 报告 | 不适用 |
| 预训练 token | V3:14.8T | Flash 32T,Pro 33T | 各报告 | 不适用 |
| 注意力 | MLA,V3.2 加 DSA 稀疏选择 | CSA(每 m 个 token 压成一个条目,再 DSA top-k)与 HCA(更大的组)交替,各带滑动窗口和注意力 sink | V4 报告 2.3 节 | 不适用 |
| 1M 上下文下单 token 推理 FLOPs | 1 倍(V3.2) | Pro 27%,Flash 10% | V4 图 1,FP8 等效估计 | 是 |
| 1M 上下文下 KV 缓存 | 1 倍(V3.2) | Pro 10%,Flash 7% | V4 图 1 | 是 |
| KV 存储精度 | FP8 潜变量(V3.2) | RoPE 维度 BF16,其余 FP8 | V4 报告 | 不适用 |
| 残差流 | 标准 pre-norm 残差 | mHC:加宽的流,残差混合经 Sinkhorn-Knopp 投影到双随机矩阵 | V4 报告 2.2 节 | 不适用 |
| 优化器 | AdamW | 大多数矩阵用 Muon;嵌入、输出头、mHC 静态偏置与门、RMSNorm 用 AdamW | V4 报告 2.4 节 | 不适用 |
| 原生上下文 | 128K | 1M | 各报告 | 不适用 |
| MRCR 1M / CorpusQA 1M | 不适用 | 83.5 / 62.0(Opus-4.6:92.9 / 71.7) | V4 表 6 | 是,DeepSeek 评测框架 |
| GPQA Diamond,Non-Think / High / Max | 不适用 | Pro 72.9 / 89.1 / 90.1;Flash 71.2 / 87.4 / 88.1 | V4 表 7 | 是 |
| Max 强度下 SWE Verified | 不适用 | Pro 80.6;Flash 79.0 | V4 表 7 | 是 |
效率行是报告自己图里的估计值,不是实测延迟;精度行用 DeepSeek 的评测框架,500 步交互、512K 上下文。
先压缩再稀疏的注意力怎么工作
CSA 顺序做两次缩减。第一步压缩:每 m 个连续 token 的 key 和 value 用可训练的压缩权重、组内 softmax 和可学习的位置偏置折叠成一个 KV 条目。key 路径和 value 路径的索引有重叠,所以注意力看到的序列长度按组大小缩短。第二步稀疏:在压缩后的条目上运行 V3.2 引入的 DeepSeek 稀疏注意力。一个 Lightning Indexer 构造低秩的索引查询和压缩后的索引 key,打分后每个查询只关注它的前 k 个压缩条目。两个细节保住局部保真:一小段未压缩近期 token 的滑动窗口分支,以及一个让某个头的注意力得分之和可以小于 1、从而实质上可以什么都不关注的注意力 sink 项。
HCA 是同一思路,每个条目的组大得多,没有稀疏选择阶段,同样带滑动窗口和共享 KV 的多查询布局。CSA 与 HCA 层交错就产生了 10% KV 这个数字:CSA 层按压缩比削减缓存、按 top-k 削减计算,HCA 层进一步削减缓存。
与 MiniMax 稀疏注意力 的对照很有启发。MSA 保留全分辨率的 128 token KV 块,每个查询选 16 块,固定 2048 token 预算,所以 KV 缓存不变,省的是计算。V4 在选择之前先缩小缓存本身,这就是它以 KV 数字为头条的原因。代价是组内保真:一个压缩条目在查询时无法再拆开。在 V4 骨干上开发的 FlashMemory 式 前瞻卸载 则从又一个角度处理剩余缓存,预测哪些条目该常驻。
为什么要 mHC,为什么用 Muon
超连接把残差流加宽若干倍,让每一层通过学习到的映射读写这条更宽的流。朴素版本堆叠后数值不稳,所以 V4 用 Sinkhorn-Knopp 归一化把残差混合矩阵约束到双随机矩阵构成的 Birkhoff 多面体上。双随机矩阵谱范数不超过 1 且对乘法封闭,所以深层堆叠的残差混合在两个方向上都非扩张。输入和输出映射用 sigmoid 限界。报告把这当作超连接在 1.6T 规模可用的关键。
Muon 在大多数模块上取代 AdamW。DeepSeek 给出的理由是更快收敛和更稳的训练,加入了混合 Newton-Schulz 日程和防止注意力 logit 爆炸的措施,并在 Muon 不适用的地方保留 AdamW:嵌入、预测头、mHC 的静态偏置和门、RMSNorm 权重。这是公开的最大规模 Muon 预训练,Kimi K3 和 Qwen3.8-Next 随后以逐头和排除路由器的变体跟进。
局限与存疑
压缩组大小和 top-k 写在开源的推理代码里,论文正文没有完整给出。效率以 FP8 等效 FLOPs 和缓存字节报告,FP4 专家权重在现有硬件上还不比 FP8 快。1M 长上下文精度在 MRCR 和 CorpusQA 上落后 Claude Opus 4.6 九到十分,所以这套架构在那个长度上买到的是成本,不是持平。V4 规模上没有把 CSA 与 HCA、mHC 与普通残差、Muon 与 AdamW 分别隔离的消融;报告描述的是设计和结果,不是反事实。
常见问题
DeepSeek V4 的架构是什么?
继承自 V3 的 DeepSeekMoE 模型,注意力重建为交替的压缩稀疏注意力(把成组 token 压成单个 KV 条目,再经 Lightning Indexer 稀疏关注 top-k)和重度压缩注意力(组大得多),残差换成流形约束超连接,主优化器为 Muon。Pro 总参数 1.6T、激活 49B;Flash 284B、13B。
DeepSeek V4 的架构和 V3 有什么不同?
V3 用 MLA 注意力、128K 上下文和 AdamW。V4 保留 MoE 和多 token 预测,新增先压缩再稀疏的注意力以原生支持 1M 上下文、保证深度稳定的 mHC 残差、FP4 路由专家,以及大多数矩阵用 Muon。1M token 下 V4-Pro 只需 V3.2 的 27% FLOPs 和 10% KV 缓存。
DeepSeek V4 的压缩稀疏注意力和 MiniMax 稀疏注意力对比如何?
MSA 每个查询选 16 个全分辨率的 128 token 块,KV 缓存不变,省的是计算。V4 的 CSA 在稀疏选择之前先把成组 token 压成单个条目,缩小的是缓存本身,HCA 层再进一步压缩;所以 V4 的头条是 10% KV 缓存而不是 FLOPs 倍数。
DeepSeek V4 哪些部分用 Muon 训练,哪些用 AdamW?
大多数权重矩阵用带混合 Newton-Schulz 日程的 Muon。嵌入、预测头、mHC 模块的静态偏置与门、RMSNorm 权重留在 AdamW 上。