
Qwen-Image 2.0 对比 Flash 版:质量还是速度
Qwen-Image 2.0 是全能图像底座:1K token 指令、原生 2K、16 倍 VAE。Flash 把它蒸到 4 步,靠数据配方在自家评测里追平老师。
两个模型到底是什么关系
它们不是竞争关系。Qwen-Image 2.0 是底座系统,Qwen-Image-Flash 是它的少步蒸馏版。Flash 的全部能力都来自把 2.0 的多步采样轨迹压成 4 次函数评估,所以真正的问题只有一个:压缩之后失去了什么,蒸馏配方又把什么买了回来。
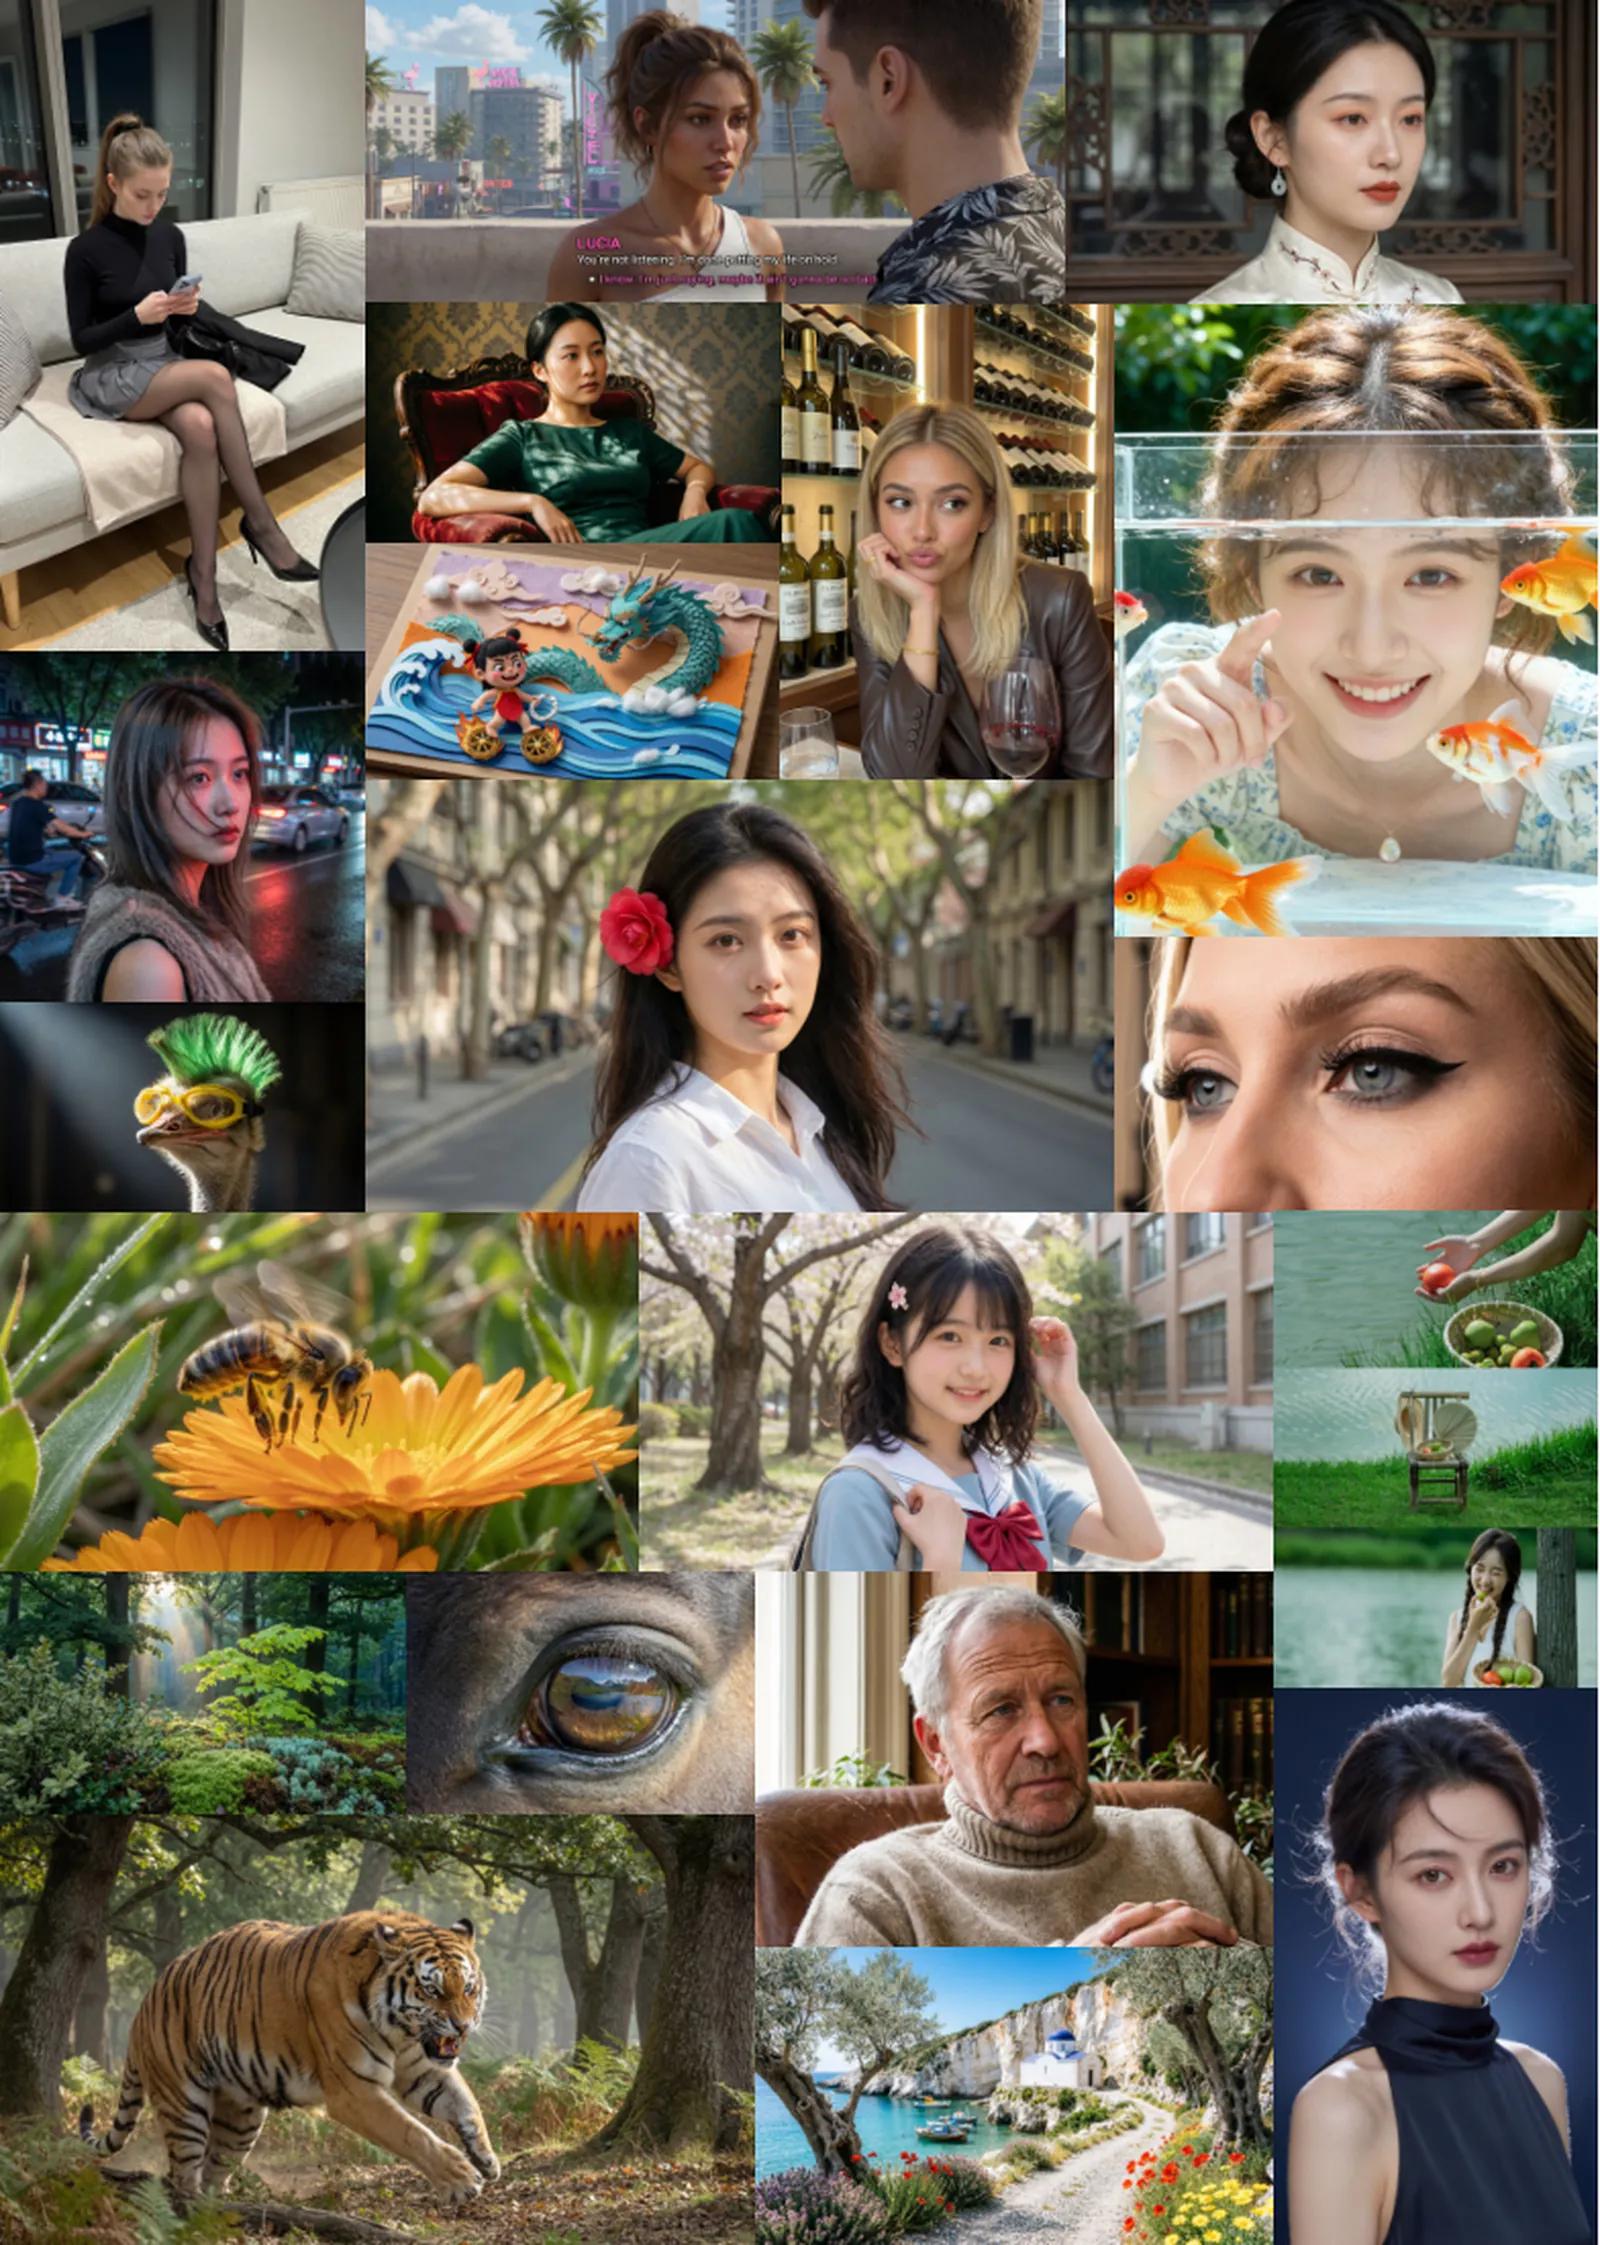
Qwen-Image 2.0 是一个多模态扩散 Transformer,文生图和指令编辑在同一个模型里完成,条件编码用 Qwen3-VL。它主打能力上限而不是速度:能跟随最长 1K token 的指令去排版幻灯片、海报、信息图和漫画;原生支持最高 2K 分辨率出图;还用了一个 16 倍空间压缩的 VAE(f16c64),而非常见的 8 倍(f8c16)。序列长度再砍一半,原生高分辨率训练才变得可行。
开源图像生成追求可控性和保真度不是第一次。ControlNet 示范了如何给冻结的扩散模型加条件控制,Stable Diffusion 3 则用整流流探索了另一条 backbone 路线。Qwen-Image 2.0 的赌注是把生成和编辑装进同一个 Transformer,并正面解决商业场景里最常翻车的三件事:长文字、多语言排版、2K 写实。
Qwen-Image-Flash 是给部署准备的答案。它用流匹配 backbone 上的分布匹配蒸馏(DMD)从 2.0 蒸到 4 NFE,文生图和编辑仍然共用一个学生模型。这篇论文真正的贡献不在蒸馏目标本身,DMD 是标准做法,而在目标之外的三条配方发现。这些发现会改变你对任何少步图像模型的预期。
关键数字
| 测量项 | Qwen-Image 2.0 | Qwen-Image-Flash | 设置与出处 | 同一口径? |
|---|---|---|---|---|
| 采样步数 | 多步采样(老师为”80 NFE 量级”区间) | 4 NFE | Flash 论文,文生图 + 编辑 | 是,同一模型血统 |
| 单模型做生成 + 编辑 | 是 | 是(联合蒸馏) | 两篇论文皆是 | 是 |
| T2I-Bench,纯人像 2 万张蒸馏集 | 未蒸馏 | GPT 5.5 均分 4.15,排名第 1 | 1800 条 T2I-Bench,Gemini 3.1 Pro + GPT 5.5 双裁判 | 是,Flash 变体之间 |
| T2I-Bench,混合类目 6 万张蒸馏集 | 未蒸馏 | GPT 5.5 均分 3.62,排名第 4 | 同榜,数据更多更杂反而更差 | 是,Flash 变体之间 |
| Editing-Bench,生成:编辑 = 5:5 | 未蒸馏 | Gemini 3.1 Pro 2.97 / GPT 5.5 3.41,排名第 1 | Flash 任务配比消融 | 是,Flash 变体之间 |
| Editing-Bench,生成:编辑 = 7:3 | 未蒸馏 | Gemini 2.87 / GPT 3.36 | 同一组消融 | 是,Flash 变体之间 |
| 加入编辑数据后的文生图得分 | 2.77 / 3.28(纯文生图学生) | 2.97 / 3.41(联合学生) | Gemini / GPT 裁判,同预算同学生 | 是,成对消融 |
| 指令长度 | 最长 1K token | 继承 2.0 能力 | 2.0 报告 | n/a |
| 原生分辨率 | 最高 2K(2048p) | 继承 2.0 backbone | 2.0 报告 | n/a |
| VAE | f16c64,16 倍空间压缩对 f8c16 的 8 倍 | 与老师同 VAE | 2.0 报告,ImageNet-1k 256x256 + 富文本语料 | n/a |
| 核心证据 | 人工评测:生成和编辑都大幅超过上一代 Qwen-Image;16 倍压缩下 PSNR/SSIM 居对比 tokenizer 之首 | 内部偏好榜上对老师模型及自身消融的对照 | 各自协议 | 无外部正面对比 |
诚实地读这张表,能看到一个不对称:2.0 的数字是能力声明,主要靠和自家前代模型比的人工评测支撑;Flash 的数字是同一套评测、同一批裁判下的受控消融。所以 Flash 的”追平甚至超过老师”在自己的协议内证据扎实,而 2.0 的”大幅超越”拿去和 FLUX 或商业模型比时,尺寸就不好估了。
Flash 论文真正证明了什么
三条发现不局限于这一对模型,哪怕你永远不部署它们,这篇论文也值得读。
数据多样性可能帮倒忙。 T2I-Bench 上,用 2 万张纯人像图蒸馏的学生总分第一(GPT 5.5 均分 4.15),而数据量大三倍的 6 万张混合类目集合只排第四(3.62)。更糟的是,混合集合连文本类提示都输给了类目单一的数据集。预训练里”数据越杂越好”的直觉,在蒸馏学生上主动帮了倒忙。
老师要逐步混用,不能整个换掉。 直接拿一个某任务更强的专科老师来指导蒸馏,训练会失稳,哪怕那个老师单独用更强。可行的配方是把预训练底座老师当作稳定的分布锚点,只在采样轨迹的特定阶段折入专科老师的引导。代价轻微:第一步锚定换来稳定,代价是学生吸收的专科分布略少。
编辑和生成不是零和。 预算固定时,纯文生图学生会不可恢复地丢掉编辑能力;但反过来不成立:加入编辑监督把文生图均分从 2.77 抬到 2.97(Gemini 裁判)、3.28 抬到 3.41(GPT 裁判),超过了纯文生图学生。5:5 的平衡配比在 Editing-Bench 上排名第一,胜过 7:3。必须二选一的话,对称赢。
局限与存疑
Qwen-Image 2.0 的报告自己点破了软肋:超长文字渲染”仍然脆弱”,字符数一多准确率就掉,拉丁和中文之外的文字系统在正确字形、间距和阅读顺序上都吃力;“生成与编辑统一”被承认为”一个开放问题”。它的核心证据是人工评测,不是和外部系统正面对抗的自动化榜单,参数规模和完整定量表也不在摘要里,要和别的模型认真对比,得直接翻 PDF 里的表格。
Qwen-Image-Flash 继承了文字渲染的天花板,还添了两条自己的:小而密的文字、密集海报式构图仍然难;部分文生图输出带轻微残余噪点,在干净背景上最明显,因为 4 步采样没把去噪轨迹走完。它的分数来自偏好型 VLM 裁判(Gemini 3.1 Pro、GPT 5.5)在内部榜单上的打分,不是第三方 leaderboard,跨论文可比性有限;单一类目数据这条发现能否推广到 Qwen-Image 2.0 之外,也未经验证。
怎么选
输出本身就是产品的时候跑 Qwen-Image 2.0:给客户看的海报、幻灯片、漫画,密集排版的文字图,2K 写实渲染,以及一次失败就很贵的编辑。多步采样是这个上限的代价,而 16 倍 VAE 压缩是让高分辨率区间整体可负担的前提。
延迟本身就是产品的时候跑 Qwen-Image-Flash:对话式界面、批量生成、用户每点一次都在等的迭代创作工具。4 步学生保住了文生图加编辑的统一能力,消融实验证明扛住质量的是配方而不是运气。给它的失效模式留好余地:文字密集的海报类任务路由回老师模型,干净背景上的残余噪点准备好善后。
常见问题
Qwen-Image 2.0 和 Qwen-Image-Flash 有什么区别?
Qwen-Image 2.0 是满血模型:多步扩散采样、最长 1K token 指令、原生 2K 输出、16 倍压缩 VAE,一个 Transformer 同时做生成和编辑。Qwen-Image-Flash 是同血统用分布匹配蒸馏压到 4 步采样的版本,文生图和编辑仍共用一个学生模型,面向低延迟部署。
Qwen-Image-Flash 的质量比 Qwen-Image 2.0 差吗?
不全面差。在团队内部偏好榜上,这个 4 步学生的均分追平甚至超过了多步采样的老师;加入编辑数据还把文生图得分从 2.77 抬到 2.97(Gemini 3.1 Pro 裁判)。它确实保留了已知的短板:小而密的文字难渲染,部分输出在干净背景上有轻微残余噪点,因为 4 步采样没能完全走完去噪轨迹。
Qwen-Image 2.0 需要多少步采样?
摘要里没有钉死一个数字,它是多步区间,Flash 论文把老师描述为”80 NFE 量级”的采样。Flash 之所以存在,正因为这个区间对交互场景太慢,才把它压到 4 次函数评估。
Qwen-Image 2.0 为什么用 16 倍 VAE?
16 倍空间压缩(f16c64)在常见的 8 倍(f8c16)基础上把空间 token 序列再砍一半,原生 2K 的训练和生成才变得可行。代价是保真度和可扩散性之间的权衡更尖锐,论文用残差自编码和语义对齐损失来缓解;报告称在 16 倍压缩下,PSNR 和 SSIM 居对比 tokenizer 之首。
Qwen-Image-Flash 能在图里渲染长文字吗?
它继承了 2.0 的能力上限,所以 1K token 指令原则上仍可用,但两篇论文都把文字渲染标为最脆弱的轴:字符数一多准确率就掉,小而密的排版对 Flash 学生尤其难,英文和中文之外的文字系统在正确字形、间距、阅读顺序上都吃力。
一句话:同一个模型的两个工作点。2.0 用多步采样买能力上限;Flash 用 4 步买延迟,而且在自家榜单上几乎没有还账。原文见 Qwen-Image 2.0 与 Qwen-Image-Flash。