
向量检索对比智能体检索:什么时候 grep 反而赢
向量检索把语料压成每段一个相似度分数,代价是什么?站上五篇论文从接口、读者、引用、配置、评测五个层面给出各自的修复方案,数字和边界都在这。
所有 RAG 系统都答不好的那个问题
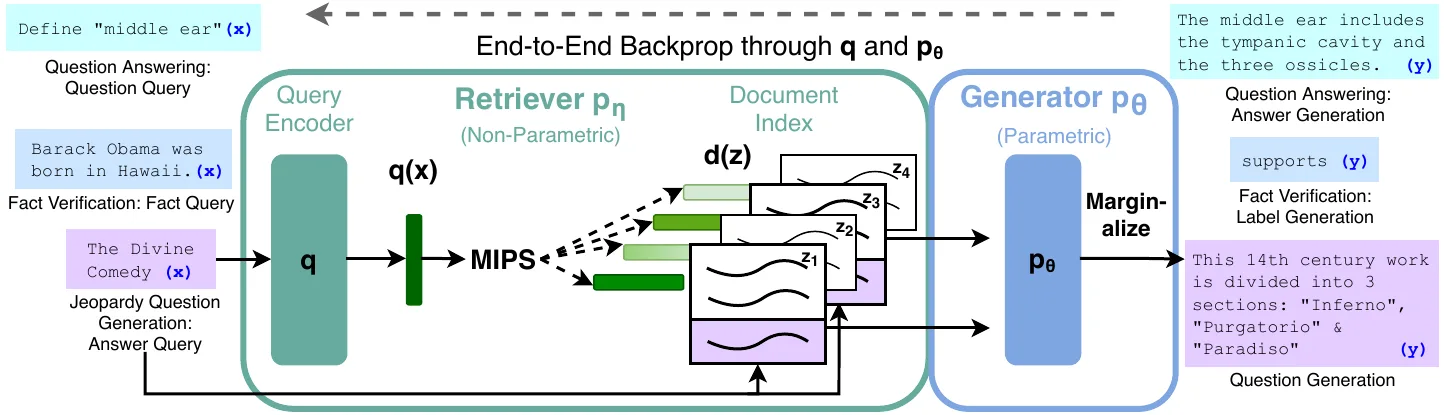
从 2020 年的 RAG 论文开始,“模型怎么拿到对的证据”这个问题的默认答案就没变过:把语料 embedding 化,把查询 embedding 化,返回 top-K 段落。这套配方赢在它简单、快、对一次性开放域问答足够好。但之后每一篇相关工作都在从不同的角度攻击同一个弱点,站上收录的这几篇放在一起读,就是一份分工明确的批评意见书。
批评的起点是一个朴素的观察:相似度分数是一种压缩。检索器把排好序的整段文档交给智能体时,它在任何推理发生之前就已经决定了什么重要,而且分辨率只有”整篇文档”这一档。精确的词汇约束丢了,多条弱线索的合取表达不出来,被 top-K 过滤掉的证据无论下游模型多强都再也找不回来。站上这五篇论文各自修了这条管线上的一层:接口、读者、引用、配置、评测。没有一篇说向量检索已死,它们说的是:向量索引不该是管线的终点。
向量检索到底压掉了什么
对分辨率问题最清晰的陈述是 DCI(Direct Corpus Interaction)。作者做了一个受控替换:同样的 Claude Sonnet 4.6 底座、同样的任务,但把 Qwen3-Embedding-8B 检索工具换成一个终端,让智能体直接用 grep、find 和文件读取去翻原始语料。BrowseComp-Plus 的准确率从 69.0% 升到 80.0%,涨了 11 分,评测成本反而从 1,440 美元降到 1,016 美元,降了 29.4%。关键在消融实验:DCI 经常不是在检索智能体已经捞出全部金标证据的情况下仍要赢,而是赢在把粗粒度证据转成了细粒度验证:两条 grep 用管道串起来就是合取,对关键词 grep 再读上下文几行就是局部核查。top-K 列表两者都做不到。
2020 年的 RAG 论文本身就埋下了这颗批判的种子。它的检索器从 2,100 万个维基百科块里返回固定的 top-K(大约 5 到 10 段),DPR 一旦漏掉相关段落,BART-large 生成器就无据可依。论文自己的框架是把检索当作边缘化的隐变量、端到端联合训练,而现代生产环境的 RAG 悄悄把训练信号扔掉了,留下来的只有接口:top-K 进、prompt 出。DCI 攻击的正是这个接口。
关键数字
| 路线 | 论文 | 代表数字 | 擅长 | 崩在哪 |
|---|---|---|---|---|
| 稠密检索器加 seq2seq 生成器 | RAG (2020) | 在 2,100 万维基块上取 top-K 5 到 10;生成器 BART-large 约 4 亿参数;发表时在 NQ、TriviaQA、WebQuestions 上达 SOTA | 一次性开放域问答;换索引即换知识,无需重训 | 检索漏了不可恢复;固定 top-K 封顶召回 |
| 智能体直接 grep 原始语料 | DCI | 同一 Sonnet 4.6 底座下 BrowseComp-Plus 69.0% 升到 80.0%(+11.0),成本降 29.4%(1,440 到 1,016 美元);多跳问答平均 83.0(+30.7);NDCG@10 平均 68.5(+21.5) | 弱线索合取、精确词面核查、局部验证 | 40 万文档时准确率 37.5%,每问 122.4 次工具调用 |
| 只读上下文的小模型 | OCC-RAG | 0.6B 和 1.7B 参数,用 300 万以上合成 QA 样本训练;在五个 grounding 问答基准上打平或超过自身 2 到 6 倍大的通用模型 | 低成本忠实作答,引用精确到原文引文,且学会拒答 | 拿不到检索上下文就几乎没有可推理的内容 |
| 引用一起打分的文档问答 | CiteVQA | 711 份 PDF、平均 40.6 页上的 1,897 道题;严格归因准确率 Gemini-3.1-Pro 76.0,最强开源模型 22.5 | 抓住”答案对、引用错”的失败,覆盖 20 个 MLLM | 是基准不是方法,没有给出修复模型 |
| 按 chunk 配检索配置 | CARVE | Recall@5 0.603 对 8 个基线中最强的 0.510;用 Qwen3-VL-8B 生成通过率 0.357 对 0.315;胜过训练过的路由器 0.329 和 0.310 | 长视频 RAG:检索格式是 chunk 的属性而非查询的 | 每次查询要跑四个检索器加一个 2B reranker;绝对分数仍低 |
五层管线,五个补丁
这张表容易让人误以为这些论文在互相竞争,其实它们是同一个问题的不同失效模式各自的答案,真正的教训是把它们叠起来用。
**接口层。**DCI 干脆拿掉检索器,让够强的智能体像研究员一样搜索。适用范围论文写得很白:10 万文档时每问 38.5 次工具调用,20 万涨到 86.9,准确率掉 13.6 分;40 万文档时准确率崩到 37.5%,每问 122.4 次调用,20 个样本直接超预算。DCI 在搜索深度上扩展得好,在广度上扩展得差,所以作者自己把大而静的语料指回稠密和稀疏检索,DCI 属于本地、常变、由智能体掌控的工作区。
读者层。OCC-RAG 把检索器当作给定前提,问了一个不同的问题:阅读模型到底该为什么优化?它的回答是:在 grounding 系统里,花在背世界上的参数大多是浪费,有时还有害,因为记忆会诱惑模型脱离段落凭印象作答。于是它用 300 多万个为两个行为专门合成的样本训练 0.6B 和 1.7B 模型:忠于给定上下文,以及在上下文撑不起答案时拒答。回报是 1.7B 模型在 HotpotQA、MuSiQue、TAT-QA、ConFiQA、MuSiQue-Un 上打平或超过自身 2 到 6 倍大的通用模型,推理过程里逐字引用原文作为证据。拒答这个能力正是大多数生产 RAG 缺的那块:一个对无答案问题自信作答的模型,在法律、金融、客服场景里比不答更糟。
引用层。CiteVQA 打的是让 RAG 在生产环境里危险的那种失败:归因幻觉。它的前提是,在合同、财报、病历里,答案对而引用错比不答更糟,因为审核的人信的是引用。于是基准把答案和 bounding-box 证据放在一起评。20 个 MLLM 的结果是个系统性模式:模型答案常常正确,指向的区域却是错的。Gemini-3.1-Pro-Preview 的严格归因准确率天花板是 76.0,最强开源模型 Qwen3-VL-235B-A22B 只有 22.5,这约 53 分的差距就是归因问题的实测大小。下次有人说自家 RAG”完全 grounded”,引这篇。
配置层。CARVE 证明连”检索什么”这个决定通常也做在了错误的粒度上。长视频 RAG 的通行做法是每个查询固定一套检索配置(视觉 embedding 或文字摘要,关键帧或完整片段)。CARVE 并行跑四个检索器,把每个 chunk 分配给捞出它的那套配置。消融很干净:最佳单配置 Recall@5 只有 0.507,最佳双配置组合 0.567,四套配置加按 chunk 选择到 0.603,对最强基线 0.510。“只在捞出它的那套配置下 rerank”是承重的:随机指派配置或拼接所有配置联合打分,都会掉到 0.513。而且这套不含训练的按 chunk 规则,生成通过率 0.357,高于训练过的非 LLM 路由器 0.329 和 LoRA 微调的 LLM 路由器 0.310。
**评测层。**以上这些数字,只要基准漏水就毫无意义。CARVE 配套的 V-RAGBench 存在的理由,是常用视频问答集里超过一半的样本根本不看视频也能答对,靠语言先验、世界知识或画面静态线索就够。构建者用五道顺序过滤(包括用 GPT-5.2-chat 做可答性验证、证据唯一性检查)筛到 2,100 条带证据标注的三元组、覆盖 216 个视频。因为证据有标注,检索和生成分开计分,0.603 这个 Recall@5 才可解读。“单独给检索打分,而不是只看得分”这个本能,CiteVQA 用在引用上,DCI 的受控替换用在接口上。
怎么选
- **语料大而静、查询是简单查找。**继续用向量检索。它便宜、可预期,DCI 自己的扩展曲线显示 agentic 搜索在 40 万文档时要付每问 122.4 次工具调用。如果单查询成本敏感、且查询靠检索到的上下文就能答,可以在下游配 OCC-RAG 式的小忠实读者。
- **语料本地化且常变、查询要拼多条弱线索。**这是 DCI 的主场:研究工作区、代码库、文档树,精确串、合取、上下文核查是主力。给工具调用留预算,语料一旦变大就封顶规模,或者和检索器做混合。
- **高风险文档问答。**按 CiteVQA 的方式加引用打分:每个答案必须带元素级证据,联合评分。强开源模型 22.5 的 SAA 是当前的真实基线,不是异常值。
- **多模态或长视频 RAG。**别按查询固定一套检索配置。CARVE 的数字说配置是 chunk 的属性;按 chunk 选择要多付四个检索器加一个 reranker,但换回 0.507 单配置之上 0.093 的绝对 Recall@5 提升。
- **以上全部。**先查基准漏不漏水。超过一半的题不看语料就能答,后面所有数字都是装饰。
局限与存疑
诚实的局限是:这些论文不共享基准,上表的数字从未同场竞技。DCI 的 80.0% 属于 BrowseComp-Plus 加前沿智能体,CARVE 的 0.603 属于 V-RAGBench 的第一人称视频,CiteVQA 的 76.0 天花板属于带框选的文档问答。GRPO 对 PPO 那种”同一套 harness”的对照列在这里不存在,谁宣称有一个在所有场景通吃的赢家,谁就在夸大。
每条路线也有各自的软肋。DCI 依赖前沿模型(Sonnet 4.6,以及一个 GPT-5.4 nano 的极简 harness)和精选的 BRIGHT、BEIR 数据集,部分增益来自智能体本身强,不只是接口。OCC-RAG 的”打平 2 到 6 倍大的模型”是区间声明,不是逐基准审计过的差值,且 300 万训练样本是合成的,风险是教会模型在机器生成文本上的 grounding 风格,而不是扛住真实检索的噪声。CiteVQA 只诊断不给药,四项指标里两项靠 LLM 评审。CARVE 每次查询跑四个检索器加一个 2B reranker,却没有给出成本预算,且 0.603 的 Recall@5 仍意味着约四成问题的正确证据进不了前五。
把五篇串起来的开放问题是:谁来训练接口?2020 年的 RAG 论文联合训练检索器和生成器,行业为了工程方便把这个训练信号扔了;DCI 和 CARVE 靠推理时的算力把能力补回来。联合训练的检索会不会回归,还是 agentic 接口会让检索器彻底可替代, genuinely 没有定论。
常见问题
agentic 的 grep 检索真的比向量检索强吗?
在测过的设定里,是,但有前提。同一 Claude Sonnet 4.6 底座下,把 Qwen3-Embedding-8B 检索工具换成 DCI 的终端访问,BrowseComp-Plus 准确率从 69.0% 升到 80.0%,成本还降了 29.4%;多跳问答平均 83.0,比最强检索智能体基线高 30.7 分。但这是前沿模型质量下、精选数据集上的接口对接口对比,不是普适结论,而且随着语料变宽,结论会反转。
DCI 的 retrieval 什么时候会失效?
很快,而且有实测。每问工具调用从 10 万文档时的 38.5 涨到 20 万时的 86.9,准确率掉 13.6 分;40 万文档时准确率 37.5%,每问 122.4 次调用,20 个样本超预算。DCI 深度上扩得好、广度上扩得差,所以作者把大而静的语料指回稠密和稀疏检索。
为什么 RAG 答案对了,引用却还是错的?
因为只评答案的基准从来不给引用打分。CiteVQA 把答案和 bounding-box 证据在 IoU 不低于 0.5 的条件下联合评分,20 个 MLLM 呈现系统性模式:答案对、区域指错。这就是归因幻觉,也是严格归因准确率天花板只有 76.0(Gemini-3.1-Pro-Preview)、最强开源模型 Qwen3-VL-235B-A22B 只有 22.5 的原因。
CARVE 按 chunk 配 retrieval 比按 query 路由强多少?
比最强基线高约 0.093 绝对 Recall@5,而且赢的方式不含训练。最佳单配置 0.507,最佳双配置组合 0.567,四套配置按 chunk 选择到 0.603(V-RAGBench)。训练过的非 LLM 路由器生成通过率 0.329,LoRA 微调的 LLM 路由器 0.310,都低于 CARVE 无训练规则下的 0.357。
0.6B 的小模型当 RAG reader 够用吗?
管阅读这半边够了,前提是检索靠谱。OCC-RAG 的 0.6B 和 1.7B 在五个 grounding 基准上打平或超过自身 2 到 6 倍大的通用模型,且上下文撑不起时会拒答。但它们被故意造成离开检索上下文就几乎无用,所以上游检索器仍是你的问题;而且忠实性声明是在合成训练数据上量出的区间,解读时留一分保留。