
SimCLR、BYOL、MAE、DINOv2 对比:冻结特征还是微调
SimCLR 负样本大 batch 到 69.3;BYOL 去负样本 74.3 且小 batch 稳;MAE 微调 87.8 冻结崩;DINOv2 冻结 86.3 超 OpenCLIP。
一句话结论
这四篇论文不是同一张榜单上的四个名次,而是自监督视觉的三个时代,各自赢的游戏不同。SimCLR 证明了实例判别这条路能走通,靠强数据增广、非线性投影头、4096 的超大 batch 和长训练,让 ResNet-50 在线性评测下拿到 69.3。BYOL 把「把别的样本推开」这一步整个删掉,不用负样本反而更强。MAE 干脆换了任务,做被掩码像素的重建,这让它成为微调场景下的最强预训练,却也让冻结特征一塌糊涂。DINOv2 则补上最后一块:只要数据精选到位,自监督训出来的冻结特征能压过当时最强的文本监督模型 OpenCLIP。该按自己的约束选时代,而不是按表里最大的数字选。
每一代到底改了什么
SimCLR 的贡献是一套干净的配方,而不是新目标函数。实例判别早就有,SimCLR 的贡献在于把强增广组合、投影头、大 batch 和长训练凑齐后,它确实能扩展。batch 之所以重要,是因为负样本就来自同一个 batch,模型能推开多少干扰项,直接取决于一次看多少张别的图。
BYOL 保留了两路增广视图,删掉了干扰项。两路分别过 online 网络和 target 网络,online 侧多一个小 predictor,去回归 target 的输出;target 则是 online 权重的指数滑动平均。loss 里没有任何阻止模型塌缩成常数的项,能撑住不塌,靠的是 predictor 加滑动平均这对组合,论文用消融和理论分析都验证过。实际收益是:BYOL 不再需要上千个 batch 内负样本,batch 缩小时性能掉得温柔得多。
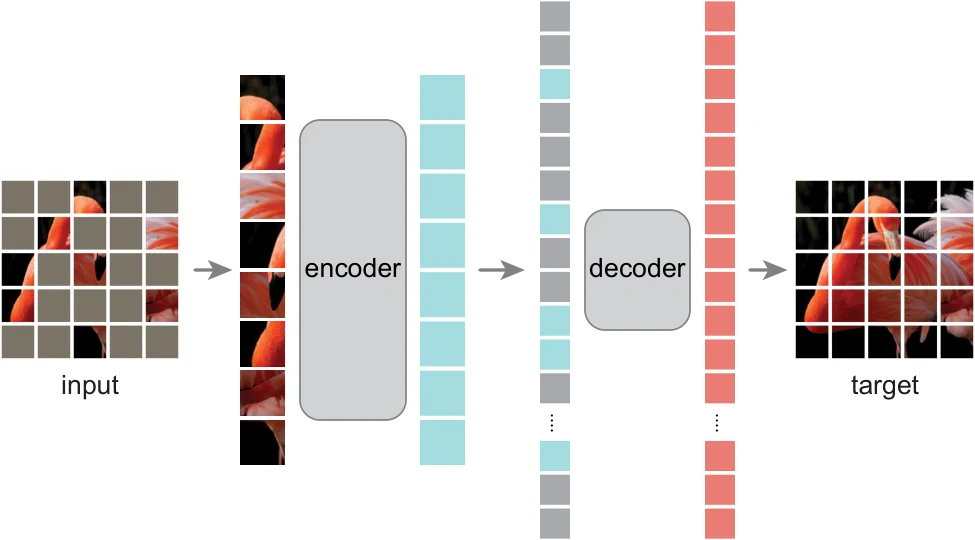
MAE 换掉了任务本身。它把约 75% 的图块掩掉,用一个轻量 decoder 从剩下的 25% 重建缺失像素,骨干是 Vision Transformer。encoder 全程看不到掩码 token,预训练算力因此省出约 3 倍,也让 ViT-Huge 只靠 ImageNet-1k 就能训起来。因为预训练任务是重建而不是判别,它学到的特征微调时极好、冻结时极差,这是本篇对比里最关键的一个事实。
DINOv2 的卖点是用法。它在 LVD-142M 上(Meta 自动精选、去重出的 1.42 亿张图)用自蒸馏目标训 ViT,再把 11 亿参数的 teacher 蒸馏成小模型。核心价值是:骨干冻结,接个线性分类器甚至直接 kNN,就能在大多数图像级和像素级基准上打平或超过 OpenCLIP。
关键数字
| 测量项 | SimCLR | BYOL | MAE | DINOv2 | 设定与出处 | 同一套 harness? |
|---|---|---|---|---|---|---|
| ImageNet 线性评测,ResNet-50(1x) | 69.3 | 74.3 | 不适用 | 不适用 | BYOL 论文 Table 1,1000 epoch | 同架构同协议族,两行均为 BYOL 作者报告 |
| ImageNet 线性评测,ResNet-50(4x) | 76.5 | 78.6 | 不适用 | 不适用 | BYOL 论文 Table 1,375M 参数 | 同一张表,协议对齐 |
| ImageNet 线性评测,ResNet-200(2x) | 不适用 | 79.6 | 不适用 | 不适用 | BYOL 论文 Table 1 | 不适用 |
| ResNet-50 300 epoch、batch 4096 | 67.9(BYOL 的复现) | 72.5 | 不适用 | 不适用 | BYOL 论文 Table 16 | 是,同数据、同代码、同 schedule |
| 同设定降到 batch 256 | 64.3 | 71.8 | 不适用 | 不适用 | BYOL 论文 Table 16 | 是 |
| 半监督,只用 1% ImageNet 标注 | 48.3 | 53.2 | 不适用 | 不适用 | BYOL 论文 Table 2,ResNet-50 | BYOL 声明的同一协议 |
| 半监督,10% 标注 | 65.6 | 68.8 | 不适用 | 不适用 | BYOL 论文 Table 2 | 同一协议 |
| ImageNet-1k 微调,ViT | 不适用 | 不适用 | 83.6(B)/ 85.9(L)/ 86.9(H)/ 87.8(H,448px) | 不适用 | MAE 论文 Table 3 | MAE 自家的尺寸扩展曲线,无对比方法臂 |
| ImageNet-1k 线性探针,ViT | 不适用 | 不适用 | 68.0(B)/ 75.8(L)/ 76.6(H) | 86.3(ViT-L/14)/ 86.5(ViT-g/14) | MAE 论文 Table 12;DINOv2 论文 Table 4 也列出 MAE ViT-H 76.6 | 否:MAE 只用 IN1K 训练,DINOv2 用 LVD-142M |
| 冻结特征 kNN,ViT | 不适用 | 不适用 | 49.4(ViT-H) | 82.1(ViT-B/14)/ 83.5(ViT-L/14) | DINOv2 论文 Table 4,单一评测 harness | DINOv2 家族内部是;MAE 行也在这张表里 |
| ADE20k 冻结线性头分割(mIoU) | 不适用 | 不适用 | 33.3(ViT-H) | 47.7(ViT-L/14) | DINOv2 论文 Table 10;同表 OpenCLIP ViT-G 为 39.3 | 是,一张表统一评测 |
排名之前先看「同一套 harness?」这一列。最干净的是中间几行:BYOL 作者自己按完全相同的 300 epoch 设定重训了 SimCLR,batch 4096 下差 4.6 个点,batch 256 下差 7.5 个点。ViT 那几行是不同论文各自的声明,预训练数据也不一样,DINOv2 那张表的价值恰恰在于它把 MAE、DINO、iBOT、OpenCLIP 塞进了同一个评测 harness,这已经是这个领域最接近受控对比的东西了。
为什么删掉负样本是大事
SimCLR 的隐含假设是实例判别需要大量负样本,它的消融也支持这一点:batch 缩小就掉点,因为每张图能推开的干扰项变少了。BYOL 的复现把代价量化了:300 epoch、batch 4096,SimCLR 复现 67.9,BYOL 72.5;batch 缩到 256,SimCLR 掉到 64.3,BYOL 只滑到 71.8。换句话说,SimCLR 对大 batch 的依赖大部分来自负样本本身,而不是对比学习这个目标。
论文给出的机制解释是 predictor:没有它、或没有滑动平均 target,表征就会塌缩;两者都在,online 网络就被逼着产出「一层小网络就能预测 target 特征」的表示,等价于在没有排斥项的情况下组织了特征空间。后续研究也加了注脚:target 端的 BatchNorm 统计会泄漏信息,loss 曲面存在平坦方向,训练比较娇气。但经验结论站住了,「无负样本」从此长成一个子方向,DINOv2 的自蒸馏目标就是同一家族的后续。
MAE 赢下微调,输掉冻结
MAE 的头号数字分居表格两端:微调后 ViT-Huge/448 在只用 ImageNet-1k 数据的条件下拿到 87.8 top-1,超过同骨干的监督预训练;同一个模型家族冻结后,线性探针 76.6、kNN 49.4,ViT-Base 线性探针更只有 68.0。在 DINOv2 的统一评测里,MAE ViT-H 的 49.4 kNN 对 DINOv2 ViT-B 的 82.1,是 33 个点的鸿沟。
原因是预训练任务。像素重建逼着网络保留低层细节,这些信息微调用得上,冻结的线性分类器却用不上。对比和蒸馏目标会把像素细节丢掉、留下能区分图像的部分,而冻结探针奖励的正是这部分。所以 87.8 和 49.4 是同一个模型在说同一件事:MAE 的特征是好初始值,不是好终点。它另一个实用优点是省算力:encoder 只处理可见的 25% 图块,预训练大约快 3 倍。
DINOv2 补上冻结特征的缺口
DINOv2 最该收藏的是它的中心表。ImageNet-1k 线性评测,ViT-L/14 拿 86.3,ViT-g/14 拿 86.5;文本监督的 OpenCLIP ViT-G/14 是 86.2,而 OpenCLIP 训练的 LAION-2B 比 LVD-142M 大约 14 倍。kNN 列讲得更锋利:DINOv2 ViT-B/14 完全不训分类器就有 82.1,MAE ViT-H 只有 49.4。像素级任务差距更大:ADE20k 冻结线性分割,DINOv2 ViT-L 47.7 mIoU,同表 MAE ViT-H 33.3、OpenCLIP ViT-G 39.3。
这篇论文值得抄的结论是数据侧:早年的自监督工作默认「规模洗掉噪声」,DINOv2 论证质量才是杠杆,并搭了一条自动筛选管线攒出 LVD-142M。目标函数本身只是已有自蒸馏技术的重组而非新发明,这暗示配方(大 batch、KoLeo 正则、iBOT 掩码 loss、长 schedule)和点子同等重要。
怎么选
- 有标注的目标集要微调,想要 ImageNet 规模下的最强初始值: 选 MAE。ViT-H/448 微调 87.8、只用 IN1K 数据,至今仍是参照点;预训练约 3 倍提速,中等规模复现也便宜。
- 下游一张标注都不要,做检索、分割、深度或探针分析: 选 DINOv2。它自家表里冻结线性和 kNN 全胜,蒸馏出的小模型才是实用档。
- 预训练 ResNet 类模型、给不起 4096 的大 batch: 选 BYOL。同一 harness 的 batch 扫描就是证据:256 batch 下 71.8 对 SimCLR 的 64.3。
- 想要处处都有公开配方的最简单基线: 用 SimCLR 当参照系而非天花板,它是后来每篇论文都要复现的方法,所以每个人的表里都有它的数字。
局限与存疑
四篇论文没有谁跑过别人的模型,所以上表几乎每一格都是「并排陈列的声明」而非真刀真枪的对打。例外是 BYOL 论文自己对 SimCLR 的复现行,以及 DINOv2 的统一评测表;即便后者,各模型的预训练数据也差着量级(只训 IN1K 对 LVD-142M),没法把差距全归因于目标函数。四篇的评测也都围着 ImageNet 转,医学、遥感、科学影像上的表现属于外推;冻结特征好也不等于公平性或安全性有保证。最后这个领域还在动:更新的工作把掩码重建和蒸馏揉在一起,CLIP 式文本监督也在持续变强,DINOv2 对 OpenCLIP 的优势应被看作 2023 年的快照,而非永久排序。
常见问题
SimCLR 和 BYOL 在 ImageNet 上谁更好?
按 BYOL 论文使用的协议,BYOL 在所有对比点上全胜:ResNet-50 线性评测 1000 epoch 下 74.3 对 69.3;BYOL 自己复现的 300 epoch、batch 4096 设定下 72.5 对 67.9。batch 越小优势越大,256 batch 时 BYOL 守住 71.8,SimCLR 复现掉到 64.3,因为 SimCLR 的负样本就住在 batch 里,而 BYOL 根本没有负样本。
BYOL 不用负样本为什么不会塌缩?
靠的是 predictor 加滑动平均 target 这对组合。online 网络额外有一层 predictor,被训练去回归 target 网络的输出;target 不是 online 的复制,而是其权重的指数滑动平均。消融显示拿掉任何一个都塌。predictor 的存在迫使 online 产出「一层小网络足以预测 target 特征」的表示,等价于在没有排斥项的情况下组织了特征空间。
为什么 MAE 的线性探针比微调低那么多?
因为像素重建保留下来的低层细节,冻结分类器用不上、全量微调用得上。MAE ViT-H/448 微调能到 87.8 top-1,同一个 ViT-H 骨干冻结后线性探针只有 76.6、kNN 49.4。如果你的管线要冻结骨干,MAE 就是选错了,别被标题数字误导。
DINOv2 比 CLIP 强吗?
在 DINOv2 自己的 ImageNet-1k 表里,冻结特征这个游戏它赢了:ViT-L/14 线性 86.3、ViT-g/14 86.5,对 OpenCLIP ViT-G/14 的 86.2,而 OpenCLIP 的训练集 LAION-2B 大得多。像素级差距更大:ADE20k 冻结线性分割 47.7 mIoU,同表 OpenCLIP 39.3。但要是你需要文本对齐的语义,自监督特征不会白送这项能力,那是另一场比较。
冻结特征和微调,我到底该用哪种?
没标注、要快速拿到通用特征,用 DINOv2 冻结特征;有标注目标集、算力够全量微调,用 MAE 预训练当初始值,它的 87.8 就是这么来的;如果在 ResNet 时代配方里、batch 给不大,选 BYOL 而不是 SimCLR。