
Echo-Memory 对比 Mirage:视频世界模型该怎么记住一个房间
Echo-Memory 固定预算只换记忆模块:块级循环 69.0 对无记忆 12.25;Mirage 把记忆搬进潜空间,快 10.57 倍、省 55 倍显存。
共同的问题:镜头转回来时,房间还得在
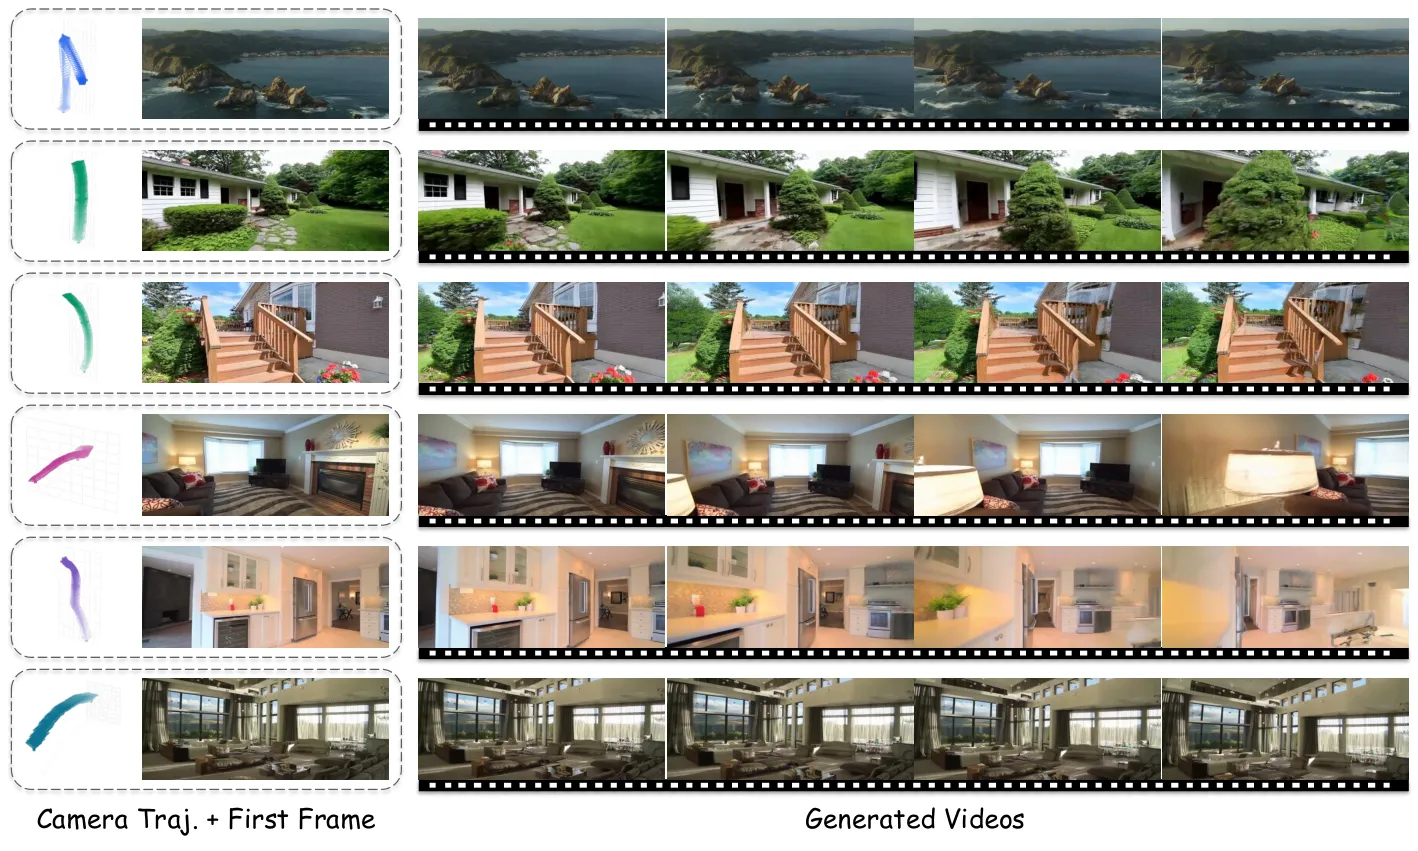
交互式视频世界模型是逐段往前滚的:给一张起始帧、一段文本和一串相机动作,模型生成视频;镜头转走、探索一圈、最后转回出发点。没有记忆的模型会高高兴兴地编出一个全新的房间。本页对比的两篇论文,都是对同一个问题的不同回答:该存什么、怎么读回来,才能让”回头看的画面”和之前一致。
Echo-Memory 和 Mirage 从相反的方向切入,放在一起读才有价值。Echo-Memory 是一篇对照研究:骨干网络、动作编码、数据、55k 步训练预算(8 张 A100-80G)全部冻结,只换记忆模块,让分数差异可以归因到记忆设计上。Mirage 是一个系统:拿已发布的骨干(Wan2.2-TI2V-5B),把 3D 记忆存放的位置改掉,让每段生成都要走一遍的昂贵循环消失。一个告诉你哪类机制赢,一个告诉你赢的那类工程化之后长什么样。
记忆存在哪里
两篇论文暴露的设计轴是同一个:像素空间还是潜空间,摘要压缩还是原样保留。
Mirage 要对抗的基线,也是此前的主流做法,是 RGB 空间里的显式 3D 点云。每生成一段,都要把潜变量解码成像素、用深度把像素抬进 3D、从新相机位姿渲染、再编码回潜变量。这条回路贵在两处:慢,而且有损,因为扩散模型的潜 token 携带了丰富的学习特征,一旦坍缩成 RGB 再读回来就没了。Mirage 的做法是全程不离开潜空间:用深度引导的反投影把潜 token 抬进 3D,存成一份持久的潜空间点云;生成新视角时,直接把存下的潜 token warp 到目标位姿,作为条件信号喂给扩散模型。不解码、不渲染、不重新编码。Wan2.2 的 VAE 空间步长 16、时间步长 4、48 通道,每个潜 token 本来就概括了一个 16x16 的像素块,这就是潜空间记忆比逐像素点云便宜得多的原因。另一个诚实的设计选择扛了大梁:动态区域过滤器把运动物体排除在持久缓存之外,只有刚性场景结构会被记住。
Echo-Memory 探索的选项更宽,因为它的目标是对比而不是做一个系统。在共享的视频 DiT 骨干(带逐帧 VAE 上下文表示)上,它测了四个记忆家族:原始上下文(回喂最近 K 帧,K=1、5、20)、压缩记忆(仅权重摘要、长度缩减 r=2/r=4 及其混合)、带多种读出路径的学习式空间摘要,以及状态空间循环(旧式混合形式和块级形式)。有意思的发现是这四个潜空间内部的设计里,哪些真的保住了场景。
关键数字
| 测量项 | Echo-Memory | Mirage | 设置与出处 | 同一套评测? |
|---|---|---|---|---|
| 回访一致性头部分数 | 69.0(块级状态空间循环)对 12.25(无记忆 I2V 基线) | WorldScore 平均 70.36,此前最优 Spatia 69.73 | Echo-Memory 开放域 VLM 评分 0–100;Mirage WorldScore 0–100 | 否,指标与评判模型不同 |
| 记忆读出消融 | 空间记忆默认读出 6.00 → inject-none 15.50 → 交叉注意力读出 17.12 | 不适用 | Echo-Memory 读出路径实验 | 是,Echo-Memory 内部 |
| 原始上下文扩展 | K=5 时 50.75,K=20 时 58.63 | 不适用 | Echo-Memory 原始上下文家族 | 是,内部 |
| 压缩的脆弱性 | 仅权重 22.38;长度缩减 r=4 达 43.25;混合 r=4 崩到 9.00 | 不适用 | Echo-Memory 压缩家族 | 是,内部 |
| 循环结构设计差异 | 旧式混合 34.75 对块级 69.00 | 不适用 | Echo-Memory 状态空间家族 | 是,内部 |
| 回访几何指标 | 重放 PSNR 13.60(最优:空间记忆) | 3D 一致性 92.21;光度一致性 93.95 | Echo-Memory 重放机制;Mirage WorldScore 分项 | 否 |
| 静态对动态场景 | 不适用 | 静态分 73.60 对动态分 67.11 | Mirage WorldScore 分项 | 是,Mirage 内部 |
| 对 RGB 点云记忆效率 | 不适用 | 端到端快 10.57 倍;显存省 55 倍 | Mirage 对显式 RGB 点云基线 | 是,Mirage 内部 |
| 各自绝对最优 | 回访分 69.0/100 | WorldScore 平均 70.36/100 | 各自基准 | 否 |
先读这张表缺什么。69.0 和 70.36 两个头部分数看着可比,两者都是 0–100 的一致性分,两篇论文发表时间只差两周,但不是一个指标。Echo-Memory 的分数是 Qwen3-VL 评判模型对自由轨迹、无真值画面的外观、存在性、视角、场景一致性打分(权重 0.45/0.25/0.20/0.10);Mirage 的是 WorldScore 标准基准套的平均。一个在 69 分的模型换到另一个指标未必还是 69。跨论文真正可比的,是设计逻辑和各自内部的消融,表内已逐行标注。
两个该改变你搭建方式的发现
第一,来自 Echo-Memory:读出比存储重要,而看着聪明的设计输了。学习式空间摘要拿了 6.00,比完全不记(12.25)还差。存下的表示没问题,是默认读出路径把信息毁掉了;同样的记忆换成 inject-none 读出升到 15.50,专用交叉注意力读出升到 17.12。压缩本该是效率赢家,却脆弱而非优雅:仅权重摘要 22.38,激进的长度缩减反而有用(r=4 达 43.25),但两者混合直接崩到 9.00。而胜出的块级循环拿到 69.00,同家族旧式混合只有 34.75,单家族内部一个结构改动就是近 2 倍差距。这个教训超出本文:记忆机制表现不佳时,先消融读出路径,别急着怪表示。
第二,来自 Mirage:贵的不是记忆本身,而是像素往返。把 3D 缓存留在潜空间,每段生成省掉一次 VAE 解码、一次渲染、一次重新编码,换来端到端 10.57 倍提速、55 倍显存下降,质量持平或更好。质量一侧作者自己很诚实:70.36 对 Spatia 的 69.73 只差 0.63 分,单靠这个只是个增量结果。这篇论文重要的原因是它让长时程交互式滚动,也就是场景要以分钟计持续存在的游戏式环境和具身仿真,在一档 GPU 硬件上变得可行,而不是非要渲染农场。Wan2.2 VAE 的 16 倍空间步长是承重墙:换个潜网格更细的骨干,同样的技巧收益会缩水。
两篇论文之间的分歧
它们没跑同一个实验,但指向的存什么结论并不一致。Echo-Memory 发现,对场景记忆做压缩或学习式摘要是最危险的操作:压缩崩了,空间摘要在读出修好之前不如不记。它的赢家块级循环,是保留但压缩过的信号、以模型自身状态向前带,不是外部缓存。Mirage 相反,存的是显式外部 3D 缓存,还赢了效率,但它存的是接近原样的潜 token,不是学出来的摘要,而它之所以能近乎无损,正是因为步长 16 的潜 token 本身已经是紧凑表示。换句话说,两篇论文都同意:对场景记忆做学习式摘要是设计翻车点;它们的分歧在于答案是状态内循环(Echo-Memory)还是外部可 warp 的缓存(Mirage),而没有任何共享基准能裁决这个分歧。
还有一课关于测量,来自 Echo-Memory。它把重放(重跑真值轨迹,用 PSNR/SSIM/LPIPS 对画面)和开放域回访(自由轨迹,VLM 评判)分开。重放 PSNR 最优的空间记忆(13.60),恰恰是语义回访最差的设计(6.00)。PSNR 奖励的是复制,不测量记忆。Mirage 的 3D 一致性(92.21)和光度一致性(93.95)更接近真正重要的东西,但也是在它自己的基准里算的。无论采用哪种方法,都要给回访专用的评测留预算,不能只看生成质量指标。
怎么选
- **固定训练预算下给动作条件视频世界模型选记忆模块:**Echo-Memory 的排名是目前最好的对照证据:块级状态空间循环(69.0)> K=20 原始上下文(58.63)> 长度缩减压缩(43.25),学习式空间摘要和混合压缩连无记忆基线都不如。第一个要消融的是读出设计。
- 在现有硬件上落地长时程交互世界模型:Mirage 是可采用的系统。它包着一个已发布的 Wan2.2 检查点,不需要重训骨干,10.57 倍/55 倍是相对你本来要跑的显式点云管线而言的。
- **运动多的场景:**Mirage 的动态区域过滤器把运动物体排除在持久记忆外,它自己的数字就显示了代价:动态分 67.11 对静态分 73.60。走出画面的角色不保证回来时一致。Echo-Memory 也没解决这个问题:它最好的分数是 69/100,胜出的机制仍留着三分之一的差距。
- **评测自己的系统:**别只信重放 PSNR;Echo-Memory 证明一个设计可以赢下像素指标却在语义回访上失败。用 VLM 评判的开放域回访分,并做换评判模型的交叉验证(Echo-Memory 报告偏差在 1.3–3.1 分内、排序相关 ρ≥0.93),才是更诚实的机制。
局限与存疑
哪一篇都没有在对方的设定下得出结论。Echo-Memory 的排名来自单一实验台:352x640、81 帧、55k 步、一个骨干家族,换更高分辨率、更长时程或更大的训练预算,排名未必成立,压缩方法可能只有在那些条件下才值回票价。而且它是研究不是发布物:你得到的是一个排名和一套评测协议,不是一个调好的检查点。Mirage 的结果绑死在一个骨干一种 VAE 几何上;潜空间记忆能否迁到步长和通道数不同的骨干未经验证,深度引导反投影会继承深度估计器的误差。对 Spatia 仅 0.63 分的领先意味着它的质量主张其实是个效率主张。跨论文的空白仍在:没有人把 Mirage 的潜空间缓存和 Echo-Memory 的循环放在同一套 harness 下跑过,外部潜空间缓存对状态内循环仍是一个没有共享基准答案的开放设计决策。
常见问题
视频世界模型最好的记忆机制是哪种?
在 Echo-Memory 的对照实验里,块级状态空间循环拿到 69.0 的开放域回访一致性分,无记忆基线只有 12.25,胜过 K=20 原始上下文(58.63)和所有压缩与空间摘要设计。要落地生产系统,Mirage 的潜空间记忆目前最实用:不需要重训骨干,比 RGB 点云管线快 10.57 倍。
为什么 Echo-Memory 的空间记忆还不如不记?
瓶颈在读出路径,不在存下的表示。默认读出的空间记忆只有 6.00,低于 12.25 的无记忆基线;换成 inject-none 读出升到 15.50,专用交叉注意力读出升到 17.12。
Mirage 比点云世界模型快多少?
端到端生成快 10.57 倍,GPU 显存省 55 倍,同时 WorldScore 平均更高(70.36 对此前最优 Spatia 的 69.73)。
能把 Echo-Memory 的 69.0 和 Mirage 的 70.36 直接比吗?
不能。69.0 是 Qwen3-VL 评判模型在自由轨迹、无真值画面上打的回访分;70.36 是 WorldScore 基准平均。虽然都是 0–100 的一致性分,但指标、评测套、骨干、分辨率和协议全不同。