
世界模型和大语言模型的区别:模拟、符号,以及何时该信一次推演
大语言模型用语言在规则和目标上推理,世界模型预测一个场景接下来会怎样。2026 年的证据说两者互补,难点在第三种能力:判断一段生成出来的未来可信到什么程度,能不能据此行动。
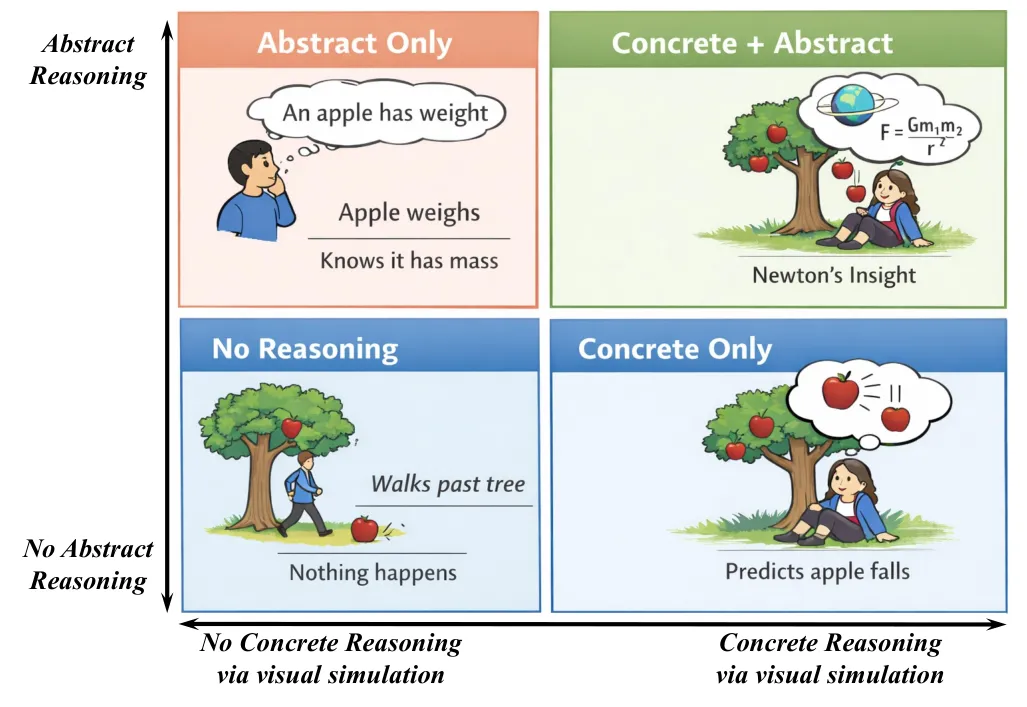
被预测的是两种不同的对象
大语言模型在给定文本下预测下一个 token。它的推理强项来自对符号、规则和目标的操作,最可靠的训练信号是可验证的答案。DeepSeek-R1 是最干净的演示:只用规则校验奖励做纯强化学习,AIME 2024 pass@1 从 15.6 升到 71.0,没有任何人类推理数据,发布的模型达到 79.8。同一篇论文对边界说得很明白:这套配方需要一个可校验的答案,所以它并不能显然迁移到正确性无法在文本中打分的任务。
世界模型在给定当前状态和动作下预测环境的下一个状态。2026 年这意味着视频级模型:Cosmos 3 在一个 mixture-of-transformers 网络里读写语言、图像、视频、音频和动作,发布时是 RoboArena 上排名第一的策略模型;Kairos 是一个 4B 模型,用线性代价的时间注意力在单张 RTX 5090 上 11.4 秒渲染一段 480P 推演,以 80.84 领跑 PAI-Bench;WALL-WM 联合去噪未来视频和机器人动作,在真机操作上平均 75.86 的任务进度,对 pi-0.5 的 55.64。这些模型都不是在争取成为更好的语言推理器,它们在争取成为更好的物理预测器,让策略可以在上面推演。
所以人们问”世界模型 vs 大语言模型”时,问题并不是谁更聪明,而是某个决策该问谁,以及如何把两者组合起来,不让一段逼真却错误的推演污染答案。
关键数字
| 测量项 | 大语言模型 | 世界模型 | 设置与出处 | 同一套评测? |
|---|---|---|---|---|
| 预测的对象 | 下一个 token | 给定动作后场景的下一个状态 | 定义 | 不适用 |
| 最有效的训练信号 | 可验证答案(规则奖励上的 RL) | 未来帧、动作、物理一致性 | DeepSeek-R1;Cosmos 3、Kairos、WALL-WM | 不适用 |
| 纯 RL 带来的 AIME 2024 pass@1 | 15.6 → 71.0(R1-Zero),发布版 79.8 | 不适用 | DeepSeek-R1 | 不适用 |
| 空间前瞻问答,VRQABench | 61.8(SFT 多模态模型,无模拟) | 带门控世界模型推演后 72.4 | PF-OPSD,Qwen3.5-9B 学生模型 | 是 |
| 开放域物理预测,OpenWorldQA | 59.6 | 70.5 | 同上 | 是 |
| 验证推演的价值 | 不适用 | 去掉验证 72.4 → 65.2;去掉优势加权 → 66.4 | PF-OPSD 消融 | 是 |
| 物理 AI 视频基准 PAI-Bench | 不适用 | 80.84(Kairos 4B),领先 Cosmos 2.5 的 2B 和 14B | Kairos 论文 | 世界模型内部 |
| 480P 推演延迟 | 不适用 | 单张 RTX 5090 11.4 秒;四张 A800 3.0 秒 | Kairos | 不适用 |
| 每步代价随时长的变化 | 随上下文增长(KV 缓存) | 混合线性时间注意力下 O(n) | Kairos,定理 2 的界 | 不适用 |
| 真机操作任务进度 | 不适用 | 75.86(WALL-WM 事件模式)对 55.64(pi-0.5)对 39.97(DreamZero) | WALL-WM 内部套件 | 机器人策略内部 |
| 对新场景与新指令顺序的泛化 | 不适用 | 53.75 对 18.50(同一模型,定长块) | WALL-WM 消融 | 是 |
| 同一骨干里的模态 | 文本(外挂编码器) | 语言、图像、视频、音频、动作 | Cosmos 3 | 不适用 |
唯一在同一任务上把大语言模型和世界模型放在一起的是 PF-OPSD 那几行,而且比较的也是”多模态模型单独”对”多模态模型加门控世界模型推演”。其余各行都是各自家族在各自地盘上的成绩。
世界模型赢在哪
一切取决于场景接下来会怎样的事。PF-OPSD 的基准就是为此隔离出来的:答案取决于往前模拟几步的迷宫和推箱子类谜题,以及来自 Charades、Something-Something 和 Oops 的真实视频物理预测。给一个 9B 多模态大模型接入 Helios 推演并训练它何时使用,准确率提升 10.6 和 10.9 分。机器人结果是另一半:WALL-WM 的事件级监督让泛化任务进度比同架构定长块训练翻了一倍多,Cosmos 3 能把同一个网络变成 RoboArena 榜首的策略,因为它输出的是动作而不只是描述。
长时程上代价曲线也偏向世界模型。Kairos 的时间因子分解让每步生成代价随推演长度基本持平,定理 2 在收缩假设下给长时程误差一个上界,这是自回归文本生成没有的那种保证。
大语言模型赢在哪
一切能用符号校验的事。R1 的规则奖励之所以有效,是因为数学答案或单元测试是精确的;正是这种精确性让 RL 自己发现了长思维链、自我检查和回溯。世界模型没有”这段推演对不对”的等价信号,所以 PF-OPSD 的作者不得不构造一个能看到真实未来的特权教师。
信任是第二个优势。视频世界模型的推演是随机的,可能看起来逼真却在任务上是错的:球落进错误的杯子,迷宫智能体穿墙而过。把这样的推演喂给推理器比忽略它更糟。PF-OPSD 的消融量化了这一点:去掉推演验证,VRQABench 掉 7.2 分,超过总收益的一半。组合系统里大语言模型的职责不是服从模拟,而是给模拟打分。
怎么选
- 数学、代码、显式规则上的规划,任何有验证器的任务: 大语言模型,按 R1 的方式训练或提示。世界模型只增加成本,不增加信号。
- 机器人控制、接触密集的操作、“我推一下会怎样”: 世界模型或世界-动作模型。WALL-WM 和 Cosmos 3 是当前参照;大语言模型如果在场,负责解析指令。
- 取决于几步物理前瞻的视觉问题: 大语言模型加世界模型,配一个学出来的门。照搬 PF-OPSD 的结构:决定是否模拟、验证推演、给它加权,并且绝不让部署模型看到真实未来。
- 消费级硬件上的长推演: 选 Kairos 这样的线性注意力世界模型而不是平方级的;单卡 11.4 秒这个数字就是理由。
局限与存疑
唯一受控的”大语言模型对大语言模型加世界模型”结果用的是同一团队构建的两个基准,以图像为条件、短时程,教师依赖能看到黄金未来的 Gemini-3.1-Pro,复现这个门代价很高。世界模型的基准优势有一部分是数据优势:Kairos 用了大约 10 万小时人类视频,Cosmos 3 是 294 位作者的工程。机器人对比(WALL-WM 对 pi-0.5 和 DreamZero)跑在内部套件和团队自己的评分标准上。而且没有一篇论文测量部署中最要紧的失效:通过验证的推演仍然出错的频率有多高,下游代价是什么。
常见问题
世界模型和大语言模型的区别是什么?
大语言模型预测下一个 token,用语言在符号、规则和目标上推理。世界模型在给定动作下预测场景的下一个状态,今天通常是视频加动作。R1 式的大语言模型从可验证答案中学得最好;Cosmos 3、Kairos、WALL-WM 这类世界模型从未来帧和物理一致性中学习。
推理任务上对比,世界模型比大语言模型更好吗?
在规则和可校验答案上的推理,不是:DeepSeek-R1 完全不用模拟就在 AIME 2024 上达到 79.8。在取决于物理前瞻的推理上,给 9B 多模态大模型加入门控的世界模型推演,VRQABench 从 61.8 升到 72.4。
大语言模型如何可靠地使用世界模型的模拟?
只有配合验证才行。推演是随机的,可能逼真却错误。PF-OPSD 里去掉推演验证,基准收益从 10.6 分缩到 3.4 分,所以模型必须学会何时调用、信任和加权一次模拟。
世界模型会取代 VLA 机器人策略吗?
两者正在融合。WALL-WM 联合去噪未来视频和动作,真机任务进度胜过 pi-0.5(75.86 对 55.64);Cosmos 3 用生成视频的同一个网络输出动作。区别正在变成训练配方的区别,而不是模型类别的区别。