
多模态大模型空间推理对比:改交互、改视角,还是改预训练?
三路攻 MLLM 空间推理:SpatialClaw 工作区 20 榜均分 59.9,ReRe 合成新视角 2B 模型 VSI-Bench +8.5,视频模型带着 VLM 缺的几何。
为什么空间推理是短板
VLM 描述图像已经很流利,但一个小孩扫一眼就能回答的问题它仍然常错:哪个物体更远、相机往哪动了、两个不同画面里的像素是不是同一把椅子。站上三篇论文从三条完全不同的路线攻这个短板,值得对比的其实是路线本身,不只是分数。
SpatialClaw 改的是动作界面:给 VLM 一个常驻 Python 内核,配上感知和几何工具。ReRe 改的是推理流程:重建场景、渲染一段抬高的斜向漫游视频,让模型看完原片后”再看一遍没见过的视角”再改答案。那篇预训练范式研究改的是表征:问视频生成模型为了合成画面而学到的三维结构,是不是比 VLM 的更好用。一个修”怎么动”,一个修”看什么”,一个修”知道什么”。选哪条,看你的预算和时间表。
SpatialClaw:把代码当动作界面
SpatialClaw 的出发点是:空间智能体失败,往往败在结构化工具调用太死板。一个任务如果先要分割、再叠深度图、再拟合平面、最后检查轨迹,固定的 JSON 工具模式要求设计者预先猜中所有组合方式。SpatialClaw 改为给智能体一个常驻 Python 工作区:模型逐格写代码、调用感知原语、查看中间结果、让变量跨步存活,发现遮罩不对就换办法。
结果全部免训练,骨干是 Gemma 4-31B:
| 界面(工具相同) | 20 个空间榜均分 |
|---|---|
| 不用工具 | 53.4 |
| 单轮代码 | 55.2 |
| 结构化工具调用 | 56.7 |
| SpatialClaw 常驻工作区 | 59.9 |
与表中此前的空间智能体基线相比是 59.9 对 48.7,差 11.2 分。具名榜单上差距也稳:MindCube 72.8,对照结构化工具调用 62.4、SpaceTools 52.9;DSI-Bench 62.9,对照 58.4 和 43.0。最值得抄的是消融:抽掉工具函数,均分几乎不动(56.9→56.4);抽掉感知工具,掉到 51.4。真正起作用的是”工作区”本身,不是工具菜单的长度。
ReRe:看一段”不存在的视角”再改答案
ReRe(Reason, then Re-reason)同样免训练,但动的是输入而不是动作空间。模型先对一段第一视角片段作答;然后 Geometry-to-Video 管线重建场景、渲染一段抬高的斜向飞行视频;同一个模型再看这段合成视角,确认或修正第一次的答案。权重完全不动。
VSI-Bench 上,小模型的提升最可观:
| 骨干 | 基线 | 加 ReRe | 增量 |
|---|---|---|---|
| Qwen3-VL-2B | 22.5 | 31.0 | +8.5 |
| Qwen3-VL-4B | 30.7 | 36.5 | +5.8 |
| Qwen2.5-VL-7B | 24.8 | 29.5 | +4.7 |
| InternVL2.5-8B | 35.5 | 36.7 | +1.2 |
参照系:VSI-Bench 上 GPT-4o 是 34.0,Gemini-1.5 Pro 是 45.4,也就是说 2B 模型加 ReRe 后越过了 GPT-4o。消融直接回应了怀疑者:如果提升只是”想了两次”,那把第二段视频朴素拼接或交错放进去也该有同样效果。事实不是:Qwen2.5-VL-7B 上单轮 24.8、拼接 25.4、交错 25.6、完整 ReRe 29.5。拿分的是”对着好的新视角做结构化修正”。反过来,给模型配一个错误的合成视角,分数掉到 23.5,比不看的 24.8 还差。糟糕的第二个视角会主动把答案带歪。轨迹消融也一致:抬高斜向扫掠 29.5,优于鸟瞰环绕 27.4 和中层穿行 25.6。
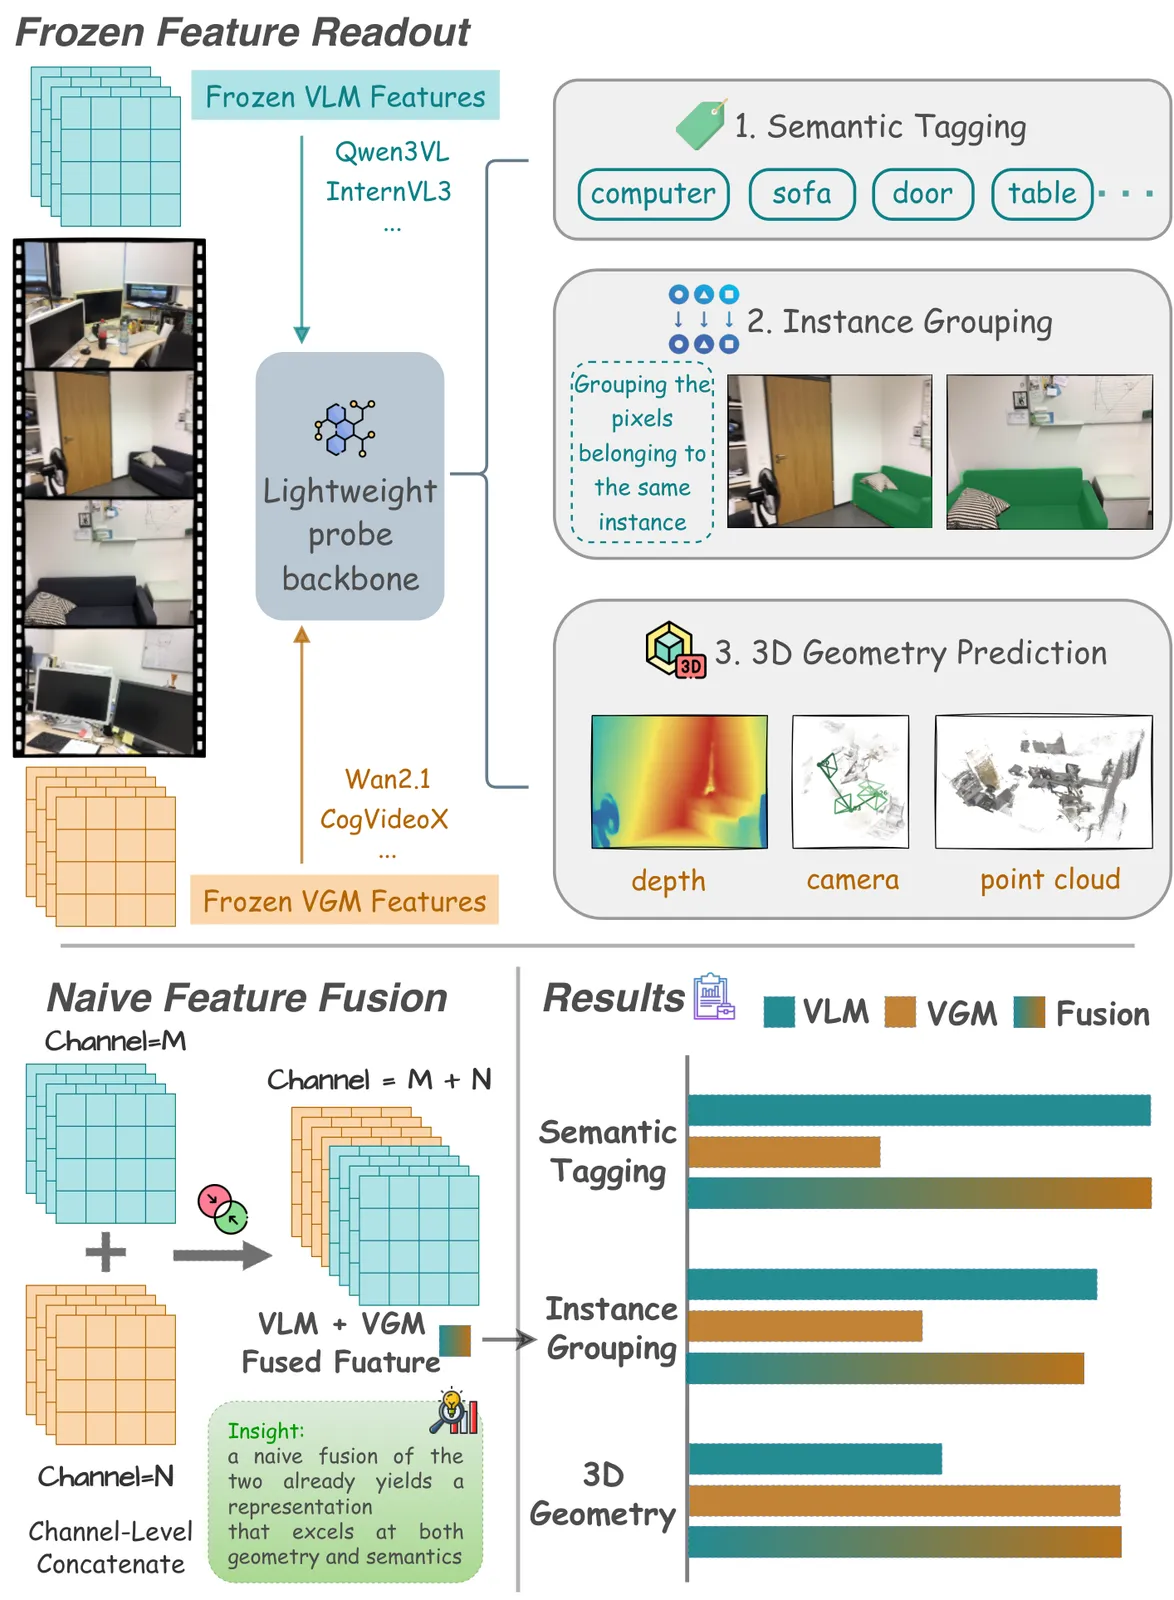
VLM 对视频生成预训练:几何在谁手里?
第三篇不问测试时的花样,只问预训练骨干里已经装了什么。它冻结一批 VLM 和视频生成模型,只在上面训一个薄探针,读出三项空间能力:ScanNet20 语义标注(mAP)、跨视角实例归组(T-mIoU)、DL3DV 稠密三维几何(相机运动 AUC@30、深度 AbsRel、点图误差)。
| 任务 | VLM(均) | 视频模型(均) | 赢家 |
|---|---|---|---|
| 语义标注 ScanNet20 mAP | 92.08 | 69.89 | VLM,领先 22 分 |
| 实例归组 T-mIoU | 22.66 | 13.24 | VLM |
| 相机运动 AUC@30 | 0.330 | 0.527 | 视频模型 |
| 深度 AbsRel(越低越好) | 0.113 | 0.072 | 视频模型 |
| 点图误差(越低越好) | 0.223 | 0.152 | 视频模型 |
分工干净利落:VLM 赢语义,视频生成模型赢几何,因为合成视频逼着模型内化相机位置和表面在三维中的排布。最实用的是第三个发现:把一个视频生成模型(WAN2.1-T2V-14B)和一个 VLM(Qwen3-VL-8B)的特征归一化后拼接,用同一个探针,拿到 92.30 mAP 和 0.615 相机 AUC@30,两条轴上同时打赢任何单骨干。探针深度从 1 到 6 排名几乎不变,说明这些数字是冻结表征的性质,不是探针自己学出来的。
关键数字
| 数字 | 出处 |
|---|---|
| 59.9 / 56.7 / 53.4 | SpatialClaw 工作区、结构化工具调用、不用工具,20 榜均分 |
| 72.8 / 62.4 / 52.9 | MindCube:SpatialClaw、结构化工具调用、SpaceTools |
| 62.9 / 58.4 / 43.0 | DSI-Bench:同样的三种界面 |
| 22.5 → 31.0(+8.5) | ReRe 在 VSI-Bench 上,Qwen3-VL-2B,免训练 |
| 24.8 / 25.4 / 25.6 / 29.5 / 23.5 | ReRe 消融(Qwen2.5-VL-7B):单轮、拼接、交错、完整 ReRe、错误视角配对(低于基线) |
| 92.08 / 69.89 mAP | ScanNet20 语义标注,VLM 对视频模型冻结特征 |
| 0.527 / 0.330 AUC@30 | DL3DV 相机运动,视频模型对 VLM |
| 92.30 mAP、0.615 AUC@30 | WAN2.1-T2V-14B + Qwen3-VL-8B 特征拼接,同时超过两个单骨干 |
这些数字来自不同评测口径,不能合成一张总榜,谁把它们排进一张 leaderboard 谁就是在糊弄你。
怎么选
三篇论文支撑的是一个决策顺序。两篇免训练论文的最大提升恰好都出现在裸 VLM 最弱的地方,而且代价是推理算力加一个外部工具(Python 内核,或几何到视频的管线),不是一轮训练。所以在给训练任务排预算之前:
- 失败模式是多步测量(相对方位、相机运动、跨视角计数):先上 SpatialClaw 式工作区。需要沙箱化 Python 内核加可靠的感知原语,论文自己的消融说:一小套带持久状态的工具,胜过一长串窄工具端点。
- 失败模式是单段第一视角里的一眼误判:先上 ReRe 式第二个视角。需要三维重建和新视角渲染器,让同一个 VLM 看两遍;只有合成视角正确时才有增益,所以钱要花在几何管线上。
- 反正要训练或微调:从视频生成骨干那里取几何。探针研究显示,起步连融合架构都不用上,归一化特征拼接就已经同时打赢两个单骨干。
局限与存疑
两个提醒适用于全部三篇。第一,所有头条数字都是榜单空间推理,不是具身能力;SpatialClaw 明确说这不证明真实世界里的物理规划。第二,骨干越强增益越小:ReRe 给 2B 模型 +8.5,给 8B 模型只有 +1.2。界面和视角这两个技巧,最大的受益者恰恰是负担不起训练的那批模型。
论文留下的开放问题:常驻工作区和第二视角能否叠加(没人跑过 SpatialClaw + ReRe 式输入);视频模型的几何优势在端到端微调而不是冻结探针时还在不在;以及这些方法能否迁到流式场景,那里模型无法回看早先帧。
常见问题
代码工作区和新视角管线,哪个方法先试?
两篇都免训练,成本在工程不在 GPU。SpatialClaw 需要沙箱化 Python 内核加感知原语;ReRe 需要三维重建和新视角渲染器,让同一个 VLM 看两遍。如果你的失败模式是多步测量(相对方位、相机运动、跨视角计数),先上工作区;如果是单段第一视角里的一眼误判,先上第二个视角。
再看一段视频就能提升空间推理的基准分数吗?
只有协议对才行。ReRe 在 Qwen2.5-VL-7B 上的消融:单轮 24.8,朴素拼接 25.4,交错 25.6,完整 ReRe 29.5。配上错误的合成视角是 23.5,比基线 24.8 还低。拿分的是对着正确的抬高斜向视角做结构化修正;草率的第二个视角只会让结果更差。
视频生成模型和 VLM 的空间能力区别在哪?
分赛道,而这个分工正是重点。冻结探针实验里,视频模型赢几何(DL3DV 相机 AUC@30 0.527 对 0.330,深度 AbsRel 0.072 对 0.113),VLM 赢语义(ScanNet20 mAP 92.08 对 69.89)和跨视角归组(T-mIoU 22.66 对 13.24)。把两边特征朴素拼接,两条轴同时超过任何单骨干(92.30 mAP、0.615 AUC@30)。
这些方法证明 MLLM 懂三维了吗?
没有,SpatialClaw 自己也这么说:提升应归功于工具加工作区,而不是基座模型。三篇论文改进的都是空间证据如何到达模型、如何被计算,谁也不声称 VLM 内部长出了原生的三维世界模型。
一句话结论:重训之前,先改交互界面或补一个视角;要动预训练,就从视频生成特征里取几何。带数字的原文解读在 SpatialClaw、ReRe 和 预训练范式研究 三篇论文页。