
混合专家模型(MoE)原理解读:从 Switch 到 DeepSeek-V3
把每层一个前馈网络换成许多专家和路由器,每个 token 只激活少数专家:参数总量和每 token 算力就此脱钩。Switch、Mixtral、DeepSeek-V3 三代设计一次讲清。
工作原理
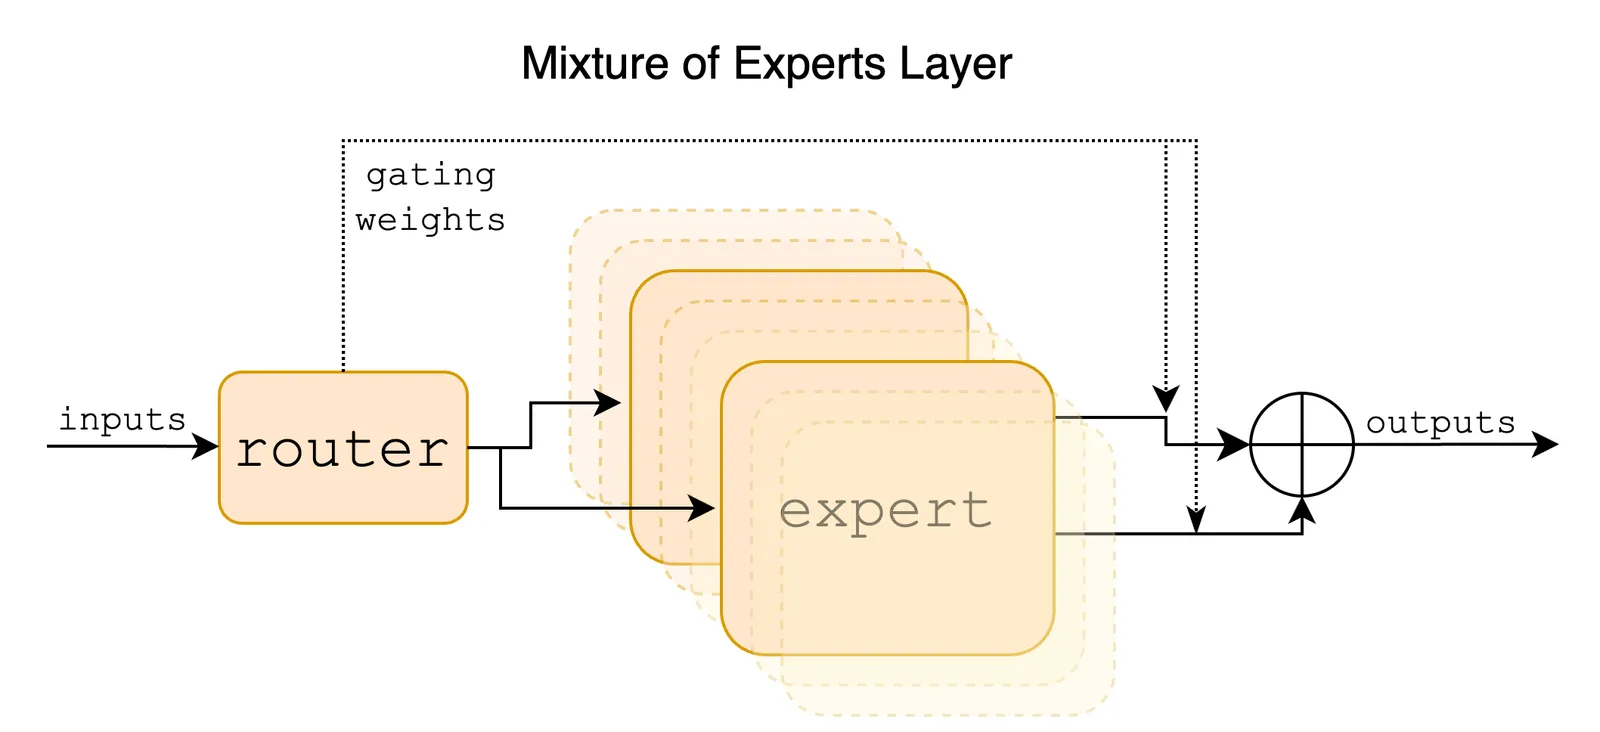
标准 Transformer 里,每个 token 在每层都走同一个前馈网络。混合专家模型(MoE)把这一个网络换成 N 个并行副本,也就是「专家」,再加一个小路由器,按 token、按层决定该交给哪几个专家。只有被选中的专家真正参与计算,于是模型的参数总量和每 token 的算力开销脱钩了。参数量从此不再是每 token 成本的代名词。 这个思路在现代大模型里的演进由三篇论文完成,各自攻下一个不同的瓶颈:
- Switch Transformer(Google,2021)赌「每个 token 只送一个专家就够了」,让稀疏 MoE 首次在规模上训得动:总量做到 1.6 万亿参数,每 token 的 FLOPs 却压在 T5-Base 量级,同等算力下预训练比 T5-Base/Large 快最多 7 倍。
- Mixtral 8x7B(Mistral,2023)把 MoE 变成开源社区真正能下载部署的东西:8 个专家、top-2 路由、总量 47B、每 token 只激活约 13B,在 Apache 2.0 协议下打平或超过 Llama 2 70B 和 GPT-3.5。
- DeepSeek-V3(2024)把稀疏度推到当前极限:671B 参数、每 token 只激活 37B,用 14.8 万亿 token、278.8 万 H800 GPU 小时(按报告假设的每卡时 2 美元,约合 560 万美元)完成预训练,路由侧做到了不靠损失函数拉均衡。
关键数字
| 维度 | Switch Transformer | Mixtral 8x7B | DeepSeek-V3 |
|---|---|---|---|
| 参数总量 | 1.6T(Switch-C) | 47B | 671B |
| 每 token 激活参数 | FLOPs 压在 T5-Base 量级 | 约 13B | 37B |
| 激活占比 | 低(单专家) | 约 28%(13B/47B) | 约 5.5%(37B/671B) |
| 每 token 路由选择 | top-1,恰好一个专家 | 8 个里选 2 个 | 每 token 一个小子集 |
| 负载均衡 | 辅助损失 + 容量因子(溢出 token 被丢弃) | 非论文重点 | 免辅助损失,调路由里的每专家偏置 |
| 代表性训练结果 | 同算力预训练比 T5-Base/Large 快最多 7 倍 | 用 13B 级算力打平或超过 Llama 2 70B 和 GPT-3.5 | 以低一个数量级的成本达到前沿水平 |
| 许可 | 研究发布 | Apache 2.0 | 开放权重 |
「激活占比」这一行值得读两遍,因为这是最容易被搞错的地方:Mixtral 每 token 动用约 28% 的参数,DeepSeek-V3 只有约 5.5%。两者都算「MoE 模型」,但处在稀疏-稠密光谱上很不同的位置,工程上的麻烦也因此不一样。
Switch 为什么赌单专家,后来大家又为什么改回来
在 Switch 之前,从早期 MoE 工作继承下来的假设是 top-k 且 k ≥ 2:每个 token 至少送两个专家,路由器才能拿到有用的梯度。Switch 的赌注是 k = 1 就够了:直接送给分数最高的那个专家,再用路由概率缩放它的输出,梯度照样流动。收益立竿见影:路由计算量减半,跨设备通信量大致减半,层实现大幅简化,因为每个 token 只有一个目的地。
结果站住了:同算力下预训练比 T5-Base 和 T5-Large 快最多 7 倍,Switch-C 做到了 1.6T 参数。但它的两个机制没能同样长寿。容量因子(每个专家一个固定缓冲区,装不下的 token 直接走残差丢弃)意味着总有 token 得不到专家。而后来的事实判决写在后续系统里:Mixtral 回到了 top-2,DeepSeek-V3 也路由到一个小子集而非单个专家。单专家路由足够简单、足够快,但不是质量最优点。Switch 真正留下的遗产是框架本身(「稀疏 = 不涨每 token 成本就能扩容」)、它逼所有人面对的负载均衡问题,以及「路由用 float32、其余用 bfloat16」的混合精度技巧,后者首次让大规模稀疏低精度训练稳定下来。
Mixtral 到底是什么,「8x7B」哪里说错了
Mixtral 沿用 Mistral 7B 的架构,只把每层的前馈块换成 8 个。路由器对每个 token 的隐状态在 8 个专家上打分,跑分数最高的 2 个,按 softmax 权重加权合并。选择是逐 token、逐层发生的:同一句话里相邻两个 token 可以被送去完全不同的专家组合,某 token 在第 5 层的专家和它在第 20 层的毫无关系。
「8x7B」这个名字两头都误导。8 个专家共享注意力层,所以总量是 47B 而不是 56B。而且只有前馈路径是稀疏的,所以每 token 激活的是约 13B 参数,而不是 47B。「47B 的质量、13B 的推理成本」这个卖点是真的,但附带一个诚实的代价:这是服务器端的便宜。路由取决于输入,你无法预知一个请求会用到哪些专家,47B 权重必须全部常驻显存。Mixtral 省的是算力和吞吐,不是显存;它要用 47B 模型的内存才能跑出 13B 模型的速度,所以单卡用户几乎从第一天起就得靠量化。
评测故事是 Mistral 自己跑的:以 13B 级激活算力,在 Mistral 测的所有基准上打平或超过 Llama 2 70B 和 GPT-3.5。这是第一个社区真正能部署的强开源 MoE,而 Apache 2.0 协议起的作用不亚于架构本身,MoE 服务栈、微调、量化在一两周内大量涌现。论文自己的分析也给出一个提醒:路由器并不会把专家分给人类可解释的主题。「专家」是架构标签,不是语义标签,你不能通过指定专家来引导模型做数学或写代码。
DeepSeek-V3 改了路由问题的哪一面
DeepSeek-V3 更适合被读成一次成本工程:671B 参数里每 token 只激活 37B,于是你为 671B 的容量付出约 37B 的每 token 算力。稀疏度是极端的(激活占比约 5.5%),这让 Switch 用辅助损失压住的负载均衡问题变得尖锐:一旦路由器偏宠少数专家,另外 95% 的容量就白买了。
免辅助损失的方案是这篇论文的标志,值得精确理解,因为它反转了通常的权衡。辅助均衡损失确实能拉平负载,但它和主训练目标打架,悄悄拉低质量。DeepSeek-V3 的做法是调路由计算里的每专家偏置项来推动均衡,完全不引入竞争性的损失项。专家保持忙碌,而不再向质量征税。围绕这一点,V3 还配了两个效率原语:多头隐注意力(MLA)压缩推理 KV 缓存,多 token 预测让监督更密并支持投机解码。
头条数字是账单:14.8 万亿训练 token,278.8 万 H800 GPU 小时,按报告假设的每卡时 2 美元约 560 万美元,换来在许多基准上打平领先闭源系统的模型。在 V3 之前,「前沿水平需要闭源实验室的预算」是行业里不言明的前提,V3 让这个前提看起来可以商量。而且由于 DeepSeek-R1 就建在 V3 之上,这份效率直接支撑了那个震动闭源实验室的推理模型。
MoE 对 dense:你到底在交易什么
真正重要的对比不是参数量,而是约束条件:
- 每 token 算力。 MoE 赢得干脆:Mixtral 按约 13B 模型计费,DeepSeek-V3 按约 37B 计费,而容量属于远大于此的网络。流量大、算力是账单时,稀疏是 LLM 架构里最划算的交易。
- 显存。 MoE 输得干脆,这正是「跑得像个小模型」这句宣传藏起来的部分:所有专家必须常驻,因为路由取决于输入。Mixtral 要备 47B 权重,DeepSeek-V3 要备 671B。dense 模型浪费算力,从不浪费显存。
- 服务经济学。 大批量时各专家的负载在众多并发请求间自然摊平,每 token 成本逼近激活参数量,MoE 最划算;单流、延迟敏感的场景里,显存成本照付,吞吐红利却收不回来。
- 每美元训练质量。 Switch 证明了稀疏模型在固定算力下最快 7 倍到达既定质量;DeepSeek-V3 证明同一逻辑在前沿规模、低一个数量级成本下依然成立。
- 运维复杂度。 专家并行、负载均衡、token 丢弃(在 Switch 的设计里)、低精度下的路由不稳定,这些是真负担,dense 模型根本没有。
常见失效模式
三种反复出现。其一,路由器坍缩:没有均衡压力时,少数专家吞掉大量 token,其余闲置,容量论证整体蒸发。Switch 用辅助损失加容量缓冲来治,DeepSeek-V3 用偏置项来治,治的是同一种病。其二,显存错觉:因为每个 token 只动一小部分参数,人们以为 MoE 缩小了部署体积。并没有。Mixtral 要 47B 显存才能兑现 13B 的速度,且 MoE 算力赢得越狠,这个差距越大。其三,可解释性表演:Mixtral 和 Switch 的专家都不对应人类概念,路由是为性能学出来的,你无法借专家调试或引导模型。任何「选出数学专家」的说法描述的都是架构标签,不是观测到的行为。
局限与存疑
上表所有数字都来自各实验室自己的报告,评测口径互不可比:Switch 的加速是「到达同等质量的墙钟时间」对 T5;Mixtral 的胜利是 Mistral 自测、对手是 2023 年的模型;DeepSeek-V3 的成本数字建立在每卡时 2 美元的假设上,那是建模选择而非市价。也没有论文把 dense 和稀疏模型在同等总质量、同 harness、同训练成本下做对照实验,「MoE 更高效」目前建立在各家内部对比之上。另外激活参数只度量前馈路由:注意力走另一套经济学,DeepSeek-V3 还额外用 MLA 优化了它。
常见问题
什么是混合专家模型?
一种 Transformer 变体:每层的前馈网络被替换成许多并行副本(「专家」)加一个路由器。每个 token 到来时,路由器选出一个小子集的专家来真正计算,于是模型存下的参数远多于每 token 花掉的算力。三个经典例子:Switch Transformer(每 token 一个专家,1.6T 参数)、Mixtral 8x7B(8 选 2,47B 总量、约 13B 激活)、DeepSeek-V3(671B 中激活 37B)。
MoE 比 dense 模型更好吗?
按「单位算力的容量」算,更好,这就是全部意义,而且从 Switch 的 7 倍预训练加速到 DeepSeek-V3 报告约 560 万美元训出前沿级模型,一再成立。按显存算,更差:每个专家都必须常驻,47B 的 MoE 即便每 token 只动 13B,也得备 47B 显存。MoE 是算力上的便宜、显存上的负债;dense 正好相反。
Mixtral 为什么总量是 47B 而不是 56B?
因为 8 个专家只替换前馈块,注意力层是全体专家共享的。共享参数只算一次,总量就是 47B。同理,每 token 只有 2/8 的专家参与计算,且只在前馈路径,所以激活量约 13B。
为什么行业放弃了 Switch 的单专家路由?
Switch 证明了 k = 1 训得动、跑得快,但后来的系统还是回到每 token 至少两个专家(Mixtral 的 8 选 2)或一个小子集(DeepSeek-V3)。单专家路由是设计空间里最简单的点,不是质量最优点。真正留下来的,是「稀疏 = 不涨每 token 成本扩容」的框架和那条人人还在用的负载均衡路线。
DeepSeek-V3 不靠辅助损失是怎么做均衡的?
它通过调整路由计算中的每专家偏置项来摊平负载,而不是加一个和主目标竞争的单独损失。区别在于:辅助损失是用模型质量换均衡,偏置方案声称不付这笔税。
MoE 模型省显存吗?
不省。路由取决于输入,你预知不到一个请求会命中哪些专家,所有专家必须常驻。Mixtral 以 13B 级算力速度运行,但需要 47B 权重在显存里;DeepSeek-V3 的 37B 激活算力,对应 671B 的显存占用。MoE 是用显存换 FLOPs,方向和「跑得像小模型」的直觉正相反。