
Kimi K3、DeepSeek V4、Qwen3.8-Next 架构对比
四家 2026 前沿开源模型各用各的法子撑 1M 上下文:K3 用 Delta 注意力,V4 压缩 KV,Qwen 用 GDN,Nemotron 靠 Mamba-2 换吞吐。
快速结论
2026 年年中的四份重量级开源模型报告(Kimi K3、DeepSeek V4、Qwen3.8-Next 和 Nemotron 3 Ultra)回答的是同一个问题:上下文拉到一百万 token 之后,单 token 成本怎么压住?它们的付费点各不相同。Kimi K3 把大部分注意力层换成带遗忘门的 Delta 线性注意力,省下的预算砸向 896 个专家和智能体后训练;DeepSeek V4 保留注意力,但把 KV 缓存按 token 组压缩、再稀疏取 top-k;Qwen3.8-Next 走得最激进,激活参数只有 6B,另加 51B 放在主机内存里的 n-gram 表;Nemotron 3 Ultra 用 Mamba-2 层把解码成本压成常数,吞吐最高报 5.9 倍,代价是让出几个准确率点。四份报告都不约而同把大部分权重矩阵交给 Muon 优化器,优化器之争在前沿模型这里基本落幕了。
关键数字
以下每行数字均出自各家自己的技术报告和自家 harness,跨模型对比请按「同名基准、不同口径」理解。
| 维度 | Kimi K3 | DeepSeek V4 | Qwen3.8-Flash-Next | Nemotron 3 Ultra |
|---|---|---|---|---|
| 总参 / 激活参 | 2.78T / 104.2B | Pro 1.6T/49B,Flash 284B/13B | 125B / 6B(另加 51B 主机内存 n-gram 表) | 550B / 55B |
| token 混合结构 | 每 3 层 KDA 配 1 层门控 MLA | CSA 与 HCA 交替,外加滑窗与 attention sink | 每 3 层 GDN 配 1 层注意力,继续预训练时换成 QSA | 以 Mamba-2 层为主,少数注意力层(64 Q 头 / 2 KV 头) |
| 效率招牌 | 对 K2 约 2.5× 缩放效率(拟合缩放律) | V4-Pro 在 1M 上下文下为 V3.2 的 27% FLOPs、10% KV;Flash 为 10% / 7% | 训练 FLOPs 约为 Qwen3.7-Plus 的 1/9,激活参数与训练 token 各约 1/3 | 8K 入 64K 出解码场景吞吐为 GLM-5.1 的 5.9×、Kimi-K2.6 的 4.8× |
| 长上下文 | 1M 训练上下文;AA-LCR 74.7(表内最佳) | MRCR 1M 83.5、CorpusQA 1M 62.0(落后 Opus-4.6 约 9–10 分) | QSA 下 RULER 512K–1M 93.00,全注意力 90.08 | RULER 1M 94.7(表内最佳) |
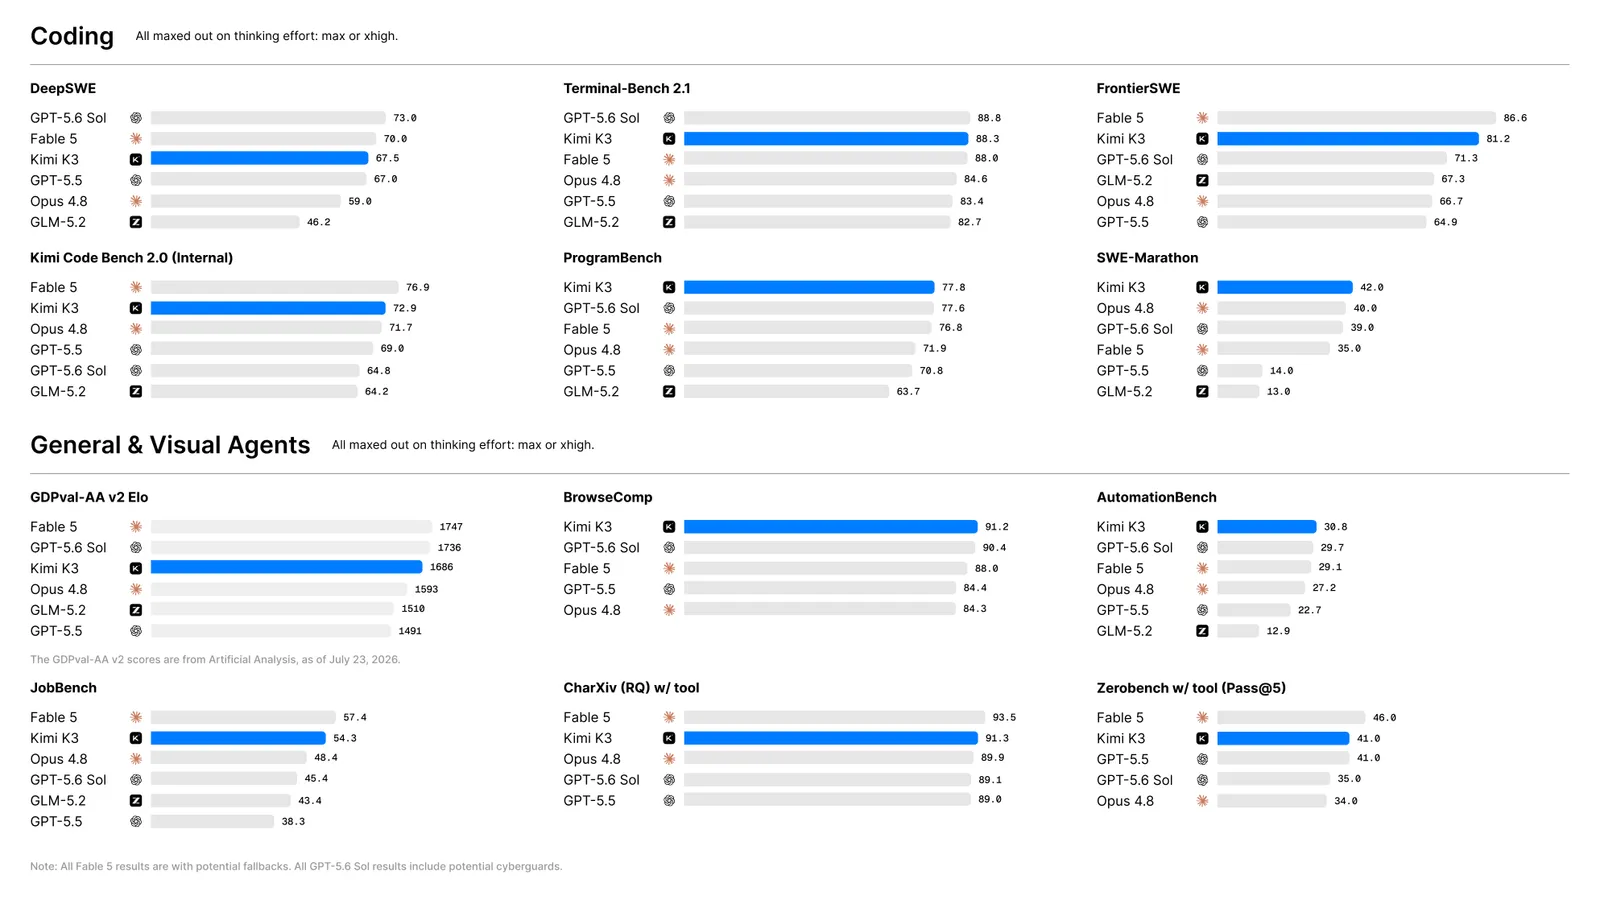
| 编码 / 智能体招牌 | Terminal-Bench 2.1 88.3、BrowseComp 91.2(均表内最佳) | V4-Pro-Max:SWE Verified 80.6、LiveCodeBench 93.5、Codeforces 3206 | 无后训练结果;基座 MMLU-Pro 73.23 对 Qwen3.7-Plus 70.90 | SWE-Bench Verified 70.7、Terminal Bench 2.1 56.4(落后开源同侪 5–17 分) |
| 诚实度 | 对照闭源模型打 max effort,部分智能体数字用 Kimi 自家 harness | 自称 preview;闭源基线跑在 DeepSeek harness 里 | 是架构消融报告不是模型卡,组件结论来自 25B-A3B 规模实验 | 吞吐为 NVIDIA 自家硬件最大吞吐口径;预训练两次发散,token 缩减到 20T |
有两个被引用最多的数字其实最不可直接比较。Qwen 的「1/9 FLOPs」是从参数比和 token 比推出来的,不是两份训练各自报告的总算力;Kimi 的「2.5× 缩放效率」是对自家 K2 拟合缩放律的结果,报告自己也把功劳记给数据和配方而非单一结构。DeepSeek 的 27% / 10% 是 FP8 等效 FLOPs 估算和缓存尺寸,不是实测延迟;Nemotron 的 5.9× 是开启投机解码、每个基线取最优配置的吞吐测量。
四种设计差在哪
压缩的对象不同。 三个线性注意力模型压缩的是「前缀」:K3 的 Kimi Delta Attention 给 Delta 规则递推加逐通道遗忘门,让固定大小的状态可以覆盖旧内容而不是无限累加;Qwen 的 Gated DeltaNet 干同样的活,但每四层保留一层全注意力,保住精确检索;Nemotron 的 Mamba-2 层让单步解码成本与序列长度无关。DeepSeek 压缩的则是「缓存」:相邻 token 合并成单条 KV(CSA),HCA 层合并得更狠,再用 Lightning Indexer 让每个 query 只 attend top-k 压缩项。一句话概括路线之争:「靠门控遗忘」对「全保留、但存得更小、查得更快」。
省下来的预算花在哪。 K3 花在规模和深度上:Attention Residuals 让每个块读前面所有块的摘要,896 专家 Stable LatentMoE 每 token 激活 16 个;DeepSeek 花在训练量上,32–33T token,再用流形约束超连接稳住深层堆叠;Qwen 花在反方向上,51B 的 n-gram 表放主机内存按需预取,于是 125B 总参、6B 激活的模型在 14 项预训练基准里 8 项赢过 397B-A17B 的上代;Nemotron 花在服务经济学上,一份 NVFP4 权重同时服务 W4A16 与 W4A4,两个共享权重的多 token 预测头既是投机解码草稿器也是 RL rollout 加速器。
各自让出了什么。 K3 的 AttnRes 只在每 12 层一个块摘要上跑,报告说「恢复了大部分收益」,「大部分」三个字很承重。V4-Pro 在 1M 召回上仍落后 Opus-4.6 九到十分,效率卖点是单位 token 成本而不是召回持平。Qwen3.8-Next 的论文没有任何后训练和智能体数字,端到端价值尚待验证。Nemotron 的预训练两次发散、token 目标被迫砍到 20T,专家失衡和残差流范数失衡被记录在案但原因未定位,招牌基准上落后最强开源模型 5–17 分。
怎么选
- Kimi K3:负载以智能体与浏览为主就选它:自家表内 BrowseComp 91.2、MCPMark-Verified 94.5、Terminal-Bench 2.1 88.3 都是最佳,还是首个登顶 WebDev Arena 的开源模型;代价是 2.8T 参数的服务 footprint。
- DeepSeek V4-Pro:百万上下文下的编码与推理负载选它,SWE Verified 80.6、LiveCodeBench 93.5,单 token FLOPs 只有 V3.2 的 27%;预算再紧一档就 V4-Flash,13B 激活、GPQA 88.1。
- Qwen3.8-Next:当训练预算压倒一切时作为架构参照:受控消融里 GDN 混合 53.81 对全注意力 49.87、滑窗混合 51.15,QSA 还反向提升了长上下文召回(93.00 对 90.08),说明稀疏注意力不必拿召回换成本;但作为模型选择,要等后训练数字。
- Nemotron 3 Ultra:服务经济学说了算时选它,8K 入 64K 出解码吞吐 5.9× 于 GLM-5.1、4.8× 于 Kimi-K2.6,RULER 1M 还是表内最佳;能接受 SWE-Bench Verified 和 BrowseComp 上 5–17 分的差距就行。
局限与存疑
目前没有任何第三方把四个模型放进同一 harness,各家对「效率」的度量口径也互不相通:FLOPs 估算、拟合缩放律、推导比例、服务吞吐,彼此不可换算。上表跨模型行只能共享基准名、不能共享口径;即使在同一份报告内,harness 选择也在起作用(Kimi 的智能体数字用 Kimi Code 跑,DeepSeek 表 6 用 512K 上下文 500 步交互,NVIDIA 给每个基线调了不同的服务配置)。Muon 四家用法各异(按头正交化、门控残差、mHC、NVFP4 回滚配方),说明「大家都在用 Muon」不等于训练稳定性问题已被解决。
常见问题
Kimi K3 和 DeepSeek V4 哪个更好?
按各自报告的表:K3 在智能体与浏览类领先(BrowseComp 91.2 对 V4-Pro-Max 83.4;Terminal-Bench 上 K3 是 2.1 版 88.3,最接近可比的 V4 行是 2.0 版 67.9),V4-Pro-Max 在编码类领先(LiveCodeBench 93.5),K3 又在 GPQA Diamond 上以 93.5 对 90.1 反超。数字出自不同 harness,看差距方向别看具体分差。
Qwen3.8-Next 的稀疏注意力和 DeepSeek V4 的压缩注意力,1M 上下文上谁更强?
报告各说各话:DeepSeek 的压缩路线理论上保留全检索,但 V4-Pro 的 MRCR 1M 只有 83.5,落后 Opus-4.6 的 92.9;Qwen 的数据反过来证明稀疏能提升召回(93.00 对 90.08);Nemotron 的 Mamba 重栈 RULER 1M 拿到表内最佳 94.7,推理分却掉队。诚实的结论是:一百万 token 上每个设计都会丢掉点什么,丢什么取决于你选择压缩哪些层。
为什么 Nemotron 3 Ultra 用 Mamba-2,而 Kimi K3 和 Qwen3.8-Next 用 Delta 注意力?
三者都是固定状态、单步常数成本的 token 混合器,但赌注不同:KDA 的逐通道遗忘门让状态可以覆盖旧内容,Gated DeltaNet 在 3:1 交错里干同样的活,而 Mamba-2 的 SSM 缓存在同等 batch 与长度下远小于 FP8 KV 缓存,Nemotron 的 5.9× 吞吐正是从这里来。代价也写在分数里:两个 Delta 注意力模型保留了注意力层做精确检索,Nemotron 的表却在推理基准上落后最强开源模型 5–17 分。
为什么四个模型都用 Muon 优化器?
各家的结论独立收敛到同一处:DeepSeek 称其为迄今披露的最大规模 Muon 预训练,K3 按注意力头分别正交化,Qwen 发现 Muon 会搞坏 MoE router 于是 router 留在 AdamW,Nemotron 则把它和 NVFP4 课程表绑在一起。共识是收敛速度和稳定性,但没有任何一家声称结果只靠优化器。
四个里面哪个训练和服务最便宜?
按各家自己的记账方式:Qwen3.8-Flash-Next 称训练 FLOPs 约为上代的 1/9、激活参数仅 6B;Nemotron 3 Ultra 称在 NVIDIA 硬件上解码吞吐为 GLM-5.1 的 5.9 倍;DeepSeek V4-Pro 称 1M 上下文单 token FLOPs 为 V3.2 的 27%;K3 激活参数最大(104.2B)。这是四种不同的「便宜」,目前不存在统一度量。