
四个基准问的是同一个问题
静态 agent 基准一个接一个饱和,评测的难点已经变了:不再是「agent 能不能把活干成」,而是「任务不配合的时候会发生什么」。2026 年 5 月底到 6 月初的两周内,四个基准从四个不同方向攻这个问题,另有一篇机制分析论文垫底。合起来,它们比任何单一榜单数字都更能说明 agent 的真实鲁棒性。
四个压力轴分别是:任务中途才暴露的约束(AdaPlanBench)、用到一半坏掉的工具(ToolMaze)、比训练分布更难的合成任务(TASTE 及其 τᶜ-Bench)、以及非英语语境的网络问答(K-BrowseComp)。机制论文问的是:搜索 agent 的上下文越来越长时,屏蔽过期观测到底什么时候有用、什么时候有害(过期观测屏蔽研究)。
每个基准都 isolate 了一种演示里看不到的失败模式:漂亮的 demo 里,agent 工具好使、问题用英语、计划一次成型;真实部署里这三样一样都不保证。
AdaPlanBench:压力来自不断累积的约束
AdaPlanBench(COLM 2026)从家务规划任务出发,用一种特定方式把它们变得「对抗」:307 个任务每个都加了双重约束:世界约束(环境允许什么)和用户约束(用户真正要什么)。agent 事先看不到约束,先提计划,计划撞上隐藏约束才收到反馈,然后在反馈不断累积中反复修改。
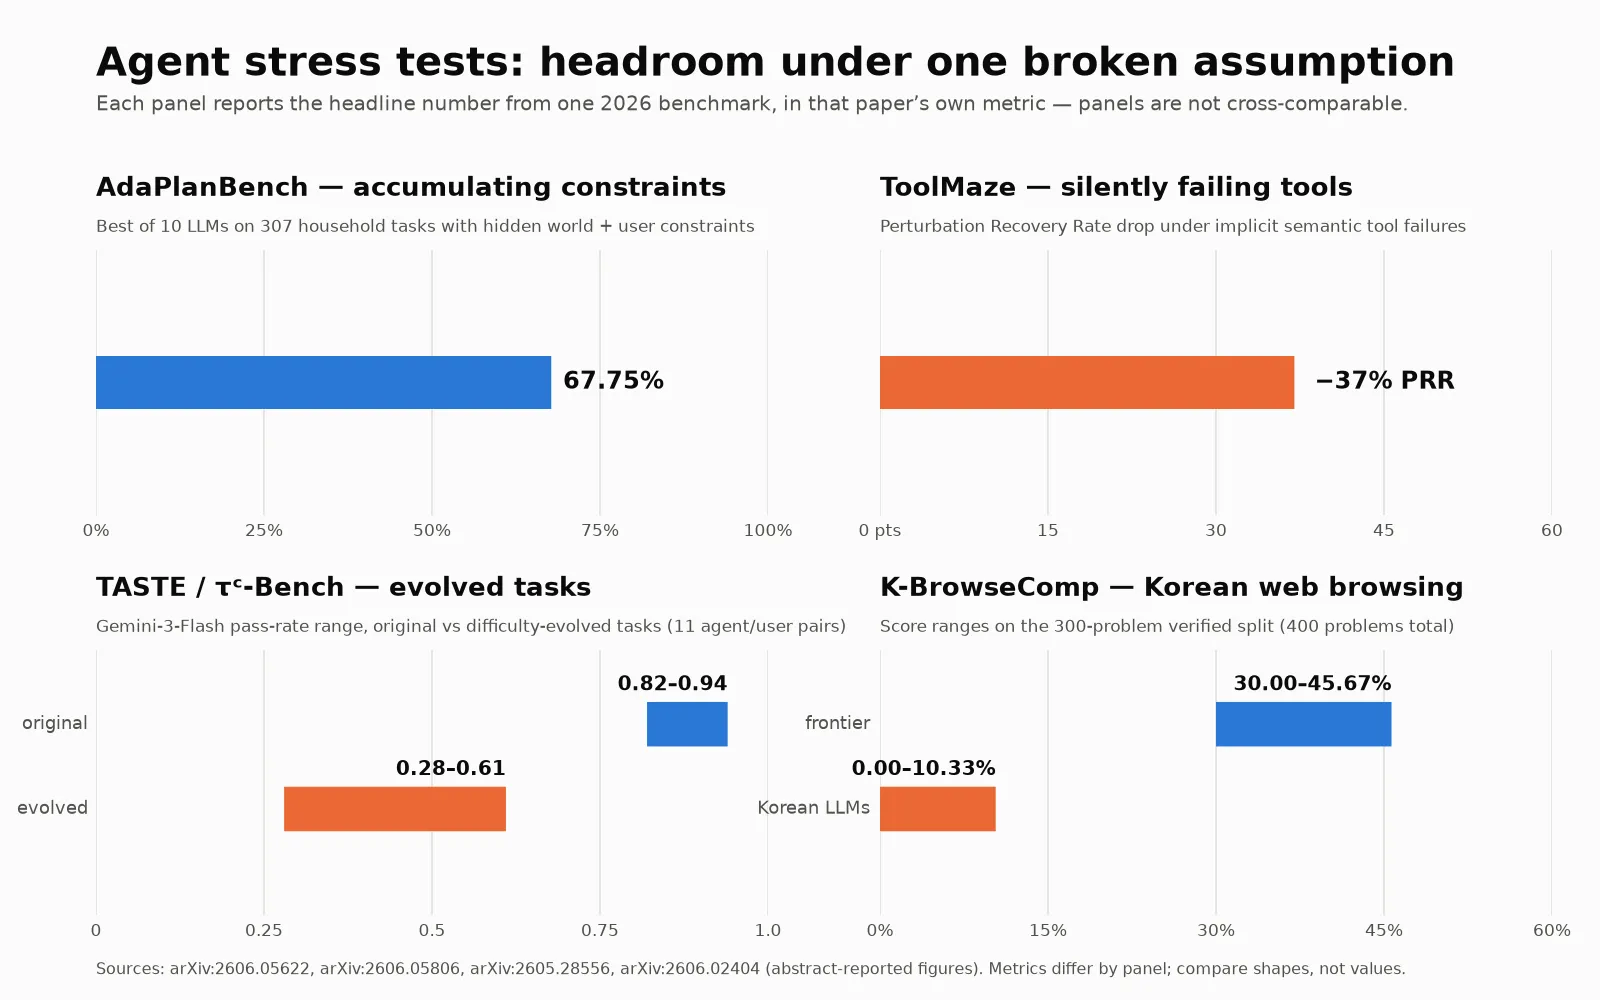
这个协议重要,因为它还原了产品里计划真正的失败方式:需求是在执行中冒出来的,不是事前给全的。作者用这个循环测了 10 个头部 LLM,最好模型的准确率是 67.75%。核心发现是方向性的:约束越积越多,成绩越掉;用户约束比世界约束更难;失败集中在物理 grounding 偏弱的地方:模型能背规划理论,但记不住一个家居环境里到底允许什么。
值得引用的就是这个 67.75% 的天花板:家务任务、反馈免费送上、只测了十个模型,最好成绩才三分之二,离「agent 会规划」还差得远。如果你的产品里用户会临时改主意,这个基准是目前最接近的压力替身。
ToolMaze:压力来自坏掉的工具
ToolMaze 反过来了:别的 agent 基准给 agent 好使的工具,它给 agent 一套 2×2 的工具扰动分类法,测工具在任务中途坏掉时会发生什么,任务本身的 DAG 复杂度也各不相同。指标是扰动恢复率(PRR):工具坏了之后,agent 能不能发现、诊断、重新规划?
两个发现撑起了这篇论文。第一,最大的跌幅来自隐式语义故障:工具不报错,而是返回错但看似合理的结果。工具大声报错时,agent 能恢复;工具悄悄出错时,PRR 掉约 37%。第二,规模救不了恢复能力:作者报告 agent 的容错能力随模型规模提升的速度,比基础执行能力慢约 3.66 倍。模型越大,Happy path 上的进步越快,失败路径上的进步越慢,这意味着鲁棒性缺口是随能力变宽,而不是变窄。
如果你的 agent 要调外部 API、爬虫、或者用户自己提供的工具(任何可能返回过期、残缺、错误数据而不抛异常的东西),ToolMaze 对「响亮失败」和「沉默失败」的区分,是这一组里最可直接落地的一个洞见。
TASTE 与 τᶜ-Bench:压力来自比基准更难的题
TASTE 打的是另一个问题:agent 基准是静态的,模型会对它过拟合。作者不是手写更难的题,而是生成题:先采样工具调用序列,再聚类、实例化成候选任务,最后用一个带 LLM 有效性判别的自适应对比 n-gram 模型做迭代难度进化。产出是 τᶜ-Bench,建在 三个 τ²-Bench 领域之上,合成任务的唯一工具组合数比原领域多出一倍以上。
评测落点在 11 组 agent/用户 LLM 配对上:在进化后的任务上,Gemini-3-Flash 的通过率从 0.82–0.94 跌到 0.28–0.61。一个标准任务能过九成、进化任务过不了三成的模型,面对的领域和工具名义上是同一套。这就是「刷榜」问题的答案:如果你怀疑厂商的数字是调可见任务调出来的,TASTE 这条合成管线就是重新制造压力的办法。
注意 TASTE 没声称什么:它不声称进化任务更「真实」,它声称进化任务更抗覆盖,而 0.82 到 0.28 的塌方量化了「看起来会」里有多少其实坐在任务熟悉度上。
K-BrowseComp:压力来自非英语的地面真值
K-BrowseComp 把网络浏览 agent 放进韩语语境。共 400 题:300 题验证集由母语者手工构建核对,另有 100 题合成集,用困难少样本加失败定向生成,单独发布当压力测试。
结果同时击穿两个舒服的假设。前沿模型(论文点了 GPT-5.5、DeepSeek-V4-Pro、GLM-5.1 的名)在验证集上只有 30.00–45.67%,远低于它们在英文 BrowseComp 上的成绩;而韩国本土基础模型计划的 LLM 得分 0.00–10.33%。对抗过滤合成集上最好的前沿模型也只有 26.00%。数据和代码全部公开。
这个基准教训不限于韩语:用英语测出来的 agent 能力,不能干净地迁移到其他语言;「能上网」也不是语言中立的技能:检索、读页、核验答案,全都随地面真值离开英语而退化。任何要在非英语市场部署 agent 的团队,这是发现「英语数字里有多少是语言运气」的最便宜办法。
关键数字
| 基准 | 压力轴 | 规模 | 头部数字 |
|---|---|---|---|
| AdaPlanBench | 迭代反馈中暴露的隐藏世界约束+用户约束 | 307 个家务任务,10 个 LLM | 最好模型 67.75%;约束越积成绩越掉,用户约束最难 |
| ToolMaze | 任务中途的工具失效,响亮与沉默两种 | 2×2 扰动分类法 | 隐式语义故障下 PRR 跌约 37%;容错随规模提升比执行慢 3.66 倍 |
| TASTE / τᶜ-Bench | 比原基准更难的合成任务 | 3 个 τ²-Bench 领域,11 组 agent/用户配对 | Gemini-3-Flash 通过率 0.82–0.94 → 0.28–0.61;唯一工具组合数翻倍以上 |
| K-BrowseComp | 韩语语境的网络浏览 | 400 题(300 验证 + 100 合成) | 前沿模型验证集 30.00–45.67%;韩国 LLM 0.00–10.33%;合成集最好 26.00% |
这张表是四个一维切面,不是排名。没有模型同时出现在四个榜上,没有共用 harness,指标(准确率、恢复率、通过率、答题准确率)之间不可换算。可比的是发现的形状:每挪一个环境变量,agent 坏掉的程度都远超模型卡数字给人的预期。
为什么说过期观测屏蔽是那篇机制论文
屏蔽研究解释了 agent 在压力下退化的部分机理。长程搜索 agent 不断积累检索观测,上下文里过期信息越来越多。作者在 4B 到 284B 的模型和三个检索器上测试了屏蔽过期观测,发现一条不对称倒 U:检索器弱时屏蔽几乎没用;强检索器配中等容量模型时收益见顶;模型饱和时屏蔽反而崩塌,开始帮倒忙。
机理是检索召回和模型隐式过滤的相互作用,作者把屏蔽叫做 token 换回合的权衡:用可能还有用的 token,换几回合新鲜上下文。和四个基准的关系是直接的:AdaPlanBench 的 agent 被累积的约束反馈淹没,ToolMaze 的 agent 必须让「工具已失效」这个状态保持显著,K-BrowseComp 的 agent 要在多语言页面间腾挪:每一个说到底都是上下文管理问题,而这篇论文把「上下文修剪什么时候开始不免费」画了出来。
四个基准的共识
三条结论在四篇论文里反复出现。第一,执行不是恢复:Happy path 上 agent 得分远高于任何扰动下的得分:免费反馈下 67.75%、进化任务上从 0.82 以上塌到 0.28、前沿模型的英文浏览成绩落到韩语的 30–45%。第二,失败是沉默的:最大的跌幅来自隐式语义故障和陌生但貌似合理的任务,而不是 agent 能绕开的响亮报错。第三,规模不是鲁棒性:ToolMaze 的 3.66 倍差距说明能力长得比容错快,所以更大的模型可以同时更惊艳、更脆弱。
怎么选
- 用户会中途改需求,或环境有隐藏规则:AdaPlanBench 的约束暴露协议是最接近的现成设计,67.75% 的天花板就是校准点。
- agent 依赖可能悄悄失效的外部工具:ToolMaze 响亮/沉默失败的区分是设计要点,隐式故障下约 37% 的 PRR 跌幅是要打败的数。
- 怀疑刷榜,无论来自厂商还是自己的训练循环:TASTE 的合成管线展示了怎么重新制造任务压力,0.82–0.94 到 0.28–0.61 的塌方就是警告。
- 在非英语环境部署:K-BrowseComp 的 30.00–45.67% 对 0.00–10.33% 量化了英文 agent 数字能迁移多少,通常不到一半。
- agent 长程运行、检索上下文不断增长:上线任何剪枝策略前先跑屏蔽消融;倒 U 曲线说明答案同时取决于检索器强度和模型容量,单独看哪一样都不够。
局限与存疑
五篇论文都很新(2026 年 5–6 月),被测模型代际会很快过时,可留下的是协议。四个基准之间没有共用模型、harness 或指标,所以不存在同口径对比,任何横跨四榜的「agent 鲁棒性综合分」都是造出来的,不是测出来的。AdaPlanBench 的家务域和 ToolMaze 的 DAG 任务是合成环境,能否迁移到开放工作尚未证明;TASTE 的进化任务用真实性换了抗覆盖性,τᶜ-Bench 低分本身不证明模型在底层领域不行;K-BrowseComp 只覆盖一种语言,其合成集 26.00% 的天花板有一部分来自对抗过滤而非纯难度。屏蔽研究是分析不是基准,4B–284B 的扫描不保证倒 U 在更大规模或更新检索管线下仍成立。最后,四个基准的任务池一旦被吸进训练数据,原则上都能被刷;TASTE 的合成管线是这一组里对这个问题唯一给出的答案。
常见问题
第一个该用哪个 agent 压力测试基准?
按你最主要的失败模式选,不是按哪个数字好看选。任务中途冒约束指向 AdaPlanBench;工具不可靠指向 ToolMaze;怀疑刷榜指向 TASTE;非英语部署指向 K-BrowseComp。如果真不知道失败模式在哪,从 ToolMaze 起步最便宜,因为沉默的工具失效是 demo 和生产之间最常见的缝。
AdaPlanBench、ToolMaze、K-BrowseComp 的分数能直接比吗?
不能。模型、harness、任务规模、指标全不同:67.75% 的准确率、约 37% 的 PRR 跌幅、30.00–45.67% 的答题准确率,换算不成同一个鲁棒性分数。要比的是发现的形状(agent 到处都更擅长执行、不擅长恢复),不是数字本身。
这组里最意外的数字是哪个?
两个候选。TASTE 里 Gemini-3-Flash 从 0.82–0.94 塌到 0.28–0.61,说明「看起来会」里有多大比例坐在任务熟悉度上;ToolMaze 的 3.66 倍则说明容错随规模长得比执行慢,鲁棒性缺口是随模型变大而变宽的。
这些基准能不能证明现在的 agent 不能用?
不能。它们证明的是 agent 很不均匀:首轮执行强,恢复、扰动处理、分布偏移、非英语地面真值弱。AdaPlanBench 的最好模型仍能过三分之二带约束的任务,K-BrowseComp 的前沿模型仍能答对三成到一半的韩语浏览题。要针对性工程化的是这种不均匀,不是平均值。
这四个之后,agent 评测往哪走?
走向合成与轮换:TASTE 的管线是目前最清晰的模板:比模型吸收速度更快地重新生成任务压力;屏蔽研究补上了四个基准都擦到但没展开的上下文维度。下一代基准大概率会把多个压力轴叠进同一个环境:约束暴露、工具失效、非英语检索同时存在。