
科学智能体对比:Eywa、LabVLA、Crafter 各管哪一段
三篇各管科研一段:Eywa 调领域模型(0.6154→0.6558),LabVLA 实验室跑协议(分布内 71.1%),Crafter 出可编辑图(同底座 50.34 对 11.13)。
问题:agent 在实验室里到底该干什么?
「AI for science」常被当成一件事来谈,俗称「AI 科学家」。这三篇 2026 年的论文要精确得多:每篇只认领科研流程的一个环节,只为那个环节造专用机器,也只报那个环节的数字。Eywa 管对科研数据的推理:时间序列、表格、领域记录,这些信号一旦被压平成提示词就会丢信息。LabVLA 管物理执行:把书面的实验协议变成机器人轨迹。Crafter 管沟通的一个切面:产出审稿人提完意见后人类还能改的科学图表。三篇都不回答「下一步该做哪个实验」,那是它们头顶上一层的事,属于 EurekAgent 这类做环境工程的系统。
真正的看点是三篇共下的同一个赌注:全部冻结一个够用的通用模型,把力气花在模型外面的接口上,分别是一条学到的基础模型连接、一个批量造训练数据的仿真引擎、一份五个 agent 反复协商的类型化规格。没有一个头名数字是靠换更大的基础模型换来的。
Eywa:推理层
Eywa 从一个多数 agent 框架跳过的事实出发:LLM agent 把一切都当文本读,所以 500 点的时间序列、宽表医疗数据,得先序列化成 token 才能被模型看见。论文把它形式化成「语言接口瓶颈」,并用信息论上界(Proposition 13)和一个严格的最优风险定理(Theorem 3)论证:光是序列化这一步,就给纯语言 agent 的能力封了顶。
机器本身是一条 LLM 与领域基础模型之间的学习连接,作者取名 Tsaheylu,三段结构:查询编译器把 agent 当前状态翻译成领域模型可运行的配置,响应适配器把数值输出转回语言可用的表示,控制策略先判断这次调用划不划算。领域模型通过 MCP 暴露成远程服务,论文里接入的是 Chronos(时间序列)和 TabPFN(表格)。框架分三级:EywaAgent(一个 LLM 加一个基础模型)、EywaMAS(固定拓扑的多 agent)、EywaOrchestra(由指挥器按任务挑选 agent 类型、模型和拓扑)。
全部评测在 EywaBench 上,它由 DeepPrinciple、MMLU-Pro、fev-bench、TabArena 组成,覆盖 9 个科学子领域、三种模态,统一打 0 到 1 的效用分。单 agent 变体把总效用从 0.6154 抬到 0.6558,同时少用约三成 token、延迟低约一成。EywaMAS 拿到 0.6761,高过同构的辩论式基线 0.6294;EywaOrchestra 以 0.6746 几乎追平,成本却从多 agent 版的 11,214 token、72.11 秒降回 8,335 token、48.16 秒。诚实的地方在分领域数字:社会科学 0.7488、物理 0.6914,生命科学只有 0.5001,这套方法救不了所有领域。全程用的是小模型(gpt-4.1-nano、gpt-5-nano、gpt-5-mini),基准跑得便宜,也把「前沿模型上还剩多少差距」留成了开放问题。
LabVLA:手
LabVLA 的赌注是:实验室机器人首先是数据问题,其次才是模型问题。家用 VLA 策略学的是杯子和桌面;实验室里有协议、透明液体,还有动作顺序错了整个实验就作废的任务。所以论文先造 RoboGenesis:一个仿真与数据引擎,支持 16 种机器人平台、含 2,947 个资产的 LabAssetLibrary、10,000 个生成的实验室场景、六轴域随机化,只导出成功的轨迹并附结构化标注。
模型侧把 Qwen3-VL-4B-Instruct 主干(FAST 动作 token 预训练使其具备动作意识)接到一个 flow-matching DiT 动作专家上,并用一条 stop-gradient 路径(作者称知识绝缘)挡住动作损失对主干语言视觉知识的破坏。LabUtopia 上,六个实验室任务的平均成功率为分布内 71.1%、分布外 70.0%,比次优策略 pi0 高出 7.8 和 6.8 分,分布内到分布外只掉 1.1 分。任务拆分就没那么好看:按按钮(ID)100%,倒液体只有 43.3%(ID)和 34.2%(OOD),且该仿真列上没有一个基线超过 50%。真机研究把四个任务迁到 Franka 平台,每个设定 50 次 rollout,大致落在 76% 到 92% 区间,但 DreamZero 或 pi0.5 在部分行上追平甚至反超,仿真里的领先不自动带到实验台上。
Crafter:嘴
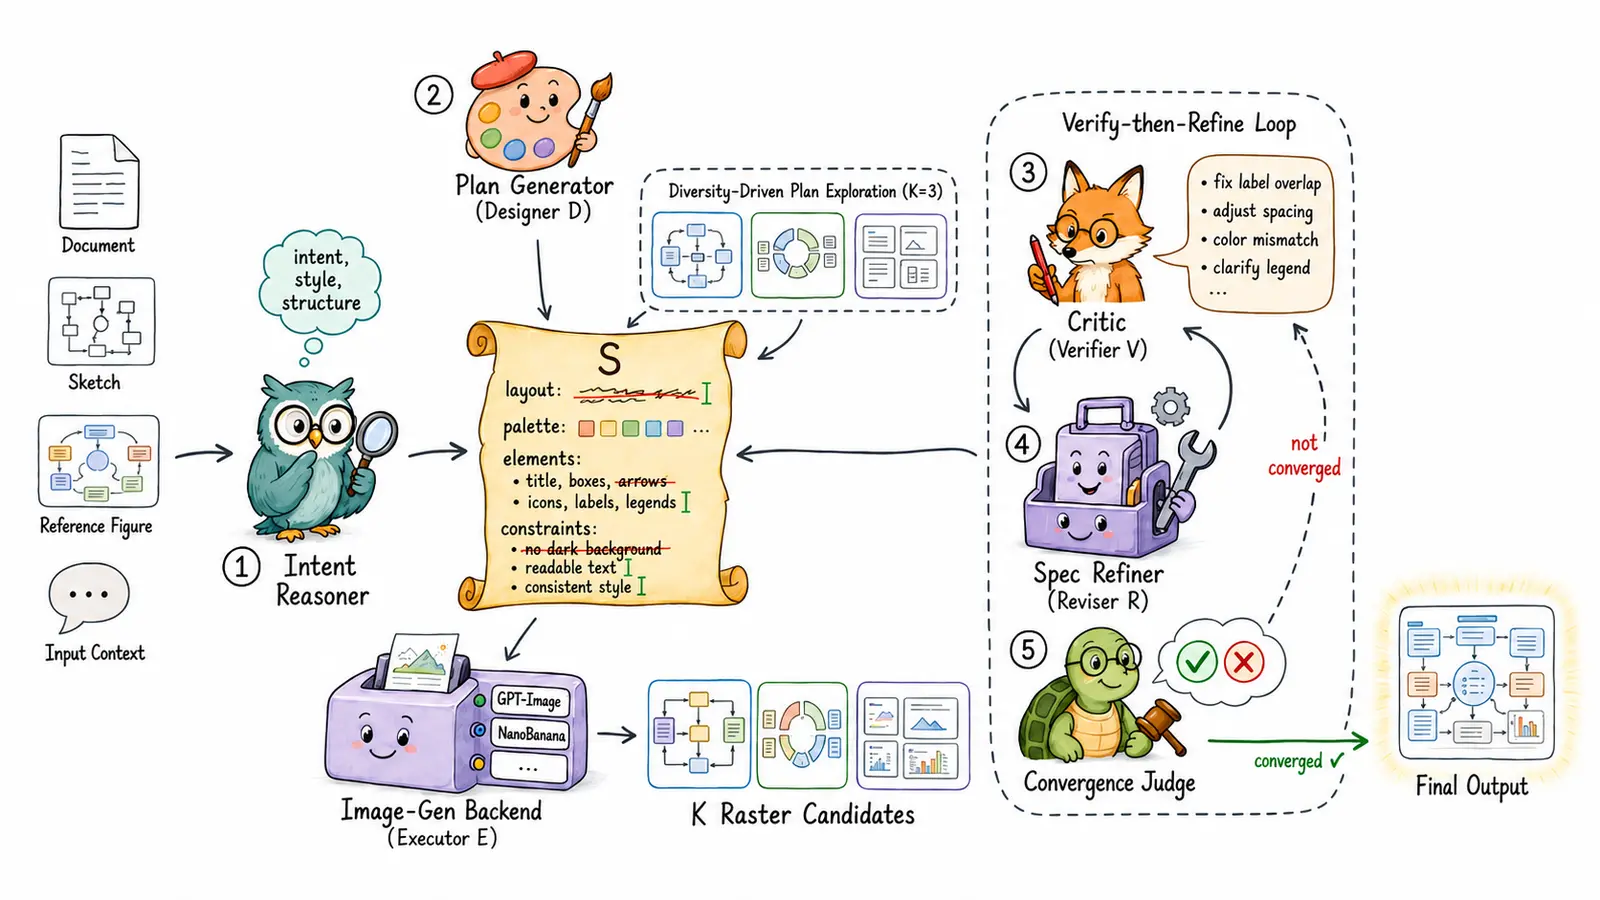
Crafter 把科学图表当成结构化状态,而不是一句提示词。五个 agent 在一份共享的类型化规格上循环:Intent Reasoner 从文本、草图或半成品图表里抽出初始规格;Plan Generator 一次提多种视觉框架;Critic 按维度(位置、颜色、文字、布局)返回可操作的具体批评,而不是一个「7 分」的标量;Specification Refiner 把修改写回规格;Convergence Judge 决定收稿、再改还是回滚。因为 agent 协商的对象是规格而不是像素,同一套 harness 不改架构就覆盖三种图型、四种输入条件,包括遮罩补全和草图精修。
数字把「harness 胜过换模型」的论点坐实了。PaperBanana-Bench 上 Crafter 得 50.34,PaperBanana agentic 基线 33.73,同一个 Nano Banana 2 底座单独跑只有 11.13,GPT-Image-2 仅 1.37。CraftBench 上领先最强 agentic 基线的幅度是 50.20 对 28.00。配套的 CraftEditor 把位图转成坐标忠实的可编辑 SVG,编辑保真度 8.04 分(满分 10),高于此前最好的 6.91;分轴看文字 7.61、箭头 7.83 最弱。两处保留让数字保持诚实:全部由三个 VLM 组成的评审团打分(80 个样本),且基准总分封顶在 50 分上下,按论文自己的口径这是「能用的草稿」,不是能投稿的成品。
三环在哪里交汇
三篇论文有三条共识。其一,harness 论点:每家的增益都来自包在冻结模型外面的结构(编译器-适配器-路由器、数据引擎加动作专家、五 agent 规格环),与规模无关。其二,天花板纪律:每家都报了自己系统仍失败的切片,Eywa 的生命科学 0.5001、LabVLA 的分布外倒液体 34.2%、Crafter 的文字轴 7.61,而不是把尾巴藏起来。其三,记账方式不同得很有意思:Eywa 按配置报 token 和延迟,LabVLA 用 rollout 计价(真机每设定 50 次),Crafter 每图的五 agent 循环成本恰恰是论文没摆在台面上的那个数。
分歧同样要紧。Eywa 的效用尺奖励 0 到 1 之间任何进步,LabVLA 的成功率是每次 rollout 过与不过,Crafter 的图由别的 VLM 评,容易奖励「看起来对」多过「真的对」。这是与读者的三份不同契约,团队做选择时,其实是在选哪份契约对自己的风险。
关键数字
| 维度 | Eywa(推理) | LabVLA(执行) | Crafter(沟通) |
|---|---|---|---|
| 环节主张 | 对时间序列、表格、领域数据的推理 | 实验室机器人上的协议执行 | 可编辑的图表、海报、信息图 |
| 头名数字 | 总效用 0.6558,纯 LLM agent 0.6154 | LabUtopia 平均成功率 分布内 71.1%、分布外 70.0% | PaperBanana-Bench 50.34(满分 100) |
| 同口径增益 | 效用更高,token 少约三成、延迟低约一成 | 比最佳基线 pi0(63.3/63.2)高 7.8 / 6.8 分 | 比同款 Nano Banana 2 底座单独跑(11.13)高 39 分 |
| 最弱切片 | 生命科学 0.5001 效用(分领域,gpt-5-nano) | 倒液体 43.3%(ID)/ 34.2%(OOD),无基线过 50% | CraftEditor 文字轴 7.61/10、箭头 7.83/10 |
| 效率档 | EywaOrchestra 0.6746 效用、8,335 token / 48.16 秒,对 EywaMAS 0.6761、11,214 token / 72.11 秒 | 分布内到分布外仅掉 1.1 分 | 每图五 agent 循环;成本未摆在台面 |
| 评审与协议 | EywaBench 统一 0 到 1 效用,9 子领域 3 模态 | LabUtopia 仿真 + 4 个 Franka 真机任务,每设定 50 rollout | 三 VLM 评审团,80 样本 |
| 包住的冻结部件 | Chronos 与 TabPFN(经 MCP) | Qwen3-VL-4B 主干 + DiT 动作专家 | Nano Banana 2 图像模型 |
三把不同的尺子:这张表把三篇论文的数字排在一起,但它们不共享基准、任务或评分契约,任何两列都不能直接互比。每列请对照各自的协议读,最后一行当成共同的设计模式来读,别当指标。
怎么选
- 瓶颈在读科研数据(信号、表格、领域记录):从 Eywa 的接口论证入手。如果你的 LLM agent 正在把数字序列化进提示词,论文的编译器-适配器-路由器拆法加上 0.6154 到 0.6558 的结果,展示了在不重训任何东西的前提下,一条学出来的连接能买到什么。
- 瓶颈在执行已知协议:LabVLA 是参照系。值得借的是配方(仿真引擎造数据、FAST 预训练、flow-matching 动作专家),1.1 分的分布内外落差展示了域随机化的收益;同时要为「倒液体级别」的任务仍未解决留好预算。
- 瓶颈在产出审稿人可改的图:直接上 Crafter。五 agent 规格环是框架形的而非模型形的,可以搬到别的图像底座上;CraftEditor 回答了所有生图流水线都在躲的问题:人之后到底怎么改。
- 三段都要:原理上可组合,Eywa 式 agent 规划、LabVLA 式执行器跑协议、Crafter 式产出做汇报。但三篇论文都没有演示这种组合,而且每篇都默认头顶有个人在指定该做什么科学。
局限与存疑
Eywa 的局限是结构性的:只接了两个基础模型、两种非文本模态;编排是在有限拓扑池里由 LLM 映射的指挥器挑选,不是学出来的策略;小骨干让人不知道,当前沿模型本身更擅长序列化数字时,这条接口还要不要。LabVLA 的真机证据只是一台机器人上的四个桌面任务,离湿实验室的透明液体、污染、标定漂移还很远,且基准完全抽象掉了科学判断。Crafter 的分数在三 VLM 评审下封顶在 50 分上下,五 agent 循环没计价,SVG 抽取最弱的地方恰恰是科学图最难的地方:文字和箭头。三篇共同留下的开放问题在它们头顶:当推理、执行、汇报各有趁手的 agent 之后,谁来验证这个实验本身值不值得做?
常见问题
Eywa、LabVLA、Crafter,哪个是最好的 AI 科学家?
哪个都不是,这正是有用的结论。Eywa 在科研数据推理上拿 0.6558 效用,LabVLA 分布内跑通 71.1% 的实验协议,Crafter 的图在自家基准上值 50.34 分(满分 100)。它们覆盖研究工作的三个不同环节,所以正确的问题是哪个环节卡住了你的工作流,而不是谁在榜单上赢。
Eywa 从 0.6154 到 0.6558 的效用提升,值得加这套机器吗?
在 EywaBench 上,单 agent 变体在少用约三成 token 的同时把效用从 0.6154 抬到 0.6558,同一基准上准确率和效率同向变好。保留意见在分领域:社会科学 0.7488,生命科学只有 0.5001,且全程用小模型。把这个均值当接口概念的证明可以,当生产保证不行。
LabVLA 的 71.1% 成功率意味着实验室机器人解决了吗?
没有。71.1% 是 LabUtopia 仿真里六个任务的分布内平均,论文自己最硬的一列,倒液体,只有 43.3%(ID)和 34.2%(OOD),且没有基线超过 50%。Franka 真机研究落在 76% 到 92% 区间,但 DreamZero 和 pi0.5 在部分行上追平甚至反超。这个结果支持受约束条件下的协议执行,不支持湿实验室自主。
Crafter 的 50.34 里,多少来自 agent,多少来自图像模型?
按论文自己的系统对照,几乎全部来自 agent:同一个 Nano Banana 2 底座单独跑 11.13,放进五 agent 循环后 50.34,图像模型没换,差出 39 分。基准封顶在 50 分上下、VLM 评审协议、CraftEditor 文字轴 7.61,这三条是这个主张诚实的边界。
想要 Eywa 多 agent 的收益又不想付 token,该跑哪档?
论文自己的对照给出了答案:EywaMAS 以 11,214 token、72.11 秒拿到 0.6761 效用;EywaOrchestra 用指挥器按任务选拓扑,以 8,335 token、48.16 秒拿到几乎相同的 0.6746。如果每 token 效用比最后 0.0015 的效用更要紧,论文指给你的就是编排档。