
ALE 对比 Pi-Bench:agent 能力缺口的两种测法
ALE 考交代的职业任务(1490 题,最难层级仅 2.6% 通过);Pi-Bench 考用户没说出口的意图(主动性最高 67.0%)。
两个榜问的是同一个问题,但一个数字答不了
每隔几个月就有厂商宣布自家 agent「能干活了」。2026 年有两个基准想把这句话变成可检验的命题,结论都是「还差得远」,但它们把失败定位在两个不同的地方,而这个差异正是把两个榜放在一起看的意义。
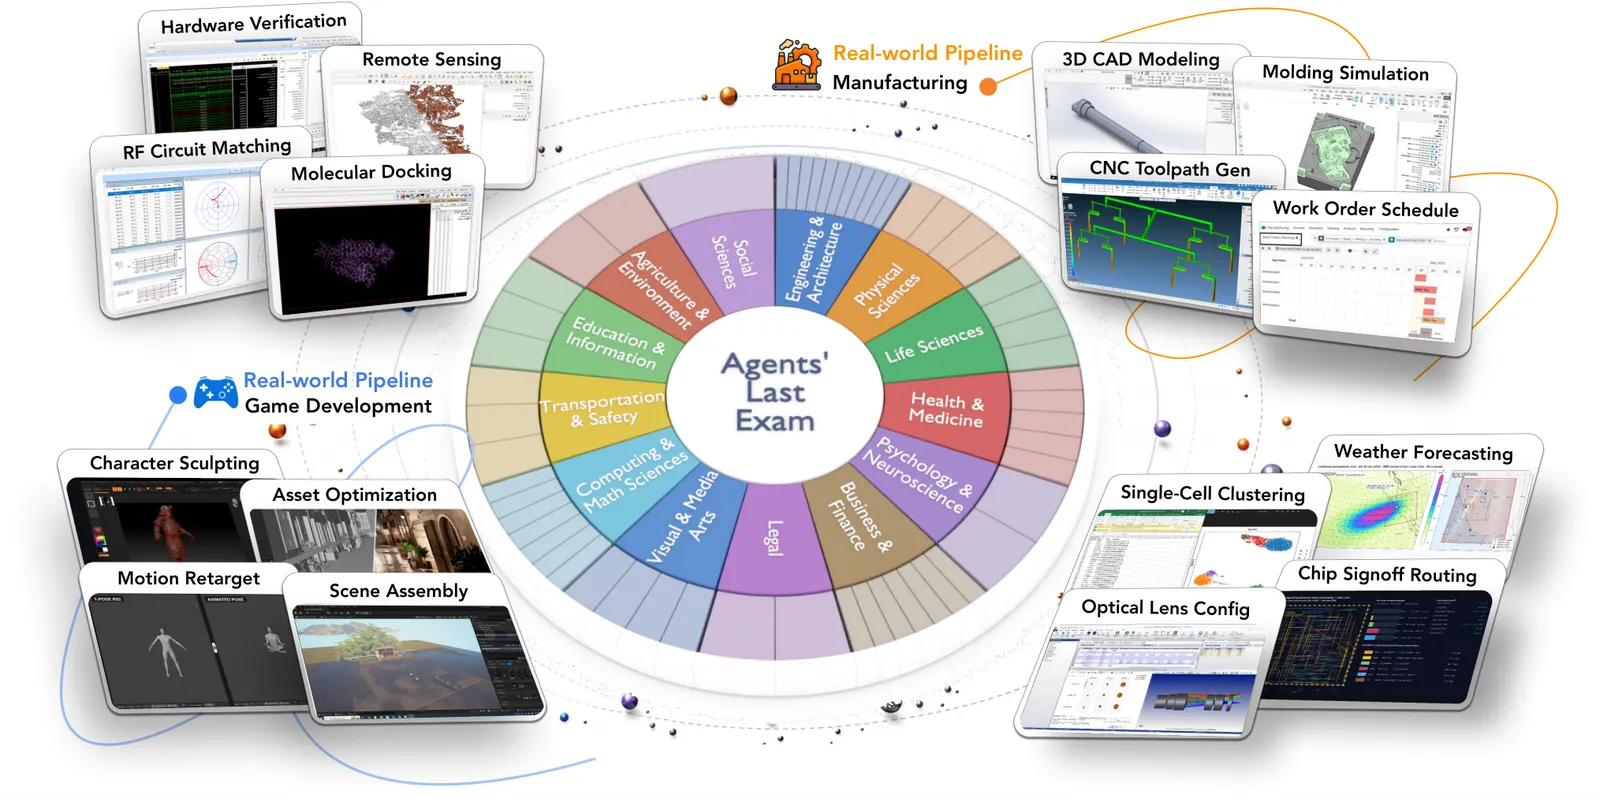
Agents’ Last Exam(ALE)测的是明确的任务:交给你一件有可验证交付物的职业工作,你能不能做出来?它由 960 个专家撰写的工作流、覆盖 55 个数字行业的 1490 道任务实例构成。Pi-Bench测的是隐含的意图:用户明面上只要了一件事,但一个好助理应该会主动处理几件用户从未说出口的事,agent 注意到了吗?它由 5 个职业人设下的 100 个多轮任务构成。
一个 agent 可能通过第一个测试、挂掉第二个(清单清完了,暗示的事一件没管),也可能反过来(会问聪明的澄清问题,但交付物做不出来)。所以无论你是要选基准,还是在读厂商的榜单宣传,第一个要问的问题都是:这个数字测的到底是哪一个缺口。
Agents’ Last Exam:显式任务的天花板
ALE 来自 UC Berkeley,出发点的抱怨很直接:现有 agent 基准太窄,根本无法说明 agent 能不能做有经济价值的工作。Terminal-Bench 测终端任务,SWE-bench测软件问题,WebArena 和 OSWorld 测浏览器或桌面操作,而 ALE 要覆盖职业数字工作的全貌:工程设计、科学计算、金融、媒体、运营、法律文书,归成 13 个行业大类、55 个子领域。
它有三条设计原则。代表性:任务来自领域专家,不是模板生成。复杂性:任务应该像一份范围明确的职业工作:打开工具、检查文件、运行行业软件、产出交付物,而不是一行问答。可验证性是最硬的一条:只要存在确定性判分方式(文件、数值、输出物、模拟结果、约束满足),ALE 就用它;凡是只能靠「再问一个模型你觉得好不好」来打分的内容,要么被拒掉、要么重新设计成可判分的。为防止污染,大部分题池不公开:1490 道任务实例只放出约 150 道,承载分数的其余题目留在滚动评测里。
结果相当残酷:最难层级平均完整通过率只有 2.6%。在 ALE-CLI 上,论文报告 Codex(GPT-5.5)总体通过率 25.2%(近期任务 41.5%、全谱任务 20.0%、期末级任务 4.5%),而同一个系统在论文的对比中 Terminal-Bench 拿了 82%。从 82% 到 25.2%,这组落差是全论文被引用最多的数字,它说的是「基准的广度」,而不是「某个模型不行」。跑起来也不便宜:单次运行约 3 到 10 美元,常常要几十分钟到几小时,上限五小时。
比榜单更有价值的是失败分析。对 Claude Code + Opus 4.7,约四分之三的失败属于「理解与打法」失败:agent 读错题、选错方案,或者没能识别出这份工作该用哪个领域专用工具或流程。作者还观察到:堆更多算力和更长预算并不能稳定换来更好成绩;在工程做得不错的系统之间,选哪个模型造成的差距远大于选哪个 harness;agent 常常随手写个临时脚本来交差,而不是使用正牌行业软件;窄的编程基准会奖励这种行为,真实工作流会惩罚它。
Pi-Bench:没说出口的意图缺口
Pi-Bench 把测试倒了过来。它的 100 个任务,每个都带一个初始请求、一组隐藏意图(用户从未明说的潜在需求)和一份可验证交付清单。一个纯反应式 agent 可以清完清单、同时漏掉全部隐藏意图,而这正是这个基准要抓的行为,因为在长期的助理关系里,用户真正在意的是「你懂我意思没有」,而不是「你执行了我打的字没有」。
基准跨 5 个职业人设展开(研究员、市场专员、法律实习生、药剂师、金融分析师),每个人设跑一个 20 会话的回合,处在一个交付物会不断积累的项目环境里。6 个依赖组(每组两三项任务)强迫 agent 把上下文带下去。两个分数定义了表现:主动性(proactivity)是 agent 靠自己解决掉的隐藏意图比例:要么直接完成,要么问出一个能逼出需求的聚焦问题;完整性(completeness)是可验证清单的完成度,由规则或评分细则判分。把两者拆开正是论文的贡献:它把「活干完了」和「人懂了」分成两件事。
头部数字:GPT-5.4 以 67.0%(±2.1)的主动性领先,完整性 65.6%;Claude Opus 4.6 主动性 65.5%、完整性 67.6%(完整性最高);Qwen3.6 Plus 以 64.0% / 64.1% 跟在后面。九个受测模型的主动性从 43.1% 到 67.0%,跨度 24 个百分点,而完整性落在更窄的 52.1% 到 67.6% 区间,没有前沿模型主动性破 70%。两个技能在单个模型上 visibly 地分裂:Kimi K2.5 完整性 61.6%、主动性只有 43.1%(反应式地清清单),Seed2.0 Pro 则完全镜像:主动性 58.4%、完整性 52.1%。
两个更细的发现承担了实际分量。第一,记忆在替 agent「主动」:把依赖组里的前文会话抽掉,主动性平均掉 9.5 个百分点,完整性只掉 2.5;GPT-5.4 的主动性从 78.5% 掉到 64.9%,完整性几乎不动。今天 agent 的「主动」很大程度上是在吃累积上下文的现成饭,而不是在对一个持续存在的用户建模。第二,领域差异巨大:法律交接场景的完整性 84.1%、主动性只有 38.1%(落差最大);药物设计任务恰好反过来,主动性 84.9%、完整性 68.0%。主动性是随领域变化的,不是一个单一标量。
关键数字对照
| 测量项 | Agents’ Last Exam | Pi-Bench | 说明 |
|---|---|---|---|
| 测什么 | 完成明确的职业任务 | 解决用户未说出的意图 | 测的是不同缺口,不是互相竞争 |
| 任务规模 | 960 个工作流 → 1490 道任务实例,55 个行业,13 个大类 | 100 个任务,5 个人设,20 会话回合 | ALE 更宽,Pi-Bench 单人设更深 |
| 难度结构 | 近期 / 全谱 / 期末三个层级 | 隐藏意图 vs 显式清单,6 个依赖组 | 都把单一分数拆成可分离的轴 |
| 判分方式 | 交付物的确定性检查;有确定性判法就不用 LLM 裁判 | 清单用规则或评分细则判分;意图解决被记录 | 两者都拒绝纯「感觉流」打分 |
| 前沿头部数字 | 最难层级 2.6%;Codex GPT-5.5 ALE-CLI 25.2%(按层 41.5 / 20.0 / 4.5) | GPT-5.4 主动性 67.0%、完整性 65.6%;Opus 4.6 为 65.5 / 67.6 | 模型、harness、规模全不同,不可横向比 |
| 上下文消融 | 未报告;上下文在任务内部,不在跨会话 | 抽掉前文会话:主动性 −9.5、完整性 −2.5(GPT-5.4 78.5→64.9) | Pi-Bench 把记忆依赖量化了出来 |
| 技能分裂证据 | Claude Code + Opus 4.7 约 75% 失败是理解/打法失败 | Kimi K2.5 完整性 61.6 / 主动性 43.1,Seed2.0 Pro 58.4 / 52.1 | ALE:agent 打错方向;Pi-Bench:两个技能此消彼长 |
| 领域差异 | 55 个行业,各领域深度不均 | 法律 84.1 完整性 / 38.1 主动性;药物设计 84.9 / 68.0 | 两者都警告不要只报一个榜单数字 |
| 外部基准锚点 | 同一 Codex GPT-5.5:Terminal-Bench 82% vs ALE-CLI 25.2% | 未报告 | ALE 的广度主张就压在这一对数字上 |
| 评测成本 | 单次约 3–10 美元,几十分钟到几小时,上限 5 小时 | 页面未报告 | ALE 大规模跑很贵 |
| 公开程度 | 1490 道公开约 150 道,其余私密防污染 | 页面未说明 | 复现前先查各自的发布物 |
这张表读不出东西的地方同样重要:没有模型同时出现在两个榜的头部结果里,没有共享 harness,两种规模(1490 个单发职业任务 vs 100 个二十会话回合)回答的是不同问题。任何把两者合并成单一「agent 能力分」的排名,都是在编造数据里不存在的对比。
两个榜在哪些事上意见一致
剥掉表面差异,两篇论文说了同样的三件事。第一,余量很大且是结构性的:ALE 最难层级 2.6%、Pi-Bench 前沿主动性 67.0%,从两个方向得出了同一个「远未解决」。第二,上下文是承重墙:ALE 的失败分析显示 agent 在需要识别并运用领域上下文时崩溃,Pi-Bench 的 9.5 分记忆消融显示抽掉累积上下文后「主动」大幅退化。第三,选模型比打磨 harness 更值钱:ALE 报告在工程过硬的系统之间,模型选择解释的差距远大于 harness 选择;Pi-Bench 上九个模型在同一 scaffold 下主动性差 24 个百分点,也说明 scaffold 不是差异来源。
它们在哪些地方分道扬镳
分歧才是有用的部分。ALE 判的是交付物(文件、数值、模拟输出对不对);Pi-Bench 判的是对人的行为(用户没打出来的事,agent 做了没有、问了没有)。ALE 的任务是自包含的职业工作;Pi-Bench 的任务是关系型回合,要点恰恰是交付物会累积、前文会话算数。ALE 把判分题池大部分私密化防污染;Pi-Bench 的页面没有同等的私密池设计,且它的「用户」是模拟人设,隐藏意图是作者认为研究员或药剂师会想要的东西,这是个合理的代理,但也可能奖励「对基准模式化应答」的系统。Pi-Bench 还只在单一 agentic scaffold(改造自 Nanobot)上跑,模型排名换一个 harness、工具集或记忆实现未必稳。范围上两者互为镜像:ALE 明确不碰外勤、具身机器人和长周期组织项目,Pi-Bench 用五个人设的深度换掉了开放世界覆盖。
怎么选
- 你在做或买面向职业工作的 computer-use agent(写代码、分析、文档产出),想要一个诚实的能力数字: 用 ALE 式可验证职业任务。82% 对 25.2% 的那组对照会一直在那里提醒你:窄基准分数会高估广度。
- 你在做一个被期待「有眼力见」的助理产品(日程、研究支持、长期项目): 用 Pi-Bench 式隐藏意图探针,而且要用它的主动性/完整性拆分做诊断:完整性高、主动性低的助理,是一个披着主动外衣的反应式工具。
- 你只能跑一个便宜实验: 在自己的日志上复刻 Pi-Bench 的记忆消融:抽掉一组真实会话的前文上下文,看「主动」行为消失多少。论文里 9.5 分的平均降幅是强先验:很多看似主动的行为只是上下文的红利。
- 你在读厂商榜单: 先看数字来自哪类基准:显式任务(ALE 一家)、意图(Pi-Bench 一家),还是窄任务集(Terminal-Bench、SWE-bench)。ALE 论文自己的对照已经证明:一个系统可以在第三类上很漂亮,在第一类上照样不及格。
局限与存疑
最核心的空白是两个基准从不相遇:模型不同、scaffold 不同、规模不同、指标不同,两者之间不存在同口径对比;上面的表对比的是协议,不是 agent。两者评的都是模拟对象(专家撰写的任务、人设脚本),都能被针对代理调出来的系统刷分。Pi-Bench 单一 scaffold 意味着排名未必迁移到别的 harness;ALE 的私密池意味着外人无法完整审计承担分数的题目。两者都不测依赖人和组织的长周期开放项目,也都没覆盖部署规模下的成本维度;ALE 单次跑就要 3–10 美元、最长五小时,Pi-Bench 页面没有成本分析。最后,两者都是快照:模型代际走得很快,ALE 里的 Codex GPT-5.5 和 Pi-Bench 里的 GPT-5.4 都会过时,而协议本身(可验证职业任务、隐藏意图主动性评分、记忆消融)才是能留下来的贡献。
常见问题
Agents’ Last Exam 和 Pi-Bench 能在同一批任务上对比吗?
不能。两者不共享任何任务、模型或 harness。ALE 报告 Codex(GPT-5.5)在 ALE-CLI 上 25.2%、最难层级平均 2.6%;Pi-Bench 报告 GPT-5.4 主动性 67.0%、完整性 65.6%(共 100 个任务)。两组数字测的是不同能力、不同规模,无法互相排名。
每个基准最重要的一条结果是?
ALE 这边,同一个 Codex GPT-5.5 在 Terminal-Bench 拿 82%、在 ALE-CLI 只有 25.2%(期末级任务进一步掉到 4.5%),窄基准的成功不迁移到广谱职业工作,这是最硬的证据。Pi-Bench 这边,抽掉前文会话让主动性掉 9.5 分、完整性只掉 2.5 分,把今天多少「主动性」其实是吃上下文红利这件事量化了。
我该用哪个基准评自己的 agent?
如果你的 agent 执行的是明确的职业任务,就做 ALE 式可验证任务,判分用确定性的交付物检查。如果你的产品是长期陪伴型助理,就做 Pi-Bench 式带隐藏意图的任务,并且把主动性和完整性分开打分。两件事都做的话,两个分数也别合并:一个 agent 完全可能交付物很强、主动很弱,平均一下就把用户真正能感知到的失败模式抹掉了。
ALE 和 Pi-Bench 公开吗?
ALE 部分公开:1490 道任务实例放出约 150 道,其余为滚动评测和防污染保留。Pi-Bench 的公开情况其页面未作说明,复现前先查论文的发布物。
这两个基准是不是证明 agent 没用?
不是。ALE 自己的失败分析比这精确得多:约四分之三的失败是理解和打法失败,即读错题、没认出该用哪个领域流程,这和工具能力差是两个问题。Pi-Bench 显示前沿模型能解决三分之二的未说出口意图。两个基准说的是 agent 能力不均衡,不是没用,而且都给工程师提供了定位不均衡在哪的方法。