
思维链 vs ReAct vs Toolformer:多步任务的三种经典解法
思维链把推理步骤写进提示词,ReAct 让推理和真实工具调用交替进行,Toolformer 直接训练模型自己发出 API 调用。同一个问题,三篇论文对「可靠性该从哪来」下了三种不同的注。
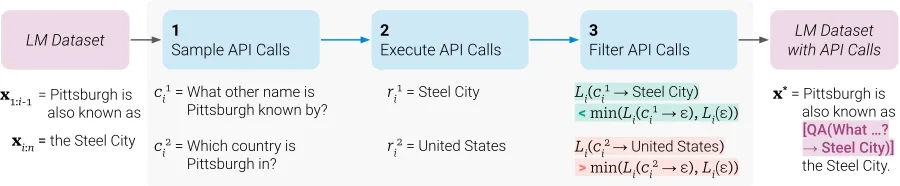
三篇论文回答的是同一个问题
到 2022 年初,大模型已经能吞下海量知识,却还会算错一道小学数学题。相隔十四个月内发表的三篇论文,从三个方向解决这个缺口,而今天的 agent 技术栈就是这三者的共同后代。思维链提示(2022 年 1 月)的思路是:让模型留在自己脑子里,但逼它把步骤写出来。ReAct(2022 年 10 月)更进一步:照样思考,但每想几步就必须碰一次外部世界。Toolformer(2023 年 2 月)则干脆放弃提示词,直接训练模型把调用计算器、搜索 API 当成生成本身的一部分。
它们与其说是竞争关系,不如说是三层结构。今天几乎每一个生产级 agent 都在一步步推理(思维链),把推理和工具返回交替进行(ReAct),并且通过训练好的接口而不是手写提示来调工具(Toolformer 及其后继)。但每篇论文单独的机制、监督方式和失败模式都不同,排障时搞清楚坏的是哪一层,工作就做完了一半。
关键数字
三篇论文从未在同一套设定下互相打过,所以诚实的表格是一张设计维度对比加三块各自的数字,不要横向读成排名。
| 维度 | 思维链 | ReAct | Toolformer |
|---|---|---|---|
| 改了什么 | 少样本示例里带上推理过程 | 输出空间里加入自由文本 thought,与动作交替 | 在自标注的 API 调用数据上微调模型 |
| 监督信号 | 只有手写示例 | 只有一两个手写示例 | 自监督:调用结果的插入能降低后续 token 损失才保留 |
| 是否有外部锚定 | 没有,推理是封闭独白 | 每个 thought 都基于真实工具返回 | 工具结果读回文本继续生成 |
| 工具串联 | 不涉及(没有工具) | 单工具顺序使用(维基百科 API) | 不支持,各 API 独立调用 |
| 论文用的基座 | PaLM 540B(另有 GPT-3、LaMDA) | PaLM 540B | GPT-J 6.7B |
各论文的招牌结果:
| 结果 | 数字 | 设定 |
|---|---|---|
| 思维链在 GSM8K 上 | 约 57% 对标准提示的约 18% | PaLM 540B,8 个示例,零训练 |
| 思维链的规模门槛 | 约 100B 以下无收益,有时反而变差 | 540B 大涨,10B 级持平或更差 |
| 思维链对当时最优 | 超过微调 GPT-3 加验证器 | GSM8K,2022 年初 |
| ReAct 在 ALFWorld 上 | 绝对成功率比模仿学习和 RL 智能体高 34 个百分点 | 1-2 个上下文示例对数千条训练轨迹 |
| ReAct 在 WebShop 上 | 绝对成功率高 10 个百分点 | 同样少样本设定 |
| ReAct 在 HotpotQA / Fever 上 | 消除了纯思维链的幻觉和错误传播 | 交替式优于单推理或单行动 |
| Toolformer 下游收益 | 体量约小 25 倍却能与 GPT-3 175B 竞争 | GPT-J 6.7B 基座,零样本评测 |
| Toolformer 的监督成本 | 每个 API 只需寥寥几条人工示例 | 计算器、问答、两个搜索引擎、翻译、日历 |
| Toolformer 的副作用 | 基座模型的语言建模困惑度不受影响 | 加工具能力不伤底子 |
思维链:最便宜的修法,但有硬性的规模门槛
方法本身只改一行提示:标准少样本给模型看「问题→答案」,思维链给「问题→推理步骤→答案」。手写大约八个示例就够。仅凭这一招,PaLM 540B 在 GSM8K 上从约 18% 跳到约 57%,超过了此前微调 GPT-3 再加专门验证器的最优成绩。没有梯度更新,没有新数据。
最容易被忽略的正是那道门槛:在约 100B 参数以下,同样的提示要么没用、要么帮倒忙:小模型写出的链条流畅但逻辑断裂,成绩反而不如直接猜。思维链是涌现能力,能力得先潜伏在模型里,提示词只是把它引出来。这也是为什么「加一句 step by step」不是万灵药,以及为什么推理模型时代(o1、DeepSeek-R1)一旦看清天花板在权重而不在提示,就转向了训练。
它的失败模式是「自信的幻觉」。链条是封闭独白,没有任何环节拿中间结论去和现实核对,一个错误前提会滚雪球成笃定的错误答案;而且写出来的步骤本来也不忠实于模型内部的真实计算。
ReAct:每想几步,就用一次观察落地
ReAct 的修法是结构性的。模型交替输出「思考→行动→观察→思考……」,行动是真实的工具调用,观察是工具的返回。思考负责拆目标、盘点未知、改写失败的搜索;行动负责取回真实事实。在知识类任务上两者单独都不够:只推理会重蹈思维链的幻觉覆辙,只行动会丢掉整体计划,正是交替进行才消除了 HotpotQA 和 Fever 上的幻觉与错误传播。
最惊人的是 ALFWorld:一个只靠一两个示例提示的模型,在绝对成功率上比用数千条轨迹训练出来的模仿学习和 RL 智能体高 34 个百分点,在 WebShop 上高 10 个百分点。ReAct 不是新架构也不是新目标,它是一种格式;它的贡献在于证明格式本身就能为一个足够强的基座补上可靠性缺口。
失败模式也随之而来:收益完全押在基座模型和工具质量上,搜索什么都返回不了,推理就无物可锚,照样卡壳或幻觉;轨迹可能原地打转不收敛,没有有原则的停止规则;评测世界也偏窄,基本是单工具、纯文本。
Toolformer:把工具调用变成训练出来的行为,而不是提示技巧
Toolformer 在监督上下的注恰恰相反。它不指望提示词引出工具使用,而是直接在预训练语料上微调模型,让发出 API 调用成为普通文本生成的一部分。数据自己造:模型在语料的许多位置采样候选调用、执行,只有当结果的插入能降低后续 token 的损失时才保留这条调用。计算器调用在真正能算出一段算术时被留下,搜索调用在片段确实有助于下文时被留下。五个工具各自只需要寥寥几条人工示例来启动采样。
回报是:6.7B 的 GPT-J 在零样本下游任务上能与 175B 的 GPT-3 竞争,体量小了约 25 倍,且基座困惑度不受影响。这就是今天所有 function-calling API 的研究祖先:区别在于 Toolformer 从数据里学「何时调」,而不是靠推理时的固定模式。
天花板同样是结构性的:降损过滤器只认局部有用的调用,收益弥散或多步的工具进不了数据;Toolformer 不能串联 API,一个工具的输出喂不进另一个,论文自己把这列为局限,而这正是后来的 agent 框架在其之上补的课。
怎么选
- **自包含推理、模型够大、不需要工具:**思维链仍是基线,八个示例,零训练。
- **事实会过期或推理中途必须核对:**ReAct 的思考-行动-观察循环。只要环境会回应,锚定永远胜过更长的空想。
- **工具调用要交付给不会调提示的用户:**走 Toolformer 一路,从数据里学何时调用,推理时只暴露 schema。提示出来的 ReAct 是研究原型,训练出来的调用才是产品。
- **跨多个工具的多步组合:**三篇论文没有一篇单独解决,这正是现代栈三层叠用的原因,而不是三选一。
局限与存疑
三篇论文基座不同(两个 PaLM 540B、一个 GPT-J 6.7B)、任务不同、成功度量不同,不存在诚实的跨论文排名,上表刻意让每条数字待在各自的设定里。三者都在 2023 年前后的 regime 下演示,靠手写示例和偏窄的 benchmark;它们各自的成绩有多少能迁移到今天的模型(那些已经在推理轨迹和工具数据上训练过的模型)仍是个经验问题。而各自的招牌失败(不忠实的链条、无锚的打转、不能串工具)至今仍是生产里对应那一层最先坏掉的地方。
常见问题
思维链、ReAct、Toolformer 谁先谁后?
思维链(2022 年 1 月)最先,然后 ReAct(2022 年 10 月),最后 Toolformer(2023 年 2 月)。ReAct 明确站在思维链的肩膀上,把行动和观察加进推理轨迹;Toolformer 与前两者相互独立,用微调取代了提示。
思维链提示能把 GSM8K 提升多少?
PaLM 540B 配八个示例,GSM8K 解题率从标准提示的约 18% 升到约 57%,超过此前微调 GPT-3 加验证器的最好成绩,且没有任何额外训练。
思维链对小模型有用吗?
没有。论文表明它是约 100B 参数以上才出现的涌现能力;小模型写出流畅但有缺陷的推理,成绩往往比标准提示更差。
ReAct 比训练过的 RL 智能体强多少?
在 ALFWorld 上,ReAct 的绝对成功率比模仿学习和 RL 训练的智能体高 34 个百分点,WebShop 上高 10 个百分点,而它只用了 1-2 个上下文示例,对方用了数千条训练轨迹。
Toolformer 能把工具串起来用吗?
不能。每个 API 独立调用,一个工具的输出不能作为另一个的输入,论文把这列为明确的局限,后来的 agent 系统正是为了补上这一课而生。
Toolformer 和 OpenAI function calling 是一回事吗?
不是。两者都让模型调用外部函数,但 Toolformer 从数据里学习何时调用并对结果微调,而 function-calling API 在推理时暴露固定模式让模型照着填。Toolformer 是这条能力线的研究前身。