IPT 对比 SpatialWorld:视觉空间推理的方法与尺子
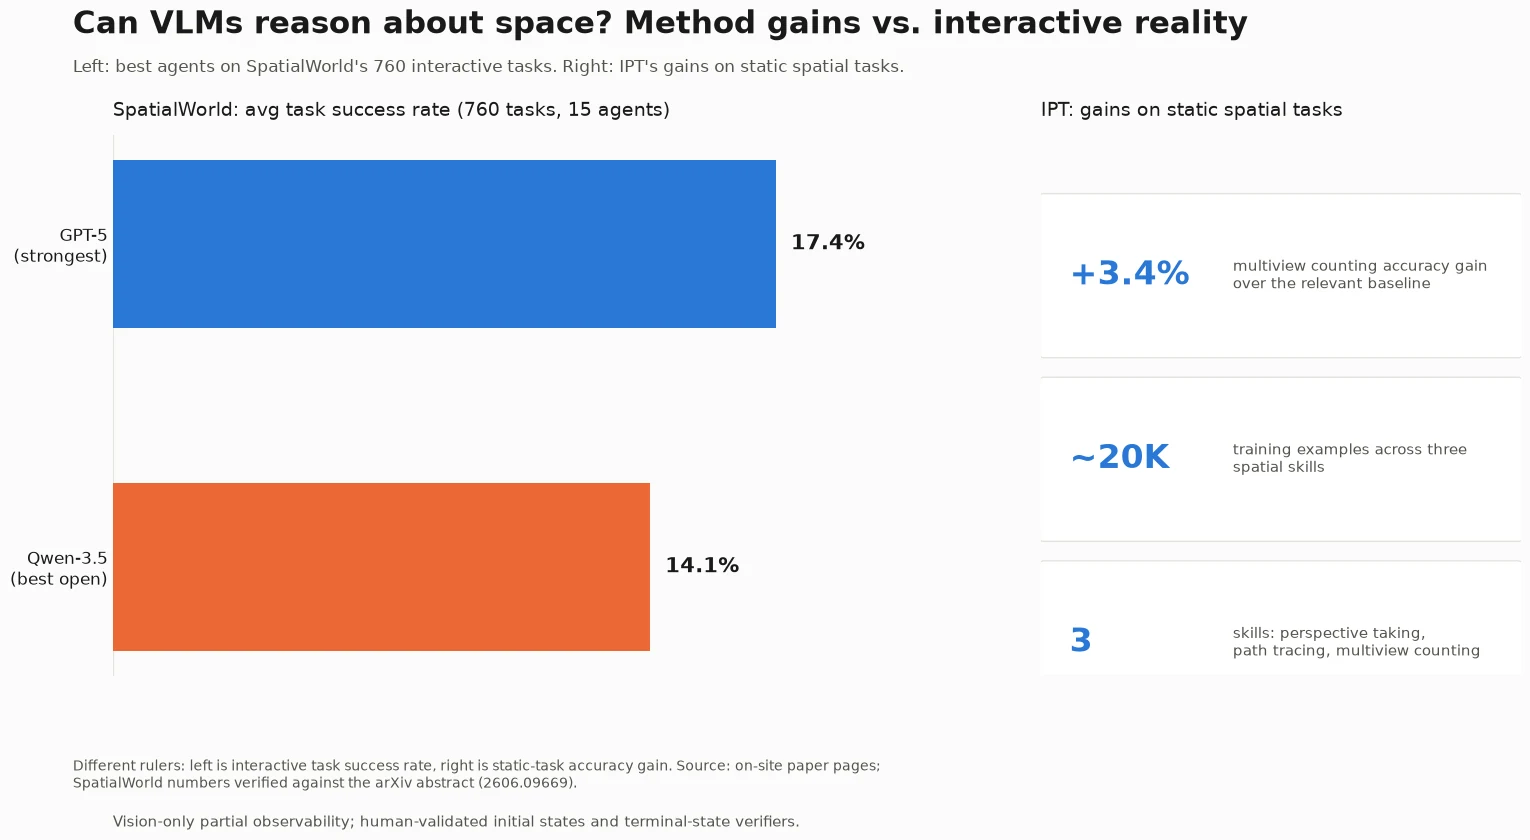
IPT 用渲染想象视角替代文字推理,多视角计数提升 3.4%;SpatialWorld 的 760 个交互任务上,最强智能体 GPT-5 成功率仅 17.4%。增益是真的,缺口更大。
两篇 2026 年的论文从相反方向攻击同一个弱点:视觉语言模型不懂空间。Imaginative Perception Tokens(IPT)是一篇方法论文,它问:如果模型把想象空间视角渲染成图、再基于这张图作答,而不是用文字叙述推理过程,空间题会不会做得更好?SpatialWorld是一篇基准论文,它问:当空间推理发生在交互任务内部、视觉信息只能自己一步步采集时,今天最强的智能体到底能做对多少?
两篇合在一起看,比单看任何一篇都清晰。IPT 报告了静态空间题上真实、可测量的提升;SpatialWorld 报告的是:按交互口径测量,被测的最强智能体仍有超过五分之四的任务失败。本指南把两组数字并排摆开,解释它们为什么不矛盾,并说明你在什么情况下该用哪一篇。
关键数字
| 维度 | IPT(方法论文) | SpatialWorld(基准论文) |
|---|---|---|
| 它是什么 | 训练方法:输出解码成想象视角的 token,再基于渲染结果推理 | 基准:用终态验证器打分的交互式空间任务集 |
| 被评对象 | 基于 BAGEL 的开源系统,与基线和闭源模型对照 | 15 个智能体,接入 8 个异构仿真后端 |
| 头号数字 | 多视角计数准确率较基线 +3.4% | GPT-5 平均任务成功率 17.4%,为 15 个智能体中最高 |
| 最强开源结果 | 路径追踪任务上与闭源模型相当 | Qwen-3.5 平均成功率 14.1%,为最强开源模型 |
| 文字思维链 | 有时会降低空间准确率;用语言叙述几何是模态错配 | 与主动探索、长程规划并列为主要瓶颈 |
| 规模 | 3 项技能,约 2 万条训练样本 | 760 个人工标注任务,初态与参考轨迹均经人工校验 |
| 可观测性 | 静态图片进,一个答案出 | 仅有视觉的部分可观测;智能体须主动采集第一人称证据 |
其中三行值得再细看。
17.4% 是全部任务的平均值。 GPT-5 是 SpatialWorld 上 15 个被测智能体中最强的,平均完成 760 个任务中的 17.4%。最强开源模型 Qwen-3.5 为 14.1%,与榜首差距 3.3 个百分点。但比起”离解决还差多远”,这两个数字都显得很低。论文还报告了任务成功率与执行效率之间的明显错配:能完成任务的智能体,路线往往也绕;不同任务域之间的成绩差异也很大。
+3.4% 是增益,不是水平。 IPT 在自家三项任务设置上把多视角计数准确率提高了 3.4 个百分点。论文并没有声称解决了空间推理,它声称的是:想象视角监督能教会仅靠答案标签教不会的东西,且两种监督信号可以叠加。一个诚实的提醒:解读页没有给出计数的绝对准确率,所以这 3.4 个百分点无法换算成成功率,不应拿来和 SpatialWorld 的 17.4% 直接比较。
两篇论文都在指控文字这个媒介,理由不同。 IPT 发现文字思维链训练有时会降低空间准确率,因为把旋转和物体再识别硬塞进散文会丢失几何信息。SpatialWorld 发现失败集中在主动探索和长程规划上,而这两种能力恰恰是单轮文字答案永远锻炼不到的。另一条相关线索也指向同一方向:跨视角再推理的结论是,让模型跨视角二次推理胜过一次性作答:空间能力靠的是多看一眼,而不是多说几句。
怎么选
如果你在训练或微调视觉语言模型做静态空间任务(多视角计数、路径追踪、视角切换),用 IPT。它的贡献是一个可嫁接的监督信号:让模型渲染想象中的视角,再与真实视角对照检查。如果你的模型问题是”描述很流利、计数和寻路总出错”,IPT 给了一个具体、可检查的中间目标。
如果你要评估智能体是否真的能在空间里行动(导航、搜索环境、调整布局、走错后恢复),用 SpatialWorld。760 个任务、8 个仿真后端、由终态验证器而非评审模型打分,这些设计让每个分数都可核查。如果你在为具身产品或电脑操作场景选模型,它给出的 GPT-5 17.4% 对 Qwen-3.5 14.1%,比任何静态图片榜单都更有决策价值。
正确姿势是两篇一起用:用 IPT 这类方法训练空间能力,再用 SpatialWorld 这类基准做交互验证。现有证据只支持前半句”方法确实有效”,后半句”交互验证远未通过”。把静态任务上的提升当作交互就绪的证据,正是这两篇并排摆放时要警告的过度解读。
局限与存疑
两篇论文合不成一张排行榜,本指南也刻意没有硬拼。IPT 的数字来自三个手工挑选的技能、约两万条训练样本,报的是相对基线的增量;SpatialWorld 的数字来自 760 个交互任务,报的是平均成功率。尺子不同、单位不同、主张不同。
IPT 解读页自己列了风险:增益幅度有限、评测面窄、每问一次就要多渲染一张中间图,成本高于纯文字输出。更麻烦的是,想象视角一旦幻觉,中间产物就不是中性的:模型等于在一张错得自信的图片上做推理,BAGEL 生成器的错误会被原样继承。
SpatialWorld 的风险在另一侧:15 个智能体、8 个后端对单一基准而言算广,但仍是切片;任务偏向居家、出行与协作场景;终态验证器能确认”任务完成了”,确认不了”完成得高效”,所以成功率与效率的错配才重要。两篇都没有测对方的世界:IPT 没跑交互任务,SpatialWorld 也没测想象视角训练能不能抬升它的数字。
两篇共同留下的真问题:像素级空间监督能否迁移到交互智能体上?目前还没有人发表这个结果。在那之前,两边的结论都只能窄着用。
常见问题
IPT 提升 3.4%,是否意味着模型能解决 SpatialWorld 的任务?
不能,而且这两个数字不可比。+3.4% 是 IPT 自家三项任务里多视角计数的准确率增益,17.4% 是 GPT-5 在 SpatialWorld 760 个交互任务上的平均成功率。指标不同、评测环境不同、任务类型不同。能下的结论只有:静态任务的方法在进步,交互成功率仍然很低;前者能否带动后者,尚无答案。
引用 SpatialWorld 的基准结果时该报哪些数字?
报这些:760 个人工标注任务、8 个异构仿真后端、15 个被测智能体、GPT-5 平均任务成功率 17.4%(最强)、Qwen-3.5 14.1%(最强开源),以及论文报告的成功率与执行效率错配。每个任务都带人工校验的初态、参考轨迹和终态验证器。
文字思维链对 IPT 这类空间推理什么时候有用?
按 IPT 论文的结论,很少有用。文字思维链训练有时会降低空间准确率,因为用语言叙述几何属于模态错配:旋转、遮挡、物体再识别本是视觉操作。论文的替代方案是让模型把空间猜测渲染成图,再训练这张图去逼近真实视角,+3.4% 的多视角计数增益正来自这里。
两篇论文各自如何保证结果可信?
IPT 直接监督想象视角:渲染预测被训练去匹配真实替代视角,中间产物可核查,不是自由发挥的文字。SpatialWorld 用机械方式验证结果:每个任务都有人工校验的初态、参考轨迹和终态验证器,智能体在仅有视觉的部分可观测条件下、通过统一的文本动作接口行动。两篇的头号数字都没有依赖评审模型。
一句话:IPT 让空间推理在像素里好了一点,SpatialWorld 展示了它在运动状态下还差多远。读 IPT 论文解读和 SpatialWorld 论文解读。