
GRPO 和 PPO 的区别:去掉价值模型换来了什么
GRPO 用同组采样答案的平均奖励替代 PPO 学习出来的价值模型,少一个和策略同样大的模型,让开源推理 RL 变得可负担,代价是失去逐 token 的信用分配并带来新的不稳定。
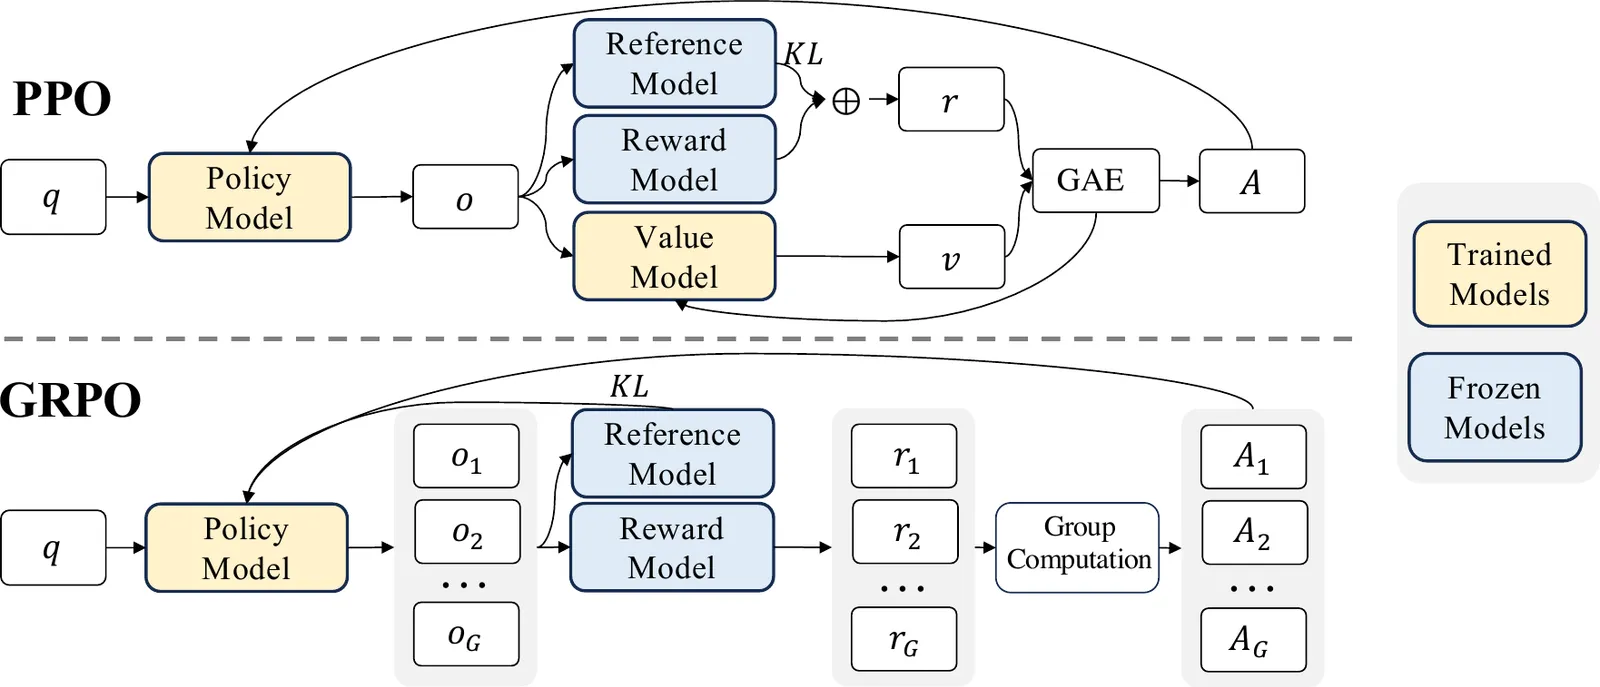
唯一的设计差异
两种算法优化的是同一个裁剪代理目标:策略生成回答,优势值衡量每个 token 比预期好多少,更新被裁剪在新旧策略比率大约 0.8 到 1.2 的区间内。这个区间和”取裁剪与未裁剪的较小值”的技巧直接来自 2017 年的 PPO 论文,GRPO 一字未改。
不同的是优势值从哪来。PPO 训练一个价值模型,通常和策略一样大,预测每个 token 位置的期望回报,优势就是奖励减去这个预测,再用广义优势估计平滑。DeepSeekMath 提出的 GRPO 把价值模型删掉:对每个提示采样一组 G 个回答,逐个打分,每个回答的优势等于它的奖励减去组均值、除以组标准差,回答里所有 token 共享这一个数。基线不再是学出来的,而是从同组兄弟样本里估出来的。
第二个更小的变化由此而来。InstructGPT 那一路的 PPO 把对参考模型的 KL 惩罚折进每个 token 的奖励里;GRPO 把 KL 项直接加在损失上,用一个恒为正的估计量,因为把 KL 混进奖励会让组内归一化变得麻烦。
关键数字
| 测量项 | PPO | GRPO | 设置与出处 | 同一套评测? |
|---|---|---|---|---|
| 训练时常驻的模型 | 策略、价值、奖励、参考(4 个) | 策略、奖励、参考(3 个) | 设计层面,DeepSeekMath 4.1 节 | 是,由定义决定 |
| 优势值粒度 | 逐 token,来自价值模型 | 每个回答一个值,全部 token 共享 | 结果监督版 GRPO | 是 |
| MATH,7B,思维链 | 论文未跑 | RL 后 46.8 → 51.7 | DeepSeekMath-Instruct → RL,14.4 万题 | 无 PPO 对照组 |
| GSM8K,同一次训练 | 未跑 | 82.9 → 88.2 | DeepSeekMath 表 5 | 无 PPO 对照组 |
| AIME 2024 pass@1,从基座纯 RL | 未跑 | 15.6 → 71.0 | DeepSeek-R1-Zero,规则奖励 | 无 PPO 对照组 |
| AIME24/25/26 Avg@16,Qwen3-30B-A3B-Base | 未跑 | 38.19(GRPO)对 49.23(DPPO)对 54.79(CPPO) | CPPO 论文,相同数据与奖励 | 是,GRPO 对后来的信赖域变体 |
| 平均 Pass@32,R1-Distill-Qwen-1.5B | 未跑 | 77.41(GRPO)对 79.17(N-GRPO) | N-GRPO 论文 | 是,GRPO 对自身变体 |
| 情感控制的奖励-KL 前沿 | 同等 KL 下低于 DPO | 未跑 | DPO 论文,PPO 作为 RLHF 基线 | 仅 PPO 对 DPO |
| 组大小 / KL 系数 / 策略学习率 | 不适用 | 64 / 0.04 / 1e-6 | DeepSeekMath RL 设置 | 不适用 |
看这张表,先看它缺什么。这组论文里找不到任何一篇在相同数据、相同奖励模型、相同算力下同时训练 PPO 和 GRPO 并报告两者。DeepSeekMath 从显存和方差角度论证 GRPO,然后拿 GRPO 和自己的 SFT 起点比。后来的 CPPO 和 N-GRPO 把 GRPO 当作在位者去超越,这只说明 GRPO 是默认选项,不说明它最优。文献里最干净的”PPO 对某个替代方案”的数字是 DPO 的前沿曲线,而那是 PPO 对一个离线方法,不是对 GRPO。
critic 原本买到的是什么
PPO 的价值模型贵,但不是摆设。它给每个 token 一个基线,所以一段在第 40 步走错的长回答,原则上可以让第 40 步之后的 token 拿到负优势、之前的拿到正优势。结果监督的 GRPO 表达不了这件事:整个回答只有一个数。DeepSeekMath 的过程监督版本用过程奖励模型给每一步打分、把该步之后的归一化奖励求和,找回了一部分,但这又引入了一个需要训练的打分器,而那正是你想省掉的大部分成本。
价值模型还会吸收奖励噪声。当奖励模型是在人类偏好上训练的神经网络,像聊天 RLHF 那样,单个分数是有噪声的,学习出来的基线会在大量提示上把噪声平均掉。GRPO 的基线只来自同一个提示的 G 个样本。G = 64 时估计还算靠谱;许多开源配方出于成本用 G = 8,基线本身就有噪声,再除以小样本的标准差会把噪声放大。
GRPO 是把算力挪了地方,不是省掉了。critic 的前向和反向没有了,但每个提示要生成 G 个回答而不是 1 个,而生成恰恰是语言模型 RL 里最慢的环节。在可验证任务上这笔交换显然划算,因为采样相对于再训一个 7B 或 70B 模型很便宜,而且奖励是精确的。在需要学习奖励模型的任务上,账就没那么悬殊。
GRPO 为什么还是赢了
GRPO 从 2025 年初起主导开源推理工作,是因为它恰好匹配一种组合:奖励能精确计算(答案、单元测试、证明检查器),输出很长以至于价值模型很难从单一末端奖励里给每个 token 估值,显存放不下四个大模型。DeepSeek-R1 是存在性证明。R1-Zero 只用 GRPO 和规则奖励从基座模型训练,AIME 2024 pass@1 从 15.6 升到 71.0,没有任何监督推理数据。DeepSeek 明确不用神经奖励模型以防奖励作弊,而奖励一旦精确,critic 平均噪声的作用就消失了。
DeepSeekMath 自己的分析解释了机制:RL 提升了 Maj@K 而不是 Pass@K。模型没有学会解新题,而是更常把正确答案排到分布顶端。对这个目标来说组内基线就够了,因为”在这道题上比我的兄弟样本好”正是你要的信号。
怎么选
- 奖励可验证、思维链很长、显存紧张: 选 GRPO。这是 R1 的场景,也是几乎所有开源推理配方瞄准的场景。
- 奖励来自学习的偏好模型,优化聊天或写作质量: PPO 仍然站得住,DPO 一族是常见替代。小组大小加噪声奖励模型的 GRPO,比 PPO 的 critic 少了一层保护。
- 稠密奖励或中间步骤奖励、有多步环境反馈的智能体: PPO 的逐 token 基线天然对应逐步奖励。结果监督 GRPO 会丢掉这层结构,过程监督 GRPO 又得把训练好的打分器请回来。
- 已经有 GRPO 代码库、想要稳定性: 别换回 PPO,换裁剪规则。CPPO 的早期 token 加权和前缀预算在 30B MoE 设置下比 GRPO 高 16.6 分,数据完全相同;N-GRPO 的 rollout 扰动带来约 2 分 Pass@32。最近的收益都在信赖域变体上。
GRPO 自己的失效模式
实践中有三个问题是原论文没讨论的。第一,如果一组回答的奖励全相同,标准差为零,这个提示就贡献不了梯度;在太简单或不可能的题上,这占到批次的大部分,所以后来的配方会过滤零方差组或重采样直到组内有对有错。第二,GRPO 目标里对每个回答做 1/|o| 归一化,使 token 权重随回答长度变化,2025 年的分析把”偏爱更长的错误回答”归因于此。第三,从 PPO 继承的裁剪区间限制了低概率 token 被推高的幅度,压制探索,几个配方的修法是抬高上限。CPPO 诊断出早期 token 应该比后期 token 裁得更紧,是同一类问题从另一面看。
局限与存疑
这个对比最大的缺口是缺一个受控实验:数据、奖励、算力和调参投入都匹配的一次 PPO 和一次 GRPO,分别在可验证任务和学习奖励任务上跑。在它出现之前,“GRPO 用更少显存达到 PPO 的效果”是设计推论加上”GRPO 训出的模型很强”这一事实,不是实测等价。上面所有 GRPO 结果都来自有精确答案的推理基准,没有一条说明 GRPO 作为聊天助手主 RLHF 循环时的表现。而且这些 GRPO 数字来自不同的基座模型、组大小和奖励设置;表里标了哪些行共享同一套评测,避免把 MATH 上的 51.7 和 AIME 上的 71.0 当成同一件事去比。
常见问题
GRPO 比 PPO 好吗?
在受控实测的意义上没有结论。GRPO 去掉 PPO 的价值模型、用一组采样答案估计基线,省了显存,也足以训出 DeepSeek-R1。但这组对比里没有任何论文在相同条件下同时跑 PPO 和 GRPO,而后来的信赖域变体在相同数据上比 GRPO 高 5 到 16 分,所以 GRPO 是实用默认值,不是上限。
GRPO 像 PPO 一样有 critic 或价值模型吗?
没有。PPO 训练一个通常和策略一样大的价值模型来预测每个 token 的期望回报。GRPO 对每个提示采样 G 个回答(DeepSeekMath 用 64),用每个回答的奖励减去组均值、除以组标准差,作为它所有 token 的优势。
GRPO 相比 PPO 能省多少显存?
PPO 训练时保留四个模型:策略、价值、奖励、参考。GRPO 保留三个,去掉的价值模型通常和策略一样大。用规则奖励时,如 R1-Zero,奖励模型也不需要了。省下的是一个策略大小的模型及其优化器状态,代价是每个提示要生成 G 个样本。
GRPO 和 PPO 在 KL 惩罚的用法上有什么区别?
语言模型上的 PPO 在计算优势之前,把逐 token 的 KL 惩罚从奖励里减掉。GRPO 把对参考策略的 KL 散度直接加在损失里,用一个恒为正的无偏估计量,这样奖励的组内归一化保持简单。
什么情况下应该继续用 PPO 而不是 GRPO?
奖励来自分数有噪声的学习偏好模型时,奖励在中间步骤而非只在末尾出现时,以及超长轨迹需要逐 token 信用分配时。这些场景里 PPO 学习出来的基线做的事,组均值做不到。