
DeepSeekMath 论文解读:GRPO 的出处
DeepSeekMath 7B 靠 120B 数学 token 继续预训练加 GRPO,不用工具在 MATH 拿到 51.7%;GRPO 去掉 PPO 的价值模型,用组内均值当基线。
快速答案
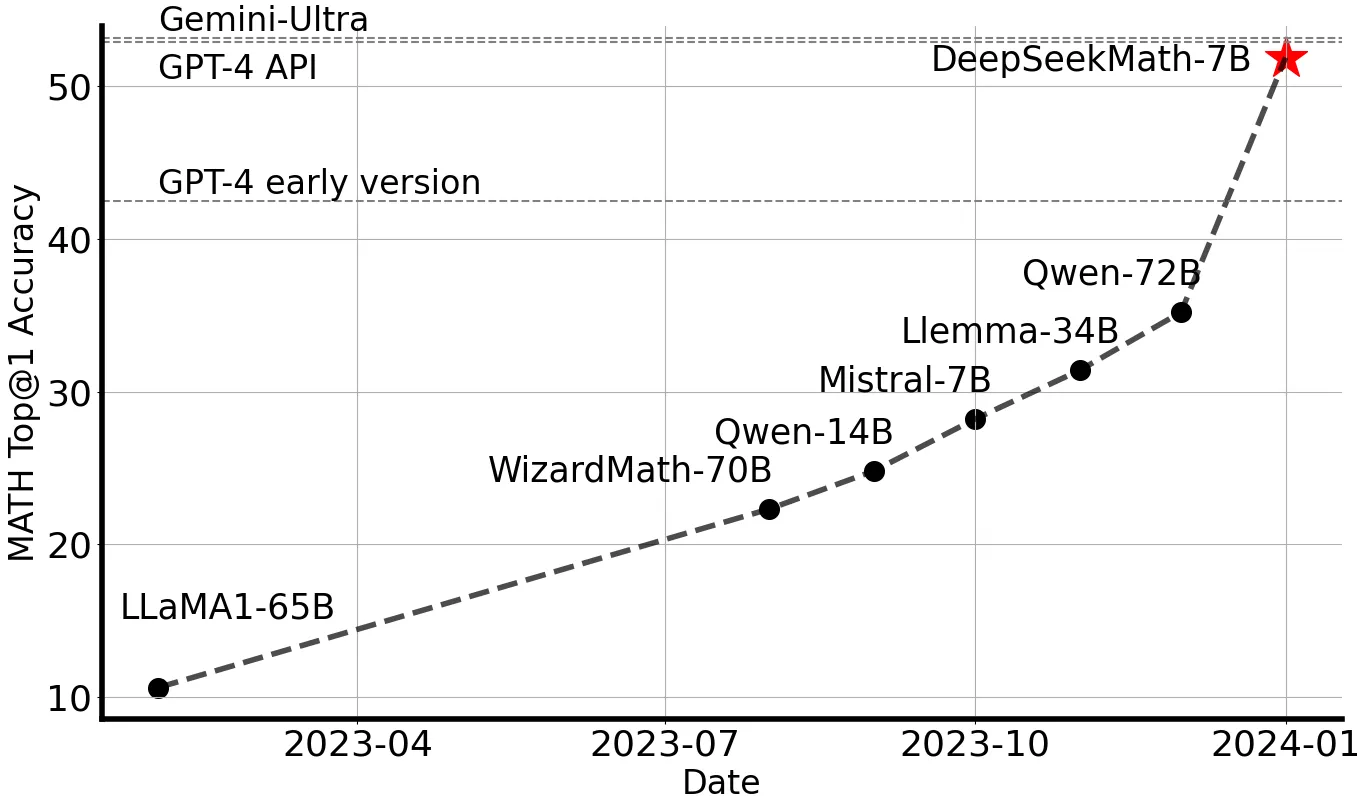
DeepSeekMath 是 DeepSeek 在 2024 年 2 月发布的论文,做成了两件至今仍在用的事。第一,它证明一个 7B 模型不用工具、不用多数投票,也能在竞赛级 MATH 上拿到 51.7%,接近当时 GPT-4 的 52.9%,主要靠从 Common Crawl 里筛出的 120B 数学 token 做继续预训练。第二,它提出了 GRPO(Group Relative Policy Optimization),一个去掉价值模型的 PPO 变体:同一道题采样一组答案,每个答案的优势由它在组内的相对得分决定。后来 DeepSeek-R1 和大多数开源推理 RL 工作用的都是 GRPO。
51.7% 主要来自哪里
这篇论文常被当作 GRPO 的出处引用,但真正出力最多的是预训练语料。DeepSeek 搭了一条迭代管线:以 OpenWebMath 为种子,训练 fastText 分类器在 Common Crawl 中找数学网页,把高分域名整体收下,人工标注 URL 模式,再循环。四轮之后得到 3550 万个页面、120B 数学 token,约为 Minerva 数学数据的 7 倍、OpenWebMath 的 9 倍。用这批语料混合代码和通用文本,对 DeepSeek-Coder-Base-v1.5 7B 做继续预训练,得到的 DeepSeekMath-Base 7B 在 few-shot 下 GSM8K 64.2%、MATH 36.2%,已经超过 Minerva 540B。
消融里有两个反直觉的结论值得记住。只用 arXiv 论文训练,作者测的所有数学基准都没有提升。先训代码再训数学则有帮助,有工具和无工具两种设置都成立,这是”代码训练提升推理能力”这一说法比较干净的一条证据。
再用 77.6 万条数学指令数据做监督微调,覆盖思维链、程序化推理和工具调用三种格式,得到 DeepSeekMath-Instruct 7B:GSM8K 82.9%,MATH 46.8%。
从 PPO 到 GRPO 改了什么
用在语言模型上的 PPO 是一个 actor-critic 循环:策略生成答案,奖励模型打分,另一个通常和策略同样大的价值模型估计每个 token 的基线,用来降低优势估计的方差。这个第二模型既占显存又难训,因为在语言模型场景里只有最后一个 token 有真实奖励,价值模型对中间 token 的估计只能靠猜。
GRPO 把价值模型删掉。对每道题采样一组输出(论文用 64 个),奖励模型逐个打分,然后在组内做归一化:减去组均值,除以组标准差。这个归一化后的奖励就是该输出所有 token 的优势。裁剪目标函数和 PPO 一样。差异有两处:对参考模型的 KL 惩罚直接加在损失里,而不是像 PPO 那样折进每个 token 的奖励,并且用的是一个恒为正的无偏估计;论文还指出组内相对基线和奖励模型的训练方式是匹配的,因为奖励模型本来就是在同一问题的答案对比上训练的。
论文同时试了过程监督版本,由过程奖励模型给每一步打分,token 的优势是它之后各步归一化奖励之和;还有迭代版本,用回放缓冲区在新的策略样本上持续训练奖励模型。
关键结果
- RL 阶段,思维链,无工具(表 5): DeepSeekMath-RL 7B 在 GSM8K 达到 88.2%,MATH 达到 51.7%,起点 Instruct 模型分别是 82.9% 和 46.8%。RL 只用了 SFT 集里约 14.4 万道 GSM8K 和 MATH 题。
- 域外迁移: CMATH 从 84.6% 升到 88.8%,MGSM-zh 从 73.2% 升到 79.6%,这两个数据集都不在 RL 训练数据里。
- 对比更大的模型: 51.7% 的 MATH 成绩超过论文表格里 7B 到 70B 的全部开源模型,包括 InternLM2-Math 20B 的 37.7% 和 Qwen 72B 的 35.2%,落在 GPT-4(52.9%)和 Inflection-2(34.8%)之间。
- 多数投票: 64 次采样的自洽性把 MATH 提到 60.9%。
- 工具调用推理: 配合 Python,MATH 从 Instruct 的 57.4% 升到 58.8%。
- 训练设置: 策略学习率 1e-6,KL 系数 0.04,每题采样 64 个,最大长度 1024,批大小 1024,每次探索后只更新一步策略。
RL 改变了什么,没改变什么
论文里最有用的分析是图 7。作者分别测了 Instruct 模型和 RL 模型的 Pass@K 与 Maj@K:RL 提升了 Maj@K,没有提升 Pass@K。直白地说,RL 后的模型并没有解出 Instruct 模型完全解不出的题,只是更常把正确答案排到分布顶端。作者原话是,提升来自让输出分布更稳,而不是基础能力增强。引用 GRPO 收益时应该保留这个框架,它也解释了为什么可验证奖励上的 RL 在数学和代码上格外有效:基准测的正是”更稳定地选对答案”。
局限与存疑
RL 部分的证据面很窄:一个 7B 模型、一个从 DeepSeekMath-Base 训出来的奖励模型,训练题目又恰好取自报告头条数字的那两个基准。CMATH 和 MGSM-zh 上的域外收益令人鼓舞,但幅度不大。论文没有在相同数据和奖励模型下跑一个受控的 PPO 基线,所以”GRPO 用更少显存达到 PPO 的效果”在这篇论文里是设计层面的论证,不是实测结论;后来的 CPPO 和 N-GRPO 都把 GRPO 当作要超越的基线,而不是回头补这个对比。过程监督和迭代 RL 在正文里被描述为有提升,但数字远不如结果监督的头条醒目。组内归一化优势还有一个论文没讨论的失效场景:当一组样本奖励全相同时,标准差为零,这道题就贡献不了梯度,后来的 GRPO 变体因此加了过滤或动态采样。
该读论文还是读这页
如果你要实现 GRPO,读论文,第 4 节和附录 A 给出了目标函数、优势公式,以及把 SFT、拒绝采样、DPO、PPO、GRPO 统一成一个梯度模板的视角。如果你想看”组内相对优势”和”学习出来的 critic”两条路线的正面比较,看 GRPO 和 PPO 的区别。如果只要数字,上面的表格就是这篇论文。
常见问题
DeepSeekMath 里的 GRPO 方法是什么?
GRPO 是去掉价值模型的 PPO 变体。对每道题采样一组答案,用奖励模型打分,每个答案的奖励减去组均值、除以组标准差,作为它全部 token 的优势;对参考模型的 KL 惩罚放在损失里而不是奖励里。
GRPO 让 DeepSeekMath 的 MATH 和 GSM8K 结果提升了多少?
从 DeepSeekMath-Instruct 7B 的 MATH 46.8%、GSM8K 82.9% 出发,用约 14.4 万道题做一轮 GRPO 训练,得到 DeepSeekMath-RL 7B 的 MATH 51.7%、GSM8K 88.2%,思维链推理,不用工具。
DeepSeekMath 有没有直接对比 GRPO 和 PPO?
没有。论文从显存和方差的角度论证 GRPO,并给出包含 PPO 的统一范式,但没有在相同数据和奖励模型下训练一个 PPO 基线。51.7% 是 GRPO 相对 SFT 起点的结果,不是 GRPO 相对 PPO 的结果。
为什么论文说 RL 提升 Maj@K 而不提升 Pass@K?
因为两者都测了。RL 之后,多数投票答案正确的概率上升,而 K 个样本里至少一个正确的概率没有变化。作者把这解读为 RL 让输出分布更集中,而不是增加了新的解题能力。