
Moebius 和 ByG 对比:0.22B 修复模型与免配对数据训练
Moebius 用 lambda 模块加潜空间蒸馏把修复模型压到 0.22B 仍追平 FLUX;ByG 完全不靠配对数据训练图像和视频编辑模型,视频人工评测胜率 75.3%。
同一个前提,两笔不同的账
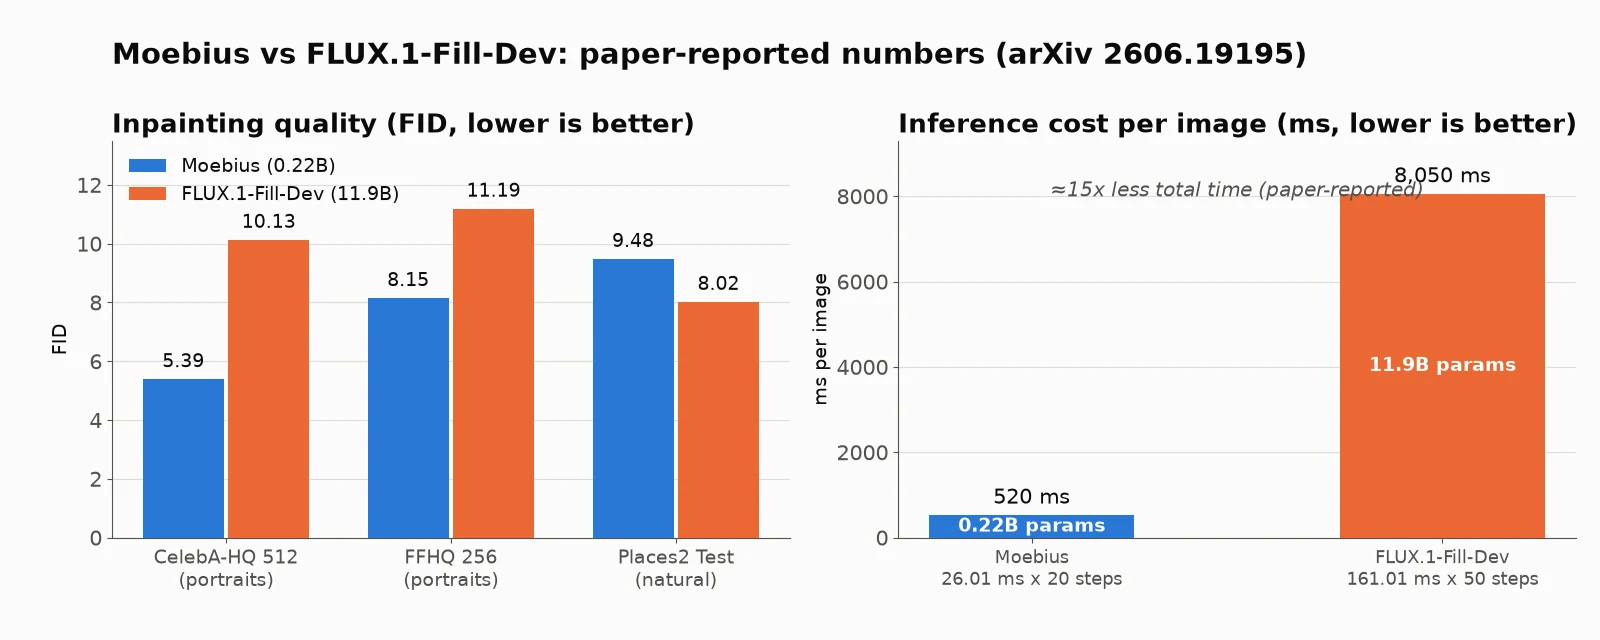
图像和视频编辑贵在两处。一是推理贵:FLUX.1-Fill-Dev 这类工业级修复模型有 119 亿参数,每步采样 161.01 毫秒、默认跑 50 步,大多数产品按这个成本规模化 serving 根本扛不住。二是数据贵:指令式编辑模型通常靠「改前图 + 指令 + 改后图」的配对样本训练,图像的配对数据构建已经很贵,视频几乎不可能,因为你得同一段素材渲染两遍、只改一个受控变量。
Moebius砍的是第一笔账,Bootstrap Your Generator(ByG)砍的是第二笔账。两者不是对手,回答的问题不同,原则上甚至可以同时用;但 2026 年任何要做编辑功能的团队两笔账都得算,所以这两篇论文适合放在同一篇对比里讲。
关键数字
| 维度 | Moebius | ByG | 同口径? |
|---|---|---|---|
| 训练目标 | 蒙版式修复(latent diffusion U-Net) | 指令式图像与视频编辑模型 | 任务不同,从未同场竞技 |
| 规模 / 底座 | 0.22B 参数,自研轻量骨干 | 冻结底座:FLUX.1-dev(图像)、Wan2.2(视频) | 否 |
| 训练信号 | 0.86B PixelHacker 教师的潜空间蒸馏,四个损失叠加 | 冻结底模自身的指令线索 + 循环一致性,零配对样本、无奖励模型 | 否 |
| 头条质量数字 | CelebA-HQ 512 FID 5.39,FLUX.1-Fill-Dev 为 10.13 | 视频编辑人工对比胜率 75.3%(±2.2),对手是监督训练的 Ditto | 指标不同,不可直接比 |
| 输在哪 | Places2 Test 自然场景 split:9.48 对 FLUX 8.02 | GEdit-Bench 通用图像编辑:有竞争力但不占统治地位 | 不适用 |
| 成本主张 | 26.01 毫秒/步 × 20 步,总推理时间约为 FLUX 的 1/15 | 每步训练耗时约 2.9 秒,是监督训练(0.97 秒)的 3 倍左右 | 成本维度不同 |
| 数据需求 | 常规配对修复训练数据 | 约 330 组无标注图像元组;视频模型用 328 条生成片段 | 不适用 |
| 泛化检验 | 零样本 LVIS / DeepFakeFace FID 17.81 / 15.32,贴近 FLUX 的 14.52 / 12.24 | 未见过的 3D-CGI 视频转换上胜率 85.0%,Ditto 仅 15.0% | 不适用 |
这张表要读成两个各自成立的声明,而不是一张排名。每一行都是 Moebius 论文的一个数字配 ByG 论文的一个数字,没有任何实验把两者放进同一测试协议,任务不同、指标不同、对照基线也不同。
Moebius 的做法:先把骨干砍小,再用教师把表示填回去
Moebius 要解决的问题是表示瓶颈:把扩散骨干从 119 亿参数砍到 2.2 亿,模型表达上下文的能力跟着崩塌,质量断崖式下跌。论文 Table 2 把这条悬崖量化了:同一个紧凑骨干,不加蒸馏训练 FID 33.21,加上蒸馏配方降到 24.73。小架构是必要的,但远远不够。
骨干围绕一个重复单元重建,即 Local-lambda Mix Interaction block。Local-lambda 把邻近空间上下文压缩成固定大小的线性矩阵(lambda),上下文混合的开销因此是常数级,不再随 token 数二次增长;Interactive-lambda 对全局语义先验做同样的压缩;Mix-FFN 负责前馈段。正是这次替换把模型缩小了:标准全局注意力骨干要 5.26 亿参数,与 4.85 亿参数的 lambda 设计质量基本打平(无蒸馏时 FID 33.21 对 32.75),最终出货设计压到 2.26 亿参数、154 GFLOPs,用约 1.7 个 FID 换 53% 的参数削减。
真正让 0.22B 具备竞争力的,是蒸馏而不是模块设计。教师是 0.86B 的 PixelHacker,学生完全在潜空间对齐教师的内部表示,省掉像素空间蒸馏昂贵的像素解码。四个损失的消融显示每一项都在干活:只有粗粒度 KD 时 FID 高到没用(74.20),加细粒度 KD 降到 36.17,加任务损失到 32.59,感知损失落地在 26.43。模块让模型变小,教师信号负责把压缩撕开的口子填上。
ByG 的做法:让底模自己监督自己
ByG 问的是另一个问题:冻结的底模生成器既然已经「知道」一个编辑该长什么样,能不能只把这份知识提取出来?它不用配对数据,而是从冻结底模里抽取指令遵循线索;也不用奖励模型,而是用循环一致性(正向编辑、再反演,应能还原原图)来保护结构。监督信号的本质,是底模跟自己「吵架」,吵到输出既听指令又保住身份。
让这一切可训练的关键工程是 gradient routing over clean predictions。流匹配模型在含噪状态上训练,但 ByG 在乎的损失(编辑是否听指令、结构是否保住)只有在清晰图像上才有意义。用单步粗估的清晰图打分,估计太糊、梯度太差;彻底去噪又断了反向传播,因为多步采样器没法干净求导。ByG 把两件事拆开:前向传播把损失挂在多步清晰估计上(图够清晰,损失才有意义),反向传播时让梯度绕过这个估计、走单步预测。这是适配流匹配的直通估计器,堵上了训练与推理之间的分布差;同一道缝隙,Flow-OPD走的是蒸馏路线。
消融实验(0–10 分制,分别打编辑成功度和源结构保持度)毫不客气地指出谁在扛结果:拿掉方向正则化损失,模型直接退化成复印机:编辑成功度 0.633,源保持度 9.767,等于学会复制输入、无视指令。拿掉自举(bootstrapping)迭代,编辑成功度掉到 5.517。梯度路由和循环一致性单独看贡献反而没那么大(8.917 和 8.983,全套模型是 8.317,这两项更像在用成功度换保持度)。正则化器和自举循环才是防止训练退化的顶梁柱;只抄「巧妙的梯度路由」而不抄整套配方的复现者,大概率会眼看着模型崩掉。流匹配这套 formulation 承自 Stable Diffusion 3一路的工作。
你到底在为什么掏钱
Moebius 买的是 serving 经济学,但质量分 split 看。 人像上它对 FLUX.1-Fill-Dev 是 FID 5.39 对 10.13(CelebA-HQ 512)、8.15 对 11.19(FFHQ 256);到了更难的自然场景 Places2 Test,胜负反过来:FLUX 8.02,Moebius 9.48。用户研究指向同一个结论:评审明显偏爱 Moebius 胜过 100 亿级通用模型,尤其人脸,但它对自己的教师也只是追平。诚实的表述是「视 split 而定追平或反超,参数不到对方 2%」,而不是「全面击败 FLUX」。约 15 倍的总时间优势混了两个合法因素(每步 26.01 毫秒对 161.01 毫秒,以及 20 步对 FLUX 默认 50 步),步数拉平的话倍数会缩水,不过单步优势本身就超过 6 倍。这和 DistilBERT那类经典压缩是同一杠杆,只是作用对象从 Transformer 编码器换成了扩散骨干。
ByG 买的是数据独立,代价是训练算力和脆弱的优化。 头条结论是底模语义可以同时顶替配对数据和外部奖励模型:图像模型用约 330 组无标注元组、8 张 H100 训 30000 步;视频模型用 328 条生成片段训 750 步。代价是真的:训练每步约为监督编辑的 3 倍慢(2.9 秒对 0.97 秒),而且优化很脆,命脉系在一个拿掉就崩的正则化损失上。天花板则是底模本身:ByG 只提取线索,不教冻结生成器任何新东西,底模不知道的概念,编辑也就无从谈起。
局限与存疑
Moebius 是专家不是通才。它针对自然与人像场景的蒙版修复训练,不是文本指令式编辑,所以对 FLUX 的公平比较仅限于两者都能做的修复任务。它的天花板是教师:在上下文极薄的超小背景区域,它可能丢失细节或给出不够可信的纹理,这恰恰是 0.22B 容量预算咬人的地方;Places2 Test 的结果也证实难的一般场景差距尚未完全闭合。15 倍这个数混合了单步时延和步数两个来源。蒸馏阶段的训练成本没有公开数字,结果也只覆盖两个固定分辨率领域。
ByG 那条「击败用数百万样本监督训练的模型」的声明,要按它自己页面给的口径小心读。用户研究规模很小:8 个评审、238 张票、一致性中等(Fleiss κ = 0.44);视频部分每个方法采 4 条输出、人工挑最好的一条再给评审看,这个协议偏爱方差大的方法。更硬的证据是结构性指标:DINO 结构相似度 0.718 对 Ditto 0.536,CLIP 方向一致性 0.104 对 0.091,运动保真 0.715 对 0.616,以及在没见过的 3D-CGI 视频转换上 85.0% 对 15.0% 的比分。视频测试集是作者自组的 119 个任务,没有在与监督基线主场对等的大规模自动评测(如 FID),而那个一碰就崩的正则化损失意味着超参窗口很窄。可控视频编辑的大图景,另见 LoomVideo和指令基准 CoVE-Bench。
怎么选
这是一道资源题。如果你的产品做蒙版式修复(去物、补洞、人像与自然场景),serving 账单是痛点,Moebius 是直接答案:在它主场的 split 上接近 FLUX 的质量,参数不到 2%,推理时间约 1/15,但要接受难的自然场景仍偏向 100 亿级通用模型。如果你的痛点是目标领域根本不存在配对编辑数据,尤其是视频,受控的前后对照样本几乎造不出来,ByG 是直接答案:零配对样本、无奖励模型,增益集中在长尾风格和运动类编辑上,代价是 3 倍的单步训练成本和一个需要盯着的脆弱优化。如果两笔账都疼,两篇论文里没有任何东西阻止组合使用:lambda 骨干是 serving 侧优化,自举训练循环是数据侧优化,二者动的是栈上不同的层。但这个组合是推断,不是已发表的结果。
常见问题
Moebius 全面强于 FLUX.1-Fill-Dev 吗?
不是。人像上它赢得干脆(CelebA-HQ 512 FID 5.39 对 10.13,FFHQ 256 8.15 对 11.19),自然场景的大小孔 split 也占优;但更难的自然场景 Places2 Test 上胜负反过来:FLUX 8.02,Moebius 9.48,256 split 也是 FLUX 领先。准确的表述是「视 split 而定追平或反超,参数不到对方 2%、推理时间约为其 1/15」。
ByG 真的完全不用配对数据和奖励模型吗?
真的。ByG 零配对前后编辑样本、无外部奖励模型。唯一的监督来自冻结底模生成器:从底模抽出的指令遵循线索,外加保结构的循环一致性损失。图像模型从约 330 组无标注元组学习,视频模型从 328 条生成片段学习,冻结底座分别是 FLUX.1-dev 和 Wan2.2。
两篇方法里各自最承重的部件是什么?
Moebius 这边是蒸馏:同一个紧凑骨干,不加蒸馏 FID 33.21,加了 24.73;四损失潜空间栈(粗 KD、细 KD、任务损失、感知损失)才是填上小架构撕开的表示瓶颈的东西。ByG 这边是方向正则化损失:拿掉它,编辑成功度掉到 0.633(满分 10),源保持度反而升到 9.767,模型学会了复制输入、无视指令。
Moebius 和 ByG 能组合吗?
两篇论文都没有任何东西禁止组合。Moebius 换掉注意力密集的骨干、用 lambda 模块省 serving 成本;ByG 用自举线索替换配对数据。一个管推理,一个管训练数据,所以「lambda 骨干 + 自举监督」训练的编辑模型是合理设计。但没有已发表的结果训过这个组合,把它当值得做原型的假设,别当有证据背书的推荐。