
低成本训练的三条路线:HRM-Text、Lens 与 Chinchilla 对比
HRM-Text 赌架构(1B、1500 美元),Lens 赌数据密度(19.3% 算力),Chinchilla 赌预算分配(同 FLOPs)。同一目标,三根不同杠杆,三种不同翻车方式。
三篇论文回答的是同一个问题
训练成本是每个模型在有用之前必须交的税。本页对比的三篇论文用三个不同的杠杆砍这笔税,值得分开看,因为媒体标题里它们常被糊成同一个「高效」:
- HRM-Text 改的是架构和目标函数:1B 的分层循环模型,只在指令-回答对上做训练,损失只算回答部分的 token。
- Lens 改的是数据:8 亿张图配平均约 109 词的 GPT-4.1 长标注,让每个梯度步携带更多信号。
- Chinchilla 模型和数据都不改,改的是预算分配:同样的 FLOPs,从大而欠训的模型挪到小而训透的模型。
每一篇都押注「自己的杠杆是主导项」。三篇之间没有任何受控对照,所以诚实的对比是:各自声称什么、证据是什么、悄悄假设了什么。
关键数字
| 测量项 | HRM-Text | Lens | Chinchilla | 同一套评测? |
|---|---|---|---|---|
| 参数量 | 1B | 3.8B(扩散主干) | 70B | 否,任务不同 |
| 训练数据 | 400 亿唯一 token,只用指令-回答对 | 8 亿图文对(Lens-800M) | 约 1.4T token | 否 |
| 报告的训练成本 | 约 1500 美元,16 张 H100 跑 46 小时 | 约 19.2 万 A100 GPU 时 | 与 280B Gopher 同 FLOPs | 否 |
| 核心效率主张 | 比 2-7B 开源基线少用 100-900 倍 token、省 96-432 倍算力 | 约为 Z-Image 31.4 万 H800 GPU 时的 19.3% | 模型小 4 倍、数据多 4 倍,预算相同 | 各对各的基线 |
| 主要质量分数 | MMLU 60.7、ARC-C 81.9、DROP 82.2、GSM8K 84.5、MATH 56.2 | GenEval 0.525、OneIG 0.557、LongText 0.930 | MMLU 平均 67.5%,超过 Gopher 280B、GPT-3 175B、MT-NLG 530B | 否 |
| 推理成本 | 非论文重点 | 单张 H100 生成 1024px 图 3.15 秒(Turbo 4 步 0.84 秒) | 微调和 serving 都比 Gopher 「显著更便宜」 | 否 |
| 赢过的基线 | Llama 3.2 3B、Gemma 3 4B、OLMo 3 7B、Huginn、Ouro | 同分数段的 6B+ 文生图模型 | Gopher、GPT-3、Jurassic-1、MT-NLG | 否 |
看空着的格子,和看填着的格子同样重要:不存在一个把三者放进同一评测的场景,因为它们解决的问题不同。真正可比的是结构:每篇论文都找到了标准训练里「花了算力却产不出信号」的那一处,然后恰好删掉那一处。
杠杆一:架构加目标(HRM-Text)
HRM-Text 认为预训练最大的浪费在目标函数而不在模型结构。原始网页文本上的 next-token prediction,大部分梯度都花在预测连接词上;标准 Transformer 又需要极大深度才能堆出有效计算。它的修法有二:一是分层循环架构——慢的战略层低频更新、快的执行层每个战略步内多次迭代,让 1B 模型拥有远超参数量的「有效深度」;二是只在指令-回答对上训练,用 PrefixLM 遮罩让指令部分双向阅读、损失只落在答案 token 上。
数字如果成立非常惊人:400 亿 token、约 1500 美元,拿下 MMLU 60.7、GSM8K 84.5。但注意这个赌注的前提:你得接受循环训练的失稳(论文的 MagicNorm 和渐进式信用分配就是为了压住深层 recurrent 的爆炸),得能搞到 400 亿 token 量级的高质量指令对语料,还得接受它的评测集(MMLU、GSM8K、MATH、ARC、DROP)恰好是这套设计最占优的评测集。开放生成、长文连贯性、从原始文本里「顺带」吸收广博世界知识这些能力,论文并未建立可比性。
杠杆二:数据密度(Lens)
Lens 的主张正好相反:架构没问题,是数据在挨饿。短标签式标注意味着文生图模型要看过几百万张图才学得会一个概念,于是 Lens 一次性付钱让 GPT-4.1 为 8 亿张图写平均约 109 词的长标注(覆盖布局、属性、文字内容、风格),训出的 3.8B 模型拿到 GenEval 0.525、OneIG 0.557,训练算力约为 Z-Image 的 19.3%。
标注长度消融实验是把它和口号区分开的关键:「更密的数据胜过更多参数」这个说法以前就有,且很难归因, Lens 至少让这根杠杆真实移动过。代价同样具体:19.3% 是 A100 时对 H800 时、且只对 Z-Image 一家的比例,是示意性的;GPT-4.1 标注这一趟本身的算力和钱在 headline 数字之外,而且前提是拿得到 GPT-4.1 级别的标注器;GenEval 0.525 是「有竞争力」而非 SOTA,「比肩 6B+ 模型」的诚实读法是「处于同一区间」。
杠杆三:预算重分配(Chinchilla)
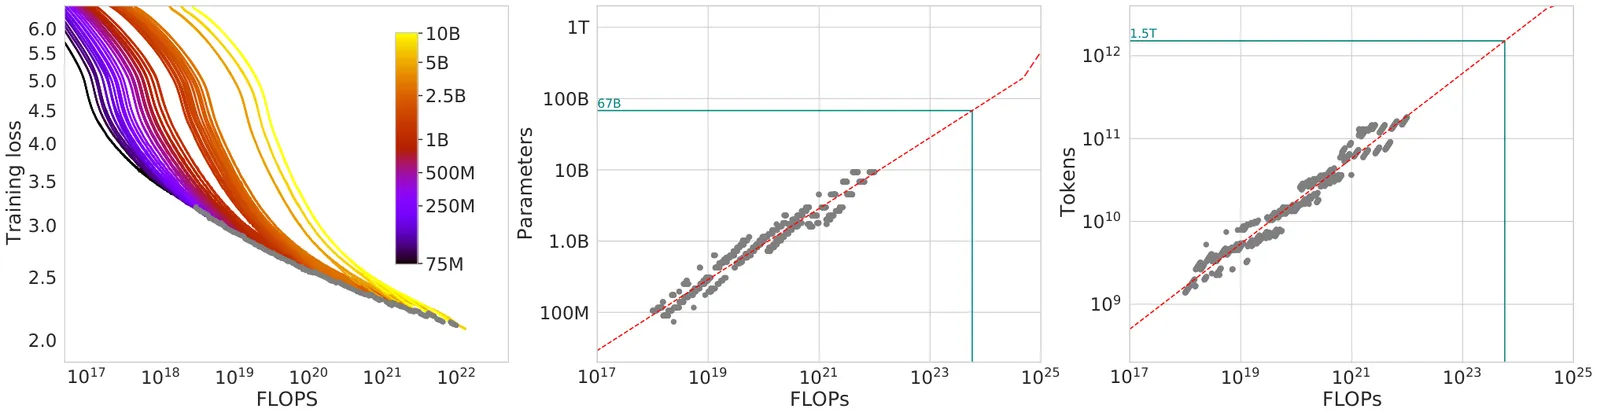
Chinchilla 是另外两篇暗中辩论的基准线。它不动架构、不动数据管线,靠拟合 400 个(70M 到 16B+ 参数、5B 到 500B token)模型的损失面,证明参数量和 token 数的指数大致相等,固定预算下应该等比例 scaling。2020 年代那种把算力几乎全砸进参数的做法,让 Gopher 这样的巨头普遍欠训。Chinchilla 就是把 Gopher 的预算重新切分:70B 参数、约 1.4T token、同样的 FLOPs,MMLU 平均提升 7 分以上到 67.5%。
它至今仍是默认方案的原因,是它做的假设最少:不需要标注器、不需要精心整理的指令语料、不需要训练稳定性的研究攻关。已知边界也测绘得最清楚:这套定律优化的是单次训练的训练损失,高并发 serving 的场景会故意训过 Chinchilla 最优点来省推理成本(LLaMA 论证);「数据翻倍」这半条规则,在高质量 token 变得稀缺时也不再免费。
怎么选
- 只想要最稳的省法、不想引入新组件:Chinchilla 式重分配。模型小一号、数据多一倍、FLOPs 不变——三条杠杆里只有它有闭式规则,且有五年的复现积累。
- 付得起一次性标注成本:Lens 式数据密度。经济学是「标注器只付一次,GPU 时数省到永远」,且在同一份数据集上的每次后续训练都能复利。
- 掌控整个训练栈、能承受较窄的证据基础:HRM-Text 式架构加目标。纸面收益最大(数量级),风险也最大(稳定性工程、被评测集塑造的证据、失去原始文本这条退路)。
局限与存疑
三根杠杆并不互斥,也没有人做过把杠杆叠起来的实验:一个小型循环或长标注训练的模型,按 Chinchilla 最优预算训练,并且在广谱开放任务而非推理密集型套件上评测。在那之前,请把每篇论文当作自己那根杠杆的存在性证明,而不是杠杆之间的排名。唯一可靠的共同教训更安静:三篇论文的赢法都是先找到标准训练里花掉算力却不产生信号的地方,然后恰好把那一处删掉。
常见问题
三者谁单位质量最便宜?
单位根本不同,没法排。HRM-Text 报的是美元和语言模型基准分;Lens 报的是 GPU 时和 GenEval;Chinchilla 报的是 FLOPs 和 MMLU。硬排一个「最便宜」是编造。能说的只有:绝对成本最低的是 HRM-Text(1500 美元);相对省幅主张最大的是 Lens(对手的 19.3%);被复现最多的是 Chinchilla。
大学实验室复现 HRM-Text 现实吗?
训练本身原则上可以:16 张 H100 跑 46 小时,是一个机时周的事。难的是两样:足够高质量的 400 亿 token 指令对语料,以及压住深层循环训练失稳的工程能力——论文提出 MagicNorm 和渐进信用分配,正因为朴素训法会直接爆。
Lens 打赢更大的文生图模型了吗?
没有,看分数就知道。GenEval 0.525、OneIG 0.557 是把 3.8B 送进了 6B+ 模型的同一区间,而这正是重点:零头算力换近似质量。如果目标是绝对最高分,这根杠杆不对。
2026 年了,Chinchilla 配方还对吗?
作为默认值仍然对,但要带两条后来的修正:用量极大的模型会故意训过最优点来省推理成本;数据稀缺让「数据翻倍」这半边越来越难执行。