人格问卷 vs 循证评测:大模型的性格测试可信吗
两篇论文用真实数字检验人类式人格测评对大模型是否有效:问卷自评与真实行为一致性仅 0.26-0.31;MLLM 过半数答对的人格判断靠的是错误线索。
两种工具,同一个承诺
给语言模型做人格画像,已经成了一个小产业:把大五人格量表(BFI)或肖像价值观问卷(PVQ)丢给模型,读出它的 Likert 自评分,然后宣布它的「性格」;再让多模态模型看一段短视频,给片中人打外向性分数,用于招聘初筛或广告定向。这两种做法共享同一个假设:经过人类验证的整齐量表,换到模型身上仍然量的是同一个东西。
本指南背后的两篇论文分别在不同的媒介上检验了这个假设。人格问卷为何测不准大模型的真实行为(首尔国立大学,2025)在八个开源模型上,把问卷自评和真实提问下生成概率所测得的行为放在一起对照;Perception or Prejudice(2026)造了含 1,104 段视频的 MM-OCEAN 基准,专门检查 MLLM 的大五评分是否真的锚定在可观察的行为证据上,覆盖 27 个模型。两篇论文都不否认模型可能存在稳定倾向;它们论证的是:我们用来测这些倾向的工具,早已悄悄不再测行为了。
关键数字
| 维度 | 心理问卷(BFI / PVQ) | MM-OCEAN 循证人格推理 |
|---|---|---|
| 工具 | 经过验证的人类自评量表:44 题与 10 题 BFI、40 题与 21 题 PVQ | 1,104 段视频、5,320 道循证选择题、约 13,500 条人工核验的行为观察 |
| 声称测什么 | 稳定的价值观与大五人格倾向 | 锚定在可观察行为上的表观人格评分 |
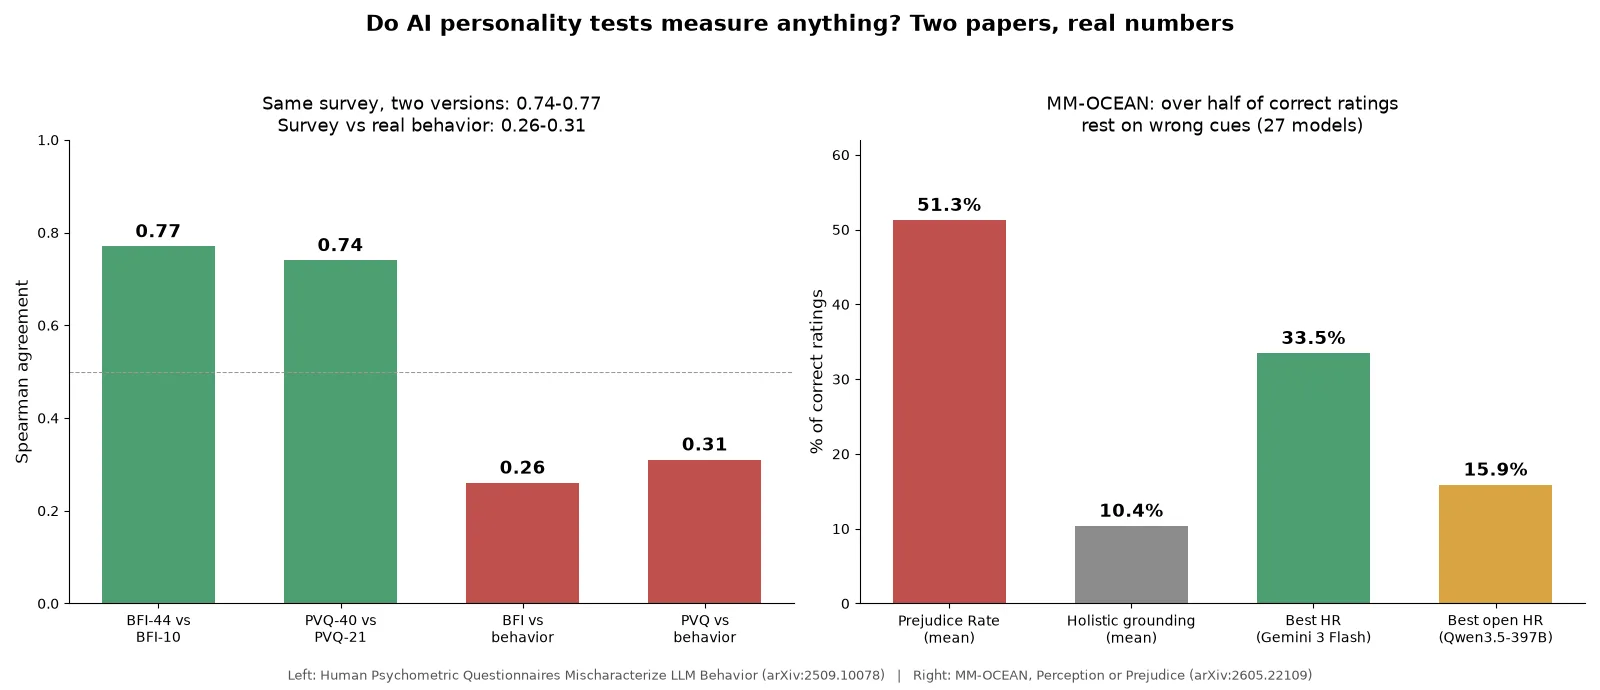
| 头条失败数字 | 自评与真实行为一致性仅 Spearman 0.26(BFI)、0.31(PVQ) | 平均 Prejudice Rate 51.3%;平均 Holistic-Grounding Rate 仅 10.4% |
| 同方法基线 | 同一问卷两个版本一致性 0.74-0.77 | 人工标注者对判定标签的一致性为 77% |
| 揭示的根因 | 题目泄露词汇线索:构念识别 F1 在问卷题上 0.69-0.83,真实情境仅 0.09 | 瓶颈在感知:空间定位 30.7%、微表情识别 34.6%,时序因果推理达 64.8% |
| 因子结构 | 问卷内题目一致性 eta 方 0.526,真实生成塌到 0.040(p < 0.01) | 用四种失败率(PR、CR、IR、HR)取代单一准确率 |
| 敏感性检验 | 人设引导让问卷答案偏移 62/80(p < 0.001),真实生成仅 40/80(p = 0.54,等同瞎猜) | 闭源对开源:评分差距 5.6 分,循证差距 26.6 分 |
| 最好成绩 | 没有任何问卷画像对行为的预测超过 0.31 | Gemini 3 Flash 居首,HR 33.5%、PR 17.2%;最佳开源模型 Qwen3.5-397B 为 HR 15.9%、PR 41.5% |
左列的核心结论:你选哪种测法,比你想测的特质本身更影响结论。同一问卷两版本之间 0.74-0.77 的一致性才是有效工具的样子,而对行为只有 0.26-0.31。右列是多模态领域的镜像:评分准确率与真实感知几乎脱钩,而这恰恰是单一榜单分数会掩盖的事实。
问卷为何给出整齐的空数字
问卷那篇揭示的机制值得细读,因为它远不止适用于人格测试。人类问卷题目天生透明:「忠诚对他很重要」直接昭告在测哪种价值。对人来说透明是优点,因为受试者并不知道计分键;而大模型连心理测量学的文献都读过。给它一道 BFI 题目,它以 0.69-0.83 的 F1 认出构念,然后输出社会期许的答案。把线索抽掉,像真实用户提问那样,构念识别跌到 0.09,那个表面特质也不再预测任何行为。
人设实验是最干净的证明。给模型套人口学人设,问卷答案在 80 次检验里有 62 次朝符合人类的方向偏移(p < 0.001);去看它真实情境下的生成,同样的人设只让行为动了 40 次(p = 0.54,与瞎猜无异)。问卷看到了一个行为里并不存在的人格。数字本身就说完了:内部整齐(eta 方 0.526),行为空洞(0.040)。
MLLM 为何答对却看错
MM-OCEAN 那篇在视觉领域打出同样一击。它的 Grounded Personality Reasoning 任务要求模型同时做三件事:给出 1-5 分的大五评分(T1),引用可观察行为作解释(T2),回答结构化问题把判断钉在具体线索上,比如微表情、空间位置、时序因果链(T3)。头条指标是 Prejudice Rate:答对的评分里有多大比例锚错了线索。27 个模型平均 51.3%。超过半数的正确人格评分,本质上是靠第一印象蒙对的。
这个任务的拆解才是贡献所在。单一准确率会显示模型在人格评分上表现尚可;把输出拆成 PR、Confabulation Rate、Integration-failure Rate 与 Holistic-grounding Rate 四种失败率,才能看清它们在哪里崩。瓶颈在感知而非推理:时序因果推理平均准确率达 64.8%,空间定位只有 30.7%,微表情识别 34.6%。模型对行为的推理远好于对行为的感知。闭源与开源的差距(评分差 5.6 分,循证差 26.6 分)也印证了:贵的能力是找到证据,不是输出一个像样的分数。即便是榜首 Gemini 3 Flash(HR 33.5%),每三次判断也有两次没能完整循证。
共同教训:构念效度不等于行为效度
并排放,两篇论文是同一个实验跑在两套仪器上。问卷篇证明一个测量可以在人类意义上构念有效(自洽、可因子化、对人设有反应),却完全预测不了模型的行为;基准篇证明一个输出可以在榜单意义上准确,却可以在没有感知的情况下产出。两种失败在拿行为或证据核对之前,都像是测量的成功。
这也是两篇论文都不接受「反正模型就没有人格」这个安慰剂的原因。问卷作者明确指出,结果证明的是问卷无法预测行为,而不是模型没有稳定倾向,一个真正基于行为的工具或许仍能测到真东西。MM-OCEAN 作者也强调,基准测的是 15 秒单说话人英语片段里的表观人格,不是自我报告的真值,且它是诊断性的而非处方性的。两篇共同排除的是更窄也更有用的一点:漂亮的分数不是其所声称之物的证据,任何拿这种分数做认证、招聘或定向的人,量的都是量表的表面,而非模型的行为。
怎么选
两个工具都不要用来「认证」任何东西。站得住脚的用法更窄:
- BFI/PVQ 式问卷只配当一种红队探针,用来测模型如何处理带诱导、漏线索的措辞,因为这恰恰是它实际在量的东西。若要做价值观或行为审计,用真实提问下不带词汇 giveaways 的行为探测,这才是第一篇论文提出的更难但更可信的标尺。
- 评估任何为多模态系统、其输出要为关于人的决策背书时,用 MM-OCEAN 式的循证拆解。报告 Holistic-grounding Rate 与 Prejudice Rate,别报评分准确率。闭源与开源 5.6 分的评分差距,在 26.6 分的循证差距面前是噪声。
- 两者都不要用单一榜单分数。两篇论文证明,聚合正是失败藏身之处:同问卷一致性 0.74-0.77 很好看,而对行为只有 0.26-0.31;评分准确率尚可,而 51.3% 的正确评分建立在偏见之上。
局限与存疑
问卷研究覆盖四个家族的八个开源模型(Gemma 3、Qwen 2.5、Qwen 3、GPT-OSS),GPT-4 级、Claude、Gemini 等闭源前沿模型缺席,它们在任一探针下可能表现不同。它的行为测量(价值取向选项上的生成概率)本身也是构造出来的代理,不是原始部署行为。日常情境由作者自行整理,覆盖面与文化框架存疑。
MM-OCEAN 测的是单数据集、短时长、单语种、单说话人片段里的表观人格,不是自我报告的真值;模型完全可能以人类也会错的方式「错」。其 T2 推理由 GPT-4o-mini 而非人类评判,引入了该评审自身的盲点。且它是诊断性的:清楚展示了偏见缺口,却没有提出任何训练方法来补上,循证能力能否训练出来仍是开放问题。两篇合起来还留下一个建设性问题:若想为模型造一个真正基于行为的人格或价值观工具,目前还不存在。
常见问题
大模型有人格吗?两种评测方法的对比
这两篇论文不回答这个问题。它们证明的是常用的仪器(大五问卷、第一印象视频评分)给出的分数追踪不到行为和证据。模型是否存在稳定倾向、能否被更好的工具测到,仍然开放。
大五人格问卷的结果能信吗?
作为行为预测器不能。问卷研究中,BFI 自评画像与真实行为的一致性仅 Spearman 0.26,而两个 BFI 版本之间是 0.77。分数内部自洽,却追踪不到模型实际做了什么,因为题目自带词汇线索,模型认得出来(F1 0.69-0.83)并顺着答。
MM-OCEAN 基准的 Prejudice Rate 是什么?
答对的评分中,没有锚定在正确行为线索上的比例。27 个模型平均 51.3%,即大多数正确评分是对的理由错误的答案。最好的模型 Gemini 3 Flash 仍有 17.2% 的 Prejudice Rate。
为什么循证比评分难?方法层面的区别
评分只需要一个像样的分数,循证却要求模型定位具体的视觉证据。闭源对开源,评分差 5.6 分,循证差 26.6 分;最弱的感知类目是空间定位(30.7%)与微表情识别(34.6%),远低于时序因果推理(64.8%)。
人设提示如何改变模型的行为?
多数情况下它只改变问卷答案。人设引导让问卷答案在 80 次检验中 62 次朝人类方向偏移(p < 0.001),而真实生成行为只动了 40 次(p = 0.54,等同瞎猜)。纸面上的人格是真的;行为层面的人格,按这份证据,基本是化妆。