
MM-OCEAN 对比 Robust-U1:诊断 MLLM 幻觉,还是修好像素
MM-OCEAN 测量多模态模型有多少次答对了却没用对证据;Robust-U1 则训练模型先修复破损像素再作答。一个是诊断仪,一个是修理铺。
同一个病根:答案对了,感知没对
多模态大模型有两类典型的可靠性翻车。第一类是偏见:模型答对了,但理由和它看到的那张图毫无关系。第二类是退化失明:图本身就破损了,模型却对着不存在的像素侃侃而谈。本页两篇论文打的是同一个病根,模型的答案可以看上去没问题,而它的感知根本没工作,只是方向完全相反。
MM-OCEAN 是一个基准。它什么都不修,只测量「正确答案建立在错误证据上」的频率,并且把失败拆成几种模式,这是单一准确率数字藏不住的信息。Robust-U1 是一个训练方法。它不测接地,而是教模型重建被腐蚀的视觉内容,然后同时基于原图和修复图作答。一个诊断,一个修理。真正的问题是:你的系统缺哪一个。
MM-OCEAN 测什么
这个基准把任务形式化成「接地人格推理」(GPR):一次判断必须同时产出三样东西,分别是大五人格评分(T1)、引用可观察行为的开放式解释(T2)、以及把判断钉死在具体线索上的结构化选择题,线索包括微表情、空间位置、时间因果链等(T3)。评分对但线索错,一律算失败。基准本身含 1,104 段视频(取自 ChaLearn First Impressions V2)、5,320 道选择题、约 13,500 条人工核验的行为观察,还加了一个文本泄漏过滤器:凡是不看图只看文字 transcript 就能答的题,全部剔除。裁决标签的标注者一致性为 77%。
MM-OCEAN 报告四种诊断率。偏见率(PR)是头条:评分对、线索错。虚构率(CR)是理由听起来合理、证据却是错的。整合失败率(IR)是线索找对了、结论却下错。整体接地率(HR)是唯一的成功态,要求三项输出完全一致。这套分解就是论文的贡献:评分准确度和真实感知几乎是脱钩的。
Robust-U1 做什么
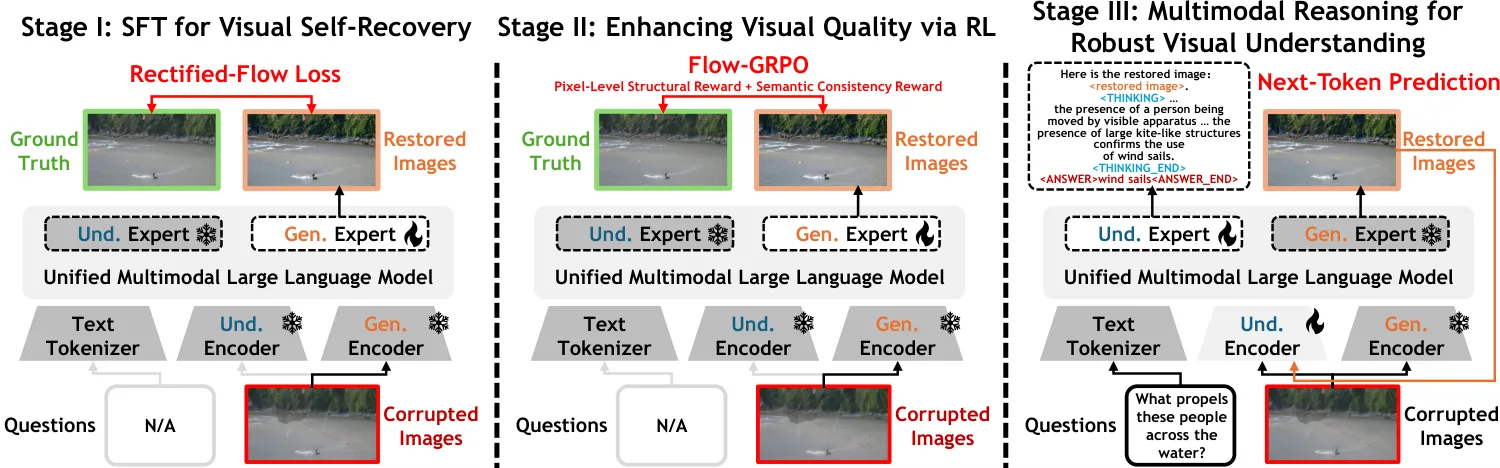
Robust-U1 的主张是:应对画质退化不该止步于说一句「图坏了」。它的管线分三段:先监督微调,让模型学会从破损图映射到干净图;再强化学习,用像素级 SSIM 奖励加语义 CLIP 相似度奖励打磨修复质量;最后让模型同时基于破损图和修复图作答。这个设计针对的是光靠文字推理腐蚀补不上的失败,也就是像素证据真的丢了,同时又比特征对齐类方法更容易检查。论文的驱动性案例是一张退化的驾驶图像:现有模型推理错了方向,而 Robust-U1 修复出的图支持正确答案。
关键数字
两篇论文从不共享基准、任务或评测环境,所以下表没有任何一行是两者正面对决。每一行都应读作「该论文自己报告的数字」,而两边的失败面差异本身就说明问题。
| 测量项 | MM-OCEAN(诊断) | Robust-U1(修复) | 设置与出处 |
|---|---|---|---|
| 头条失败信号 | 27 个模型平均偏见率 51.3% | R-Bench 总分 0.7398,对 BAGEL 0.5770、Robust-R1 0.5017 | 各论文自评 |
| 最严格口径下的成功率 | 平均整体接地率 10.4%;最佳(Gemini 3 Flash)33.5% HR、17.2% PR | 满腐蚀 MMMB:83.18,对 BAGEL 78.48、Robust-R1 75.35 | 无共同指标 |
| 最弱的测量类别 | 空间定位平均 30.7%、微表情检测 34.6%;时间因果推理 64.8% | R-Bench 高退化 CAP:0.7640,对 0.4288 和 0.3484 | 感知类 vs 退化类 |
| 开源对闭源 / 消融差距 | 闭源在评分(T1)仅领先 5.6 分,在接地(T3)领先 26.6 分;最佳开源 Qwen3.5-397B 仅 15.9% HR、41.5% PR | 去掉多模态推理,R-Bench 从 0.7398 跌到 0.6623;去掉任一奖励约剩 0.726 | 均出自各自论文消融 |
| 压力下的稳定性 | 27 个模型含 13 闭源 14 开源;HR 从 0 到 33.5% 的范围说明接地远未饱和 | MMMB 干净图到满腐蚀的跌幅:Robust-U1 1.57 分,BAGEL 3.44,Robust-R1 6.06 | 压力定义不同 |
三个读法值得记住。第一,MM-OCEAN 里闭源对开源「评分差 5.6 分、接地差 26.6 分」说明感知里贵的那部分是定位证据,而不是输出一个像样的分数,而这恰好是修复管线赖以生存的能力。第二,Robust-U1 的消融显示:只有模型真的拿修复图去推理,修复才付费;去掉多模态推理后 0.7398 掉到 0.6623,几乎只比 BAGEL 高一点。第三,两篇论文最弱的类别都在感知侧,说明测量和修理是在从两翼攻同一个病根。
怎么选
MM-OCEAN 的教训是:准确率会藏住机制。一个给人格特质打分的招聘筛查或广告定向系统,平均分可以很好看,而接地几乎为零,这是公平性问题,不只是准确率问题。但这个基准刻意只做诊断:它没有提出任何训练方法来缩小偏见缺口。Robust-U1 是镜像:它在破损输入上展示了真实增益,图像质量和答案质量同步提升,但它自己的页面也承认风险:当腐蚀摧毁了证据本身,修复图会变成「自信却错误的证人」。
两者的失败位置在结构上也不相同。MM-OCEAN 的整合失败率捕捉的是「感知没问题,结论照样下错」的模型,这不是修复能治的。Robust-U1 的失败模式相反:推理没问题,输入证据缺失或被编造。如果把两者串起来,自然的管线是先修复、再在修复图上做接地测量,因为 Robust-U1 改掉的正是 MM-OCEAN 这类评审要看的证据。不过没有任何一篇论文跑过这个组合实验。
落到选择上:
- 你要在主观判断的高风险场景上线,比如招聘筛查、调解助手、类人格个性化:采用 MM-OCEAN 的分解式评估。单一总分分不出模型是审视了证据还是在套刻板印象,四种失败率的拆分是成本最低的判别方式。
- 你的输入是可预期的退化画质,比如行车记录仪、压缩视频流、低照度传感器:Robust-U1 的三段管线是可直接落地的设计,SSIM 加 CLIP 双奖励是个小而可抄的点子。
- 你在做评测而不是产品:先借 MM-OCEAN 的结构技巧,包括按失败模式拆分指标、transcript 泄漏过滤、人工核验线索锚点,再考虑借它的任务。15 秒短视频里的表面人格只是窄代理。
- 你在判断修复对你的场景是否安全:把论文的检查在本地重跑一遍。该方法只在腐蚀可逆时最强;对安全关键细节,要对修复图断言的内容保留不确定性检查。
局限与存疑
两篇论文都不覆盖对方的阵地,缺口还会互相放大。MM-OCEAN 测的是 15 秒、单说话人、英文短视频里的表面人格,且部分由 AI(GPT-4o-mini)当评审,跨文化和长时程感知未验证;它指出了偏见缺口,却没开药方。Robust-U1 主要在自家基准 R-Bench 上评测,MMMB 算外部检验,有总比没有强,但独立 harness 上的外部复现仍缺位,而且「修复图当证据」的风险是断言多于测量。最明显但没人做的实验是组合:先修复再作答,到底降低偏见率,还是只是让编出来的理由看起来更站得住?在那之前,这两篇是互补,不是竞争。
常见问题
MM-OCEAN 和 Robust-U1 哪个对抗幻觉更强?
两者干的活不同,「更强」无从谈起。MM-OCEAN 是基准:它证明 27 个模型里有 51.3% 的正确人格评分建立在错误线索上,但不提供修法。Robust-U1 是方法:它报告 R-Bench 0.7398 对 BAGEL 0.5770,但不测量自己的推理是否接地。前者告诉你有问题,后者补其中一类病因。
Robust-U1 的 R-Bench 分数能和 MM-OCEAN 的接地率直接比吗?
不能。两者没有共享基准、任务、模型集合或评分协议:一个评合成腐蚀下带修复作答的表现,一个评人格视频上的证据接地。任何直接数字对比都没有意义,所以上表每一行都标了设置与出处。
MM-OCEAN 证明了闭源模型感知强于开源吗?
部分是。闭源在评分(T1)只领先 5.6 分,但在接地(T3)领先 26.6 分,说明闭源优势主要在定位证据,而不是输出像样的分数。但最佳开源模型(Qwen3.5-397B)整体接地也只有 15.9%、偏见率 41.5%,连闭源第一名 Gemini 3 Flash 也才 33.5%。按这个标准,谁的感知都谈不上可靠。
Robust-U1 修复出来的图能当证据信任吗?
只在腐蚀可逆时成立。论文自己的局限指出:证据被彻底摧毁时,修复就会变成幻觉;一张看起来更干净的图可能错得让语言模型更难怀疑。满腐蚀下 MMMB 跌幅 1.57 分(对 Robust-R1 的 6.06)确实鼓舞,但涉及安全关键的细节,仍要对修复图断言的内容保留不确定性检查。
一句话:MM-OCEAN 告诉你模型答对是答对了,理由却是错的;Robust-U1 给它第二次睁眼看的机会。原文见 MM-OCEAN 与 Robust-U1。