
SWE-Explore、DeNovoSWE、Claw-SWE-Bench 对比
三篇 2026 年论文拆开代码智能体的得分来源:探索定位卡在 0.15-0.20 行级召回,4818 个任务把 30B 模型提升 8 倍,光换 harness 就摆动 27.4 分。
三个杠杆
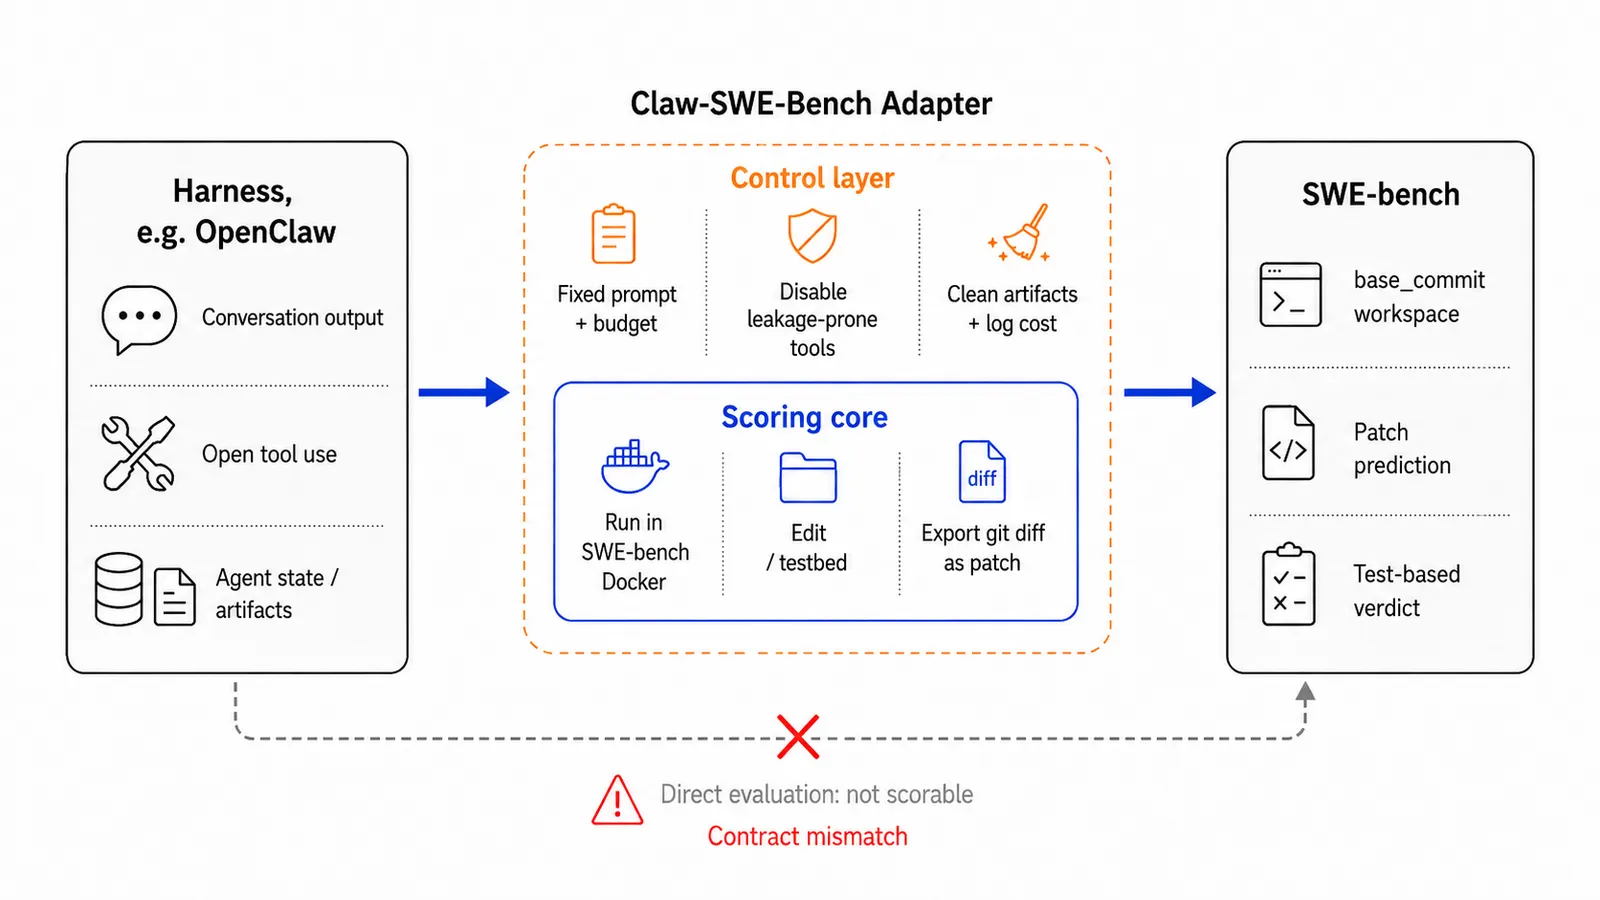
这三篇论文从三个不同环节回答同一个问题:为什么 demo 里很强的代码智能体到了真实仓库还是会挂,以及什么才能真正撬动它们的分数。SWE-Explore 打的是感知环节:智能体动手改代码之前,得在一个没见过的仓库里找到该改的位置,这篇论文把这一步单独拎出来测。DeNovoSWE 打的是训练环节:如果长程整仓任务做不好是因为模型从来没在这类任务上训练过,那就把缺失的数据造出来再微调。Claw-SWE-Bench 打的是 harness 环节:模型外面的脚手架、adapter、提示词管线,而大多数评测根本不把它当回事。
注意三篇里没有一篇是模型本身。这正是重点:其中两篇把模型固定住,只动一个环节,分数变化大得惊人,要是只盯着头条 Pass@1 看,这种幅度会被当成发布了新一代前沿模型。
关键数字
| 维度 | SWE-Explore | DeNovoSWE | Claw-SWE-Bench |
|---|---|---|---|
| 它是什么 | 单独评测仓库探索阶段的基准 | 整仓生成的数据集加微调配方 | 评测 coding-agent harness 的基准 |
| 规模 | 848 个 issue、203 个仓库、10 种语言;仓库平均 759 个文件、约 18 万行非测试代码 | 4818 个自动构建的实例,约为此前 NL2Repo 数据集(104 个)的 46 倍 | 350 个 issue 解决实例、8 种语言、43 个仓库;另有 80 个实例的 Lite 子集 |
| 头条数字 | 智能体探索 HitFile 约 0.65 对 BM25 的 0.079,但行级召回卡在 0.15-0.20 | Qwen3-30B-A3B-Instruct 微调后在 BeyondSWE-Doc2Repo 上通过率从 0.058 升到 0.472 | 同样的 GLM 5.1 骨干,OpenClaw 换 adapter 后 Pass@1 从 19.1% 到 73.4% |
| 第二关键数字 | 上下文效率与下游修复成功率的相关性 Pearson r = +0.950 | 35B-A3B 变体从 0.438 到 0.500,说明 8 倍提升的大头来自救弱底座 | 模型固定时 harness 选择让 Pass@1 摆动 27.4 分,换模型摆 29.4 分 |
| 它排除了什么 | 经典检索:BM25 的 HitFile 只有 0.079、行级召回 0.021 | 「微调就能到前沿」:GPT-5.4(CodeX) 仍有 0.617,高于微调后的 0.472 | 「adapter 只是水管」:future-commit 清理让 Claude Opus 4.7 从 84.7% 掉到 76.7% |
这张表更值得读的是它没有的东西:没有任何一个数字来自同一任务。SWE-Explore 评的是探索质量,DeNovoSWE 评的是从文档重建整仓,Claw-SWE-Bench 评的是修 issue。跨列排名没有意义。三列真正共享的是一种方法:能固定的全固定,只动一个环节,诚实测量增量,包括那些难看的增量。
每篇论文真正证明了什么
SWE-Explore 证明检索解决了,定位没有。 在它 848 个 issue 的基准上,现代智能体式探索的 HitFile 约 0.65,而 BM25 只有 0.079、TF-IDF 0.140,「把仓库嵌入一下就检索」的时代在这个任务上算是彻底结束了。但同一批智能体只能召回 0.15-0.20 的相关行,而论文最有力的论点是:卡住修复的是这个缺口,不是找文件。上下文效率与下游修复成功率的相关性 Pearson r = +0.950,首个有效命中 +0.928,HitFile +0.925,nDCG@500 +0.921。专门吃代码图结构的搜索已经摸到了天花板:CoSIL 的迭代代码图搜索行级召回 0.788,对通用智能体的 0.15-0.19 是 4 倍差距。论文自己的总结很诚实:换 LLM「改变工作点,不改变瓶颈」。
DeNovoSWE 证明缺失的能力是可以训出来的。 它的出发点是:大多数 SWE 训练数据教的是错的任务:SWE-bench 式 issue 把一个能跑的仓库递给模型让它打补丁,而 DeNovoSWE 要求从能力文档重建整个仓库,用项目自己的可执行测试打分。数据集把这个任务扩到 4818 个实例,约为 104 个实例的 NL2Repo 前作的 46 倍;用它微调 Qwen3-30B-A3B-Instruct,BeyondSWE-Doc2Repo 通过率从 0.058 升到 0.472,相对提升 8 倍。论文自己把丑话也说在前面:35B-A3B 变体起点就是 0.438、涨得少,所以头条提升的大头是救弱底座;打分是单元测试通过比例的平均,0.472 不意味着 47% 的仓库能端到端跑通;前沿闭源模型仍然领先,GPT-5.4(CodeX) 0.617、GLM-5 0.568、DeepSeek-V4-Pro 0.566。
Claw-SWE-Bench 证明 harness 是一等自变量。 它的 350 个实例固定模型、只动 OpenClaw 的 harness。头条对比很直白:极简 direct-diff adapter 下 GLM 5.1 的 Pass@1 是 19.1%,换完整 adapter,同一个骨干 73.4%。横扫下来,换模型让 Pass@1 摆 29.4 分,固定模型换 harness 摆 27.4 分,也就是说脚手架的方差几乎和模型本身一样大。论文还把评测卫生量化了:future-commit 清理让 Claude Opus 4.7 从 84.7% 掉到 76.7%;Lite-80 子集一次完整跑只要全量 350 的约 22.9% 成本,校准中平均分只差 0.4 分(全量 0.639 对 Lite 0.643)。
三篇拼在一起怎么用
作为一个整体来看,这三篇论文给了一个诊断顺序。智能体在仓库任务上失败时,最便宜的解释先查探索:SWE-Explore 的数字说找文件基本解决了,如果你的智能体连该改哪些文件都说不对,那它是落后了一条已经被跨过去的边界。更常见的失败是找得到文件、说不出具体哪些行,这是定位问题,靠打磨提示词稳定解决不了。如果定位健康、长程任务还是完不成,DeNovoSWE 的结果说这个能力缺口可以用可验证的整仓数据训出来,不过它的消融也警告:最大的收益归弱底座。而如果换模型或重构提示词时分数莫名漂移,Claw-SWE-Bench 那 27.4 分的 harness 增量告诉你:先把 harness 冻结测准,再记模型的功。
怎么选
- 排查智能体在你的仓库上为什么失败。 先用 SWE-Explore 的指标族:HitFile、行级召回、上下文效率、首个有效命中。它的核心发现是这些探索指标与修复成功率的相关性都在 0.92 以上,是你能插桩的最便宜的先行指标。
- 为长程任务训练或微调智能体。 DeNovoSWE 就是模板:生成可验证任务,打分来自原仓库自己的测试,难例上保留部分成功的轨迹,并预期最大的提升落在弱底座上。和前沿模型的差距自己验证,论文自己的数字说差距还在。
- 选型或维护 agent harness。 Claw-SWE-Bench 的数字说 adapter 和 harness 设计可能比你想买的那个模型升级更值钱。把每次 harness 变更当作有 Pass@1 增量可测的实验,迭代用 Lite-80 子集,发任何数字之前先做 future-commit 清理。
- 发基准结果。 三篇论文示范的是同一套纪律:报指标的确切定义,披露清理流程,说清这个数字不能证明什么。Claw-SWE-Bench 的 future-commit 检查和 DeNovoSWE 的按测试部分给分,都在提醒头条分数是很容易意外注水的。
局限与存疑
最明显的局限是三篇论文没有在同一任务上评同一个智能体,所以本页给不出「谁最好」。每篇都把一个 narrower 的问题答得很好:SWE-Explore 告诉你定位在哪一步失败,DeNovoSWE 告诉你整仓生成可训,Claw-SWE-Bench 告诉你 harness 和模型一样要紧。
更深的存疑连接第一篇和第三篇。SWE-Explore 显示专门吃代码图的搜索在线级召回上赢通用智能体 4 倍,Claw-SWE-Bench 显示 harness 设计能让分数摆动几十分。两者都指向「当前瓶颈在智能体架构而非模型规模」,但都没有做出组合系统:一个带 CoSIL 式结构搜索的探索器,裹在工程扎实的 harness 里,再用 DeNovoSWE 式数据训过。谁跑了那个实验,谁就产出了下一个要被打败的数字。
第三个存疑是成本。DeNovoSWE 没有报告数据生成管线和长程 rollout 的 token、耗时或美元成本,Claw-SWE-Bench 则报告分数相近的系统 API 成本可以差很多。对生产决策来说,「每一分花的钱」这一列在三篇论文里基本都还是空的。
常见问题
三篇里我该用哪篇评我的代码智能体?
按你要抓的失败来配基准。怀疑智能体看错了代码,用 SWE-Explore;在比较 harness 或 adapter,用 Claw-SWE-Bench;问的是训练有没有用,那属于 DeNovoSWE 的 BeyondSWE-Doc2Repo 场景。它们测的是不同环节,不能互换。
SWE-Explore 为什么说检索「解决了」,行级召回却只有 0.15-0.20?
因为两个指标测的不是一回事。经典意义的检索是给相关文件排序:BM25 的 HitFile 只有 0.079 说明老路已死,智能体式探索能到 0.65 左右。行级召回是定位,在这些文件里找回具体那几行,通用智能体卡在 0.15-0.20。论文的论点是第二个缺口、而不是第一个,卡住了修复。
DeNovoSWE 微调出的模型能在整仓生成上打过前沿闭源模型吗?
按论文自己的表,不能。微调后的 Qwen3-30B-A3B 在 BeyondSWE-Doc2Repo 上是 0.472,而 GPT-5.4(CodeX) 0.617、GLM-5 0.568、DeepSeek-V4-Pro 0.566。这套训练真正做到的是在小得多的规模上把差距追平大半,并超过此前的智能体基线 Scale-SWE-Agent 的 0.292。
Claw-SWE-Bench 从 19.1% 到 73.4% 的提升里有多少是模型的功劳?
零。两个数字用的是同一个 GLM 5.1 骨干,只有 OpenClaw 的 adapter 不同。论文横扫下来,固定模型换 harness 让 Pass@1 摆 27.4 分,换模型摆 29.4 分,harness 作为方差来源和模型差不多大。
迭代 harness 变更最省钱的方式是什么?
Claw-SWE-Bench 的 Lite-80 子集就是为这个设计的:一次完整跑约为 350 全量的 22.9% 成本,校准中平均分只差约 0.4 分(全量 0.639 对 Lite 0.643)。用它做筛选和回归检查,小差异要当真之前先上全量基准确认。
探索分数更高就一定修得更好吗?
是强相关,不是保证。SWE-Explore 报告上下文效率与下游修复成功率 Pearson r = +0.950,另外三个指标也都在 0.92 以上。这使探索质量成为目前最好的先行指标,但对单个任务相关不等于保证,行级召回的天花板仍然压着上限。