
稀疏自编码器原理解读:把叠加的神经元拆成可读的特征
语言模型的一个神经元可能同时对法语、DNA 和 HTTP 放电。稀疏自编码器把这种叠加拆回单一语义的特征,GemmaScope 又用 400+ 个开放 SAE 覆盖 Gemma 2 全部层。
工作原理
语言模型内部的基本计算单元并不是神经元。单个神经元往往同时对应多个互不相关的概念,典型例子是某个神经元对法语文本、DNA 序列和 HTTP 请求都会放电。目前最主流的解释是叠加(superposition):一个只有 d 个神经元的模型想要表达远多于 d 个的特征,于是把这些特征打包进相互重叠、不正交的方向里,容忍一点干扰。如果这是真的,那么逐个读神经元就是错误的做法;真正的基本单元是稀疏的、生活在过完备基底上的特征(方向数比神经元还多)。
Anthropic 的稀疏自编码器论文(「迈向单语义性」)是这套押注可行性的精悍证明。SAE 的结构刻意简单:一个比模型宽度更宽的单隐层网络,训练目标只有一个:重建激活向量,同时用 L1 惩罚把隐层代码压成大部分为零。解码器的各列构成一本学出来的特征方向字典。因为对每个 token 来说几乎所有分量都是零,每个存活的分量被迫承载一个具体、可复用的含义,比如「撇号语境」特征、「右括号」特征,用几个字就能命名。没有任何人事先给特征打标签;可解释的结构是被「发现」的,不是被「强加」的。这是经典的字典学习,只是对象从图像 patch 换成了 Transformer 的激活。
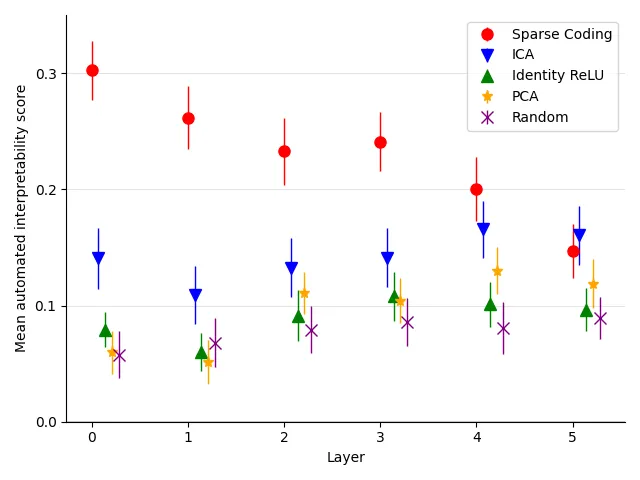
论文的证据有两条腿。第一,在盲评人类评分和自动化 GPT 评分两种口径下,SAE 特征的可解释性评分都高于模型自身的神经元、PCA/ICA 分量和残差流原始基底。第二,特征是因果的而不只是相关的:在间接宾语识别(IOI)任务上,作者把造成反事实行为的具体特征定位出来,粒度比此前任何分解都细,并且编辑这些特征能让输出按预测方向变化。
GemmaScope 展示的是同一份配方被工业界实验室规模化之后的样子。DeepMind 在 Gemma 2 2B 和 9B 的每一层、每个子层(外加 27B 的部分层)上训练了 400 多个 JumpReLU SAE:每个 Transformer block 有三个位置(注意力头输出、MLP 输出、MLP 之后的残差流),覆盖 2B 的全部 26 层和 9B 的全部 42 层。字典宽度从 2^14(约 1.6 万)到 2^20(约 100 万)个隐单元不等,每个 SAE 用 40 亿到 160 亿 token 训练。这套发布物包含 2000 多个检查点、3000 多万个特征,权重放在 Hugging Face 上,还配有 Neuronpedia 的特征浏览器。之所以做成开放套件,是因为训练它本身就是一堵成本墙:DeepMind 花了超过 GPT-3 训练算力的 20%,往磁盘上写了大约 20 PiB 的激活才把它做出来。
GemmaScope 里有两个设计选择值得专门理解,因为分歧恰恰在这里。激活函数 JumpReLU:每个特征有一个可学习的阈值,前激活值越过自己的门槛才放电,于是每个 token 的活跃特征数是可变的,这和 TopK 不同,TopK 强制每个 token 恰好有 k 个活跃特征。DeepMind 报告 JumpReLU 在「重建-稀疏」前沿上比 Gated 和 TopK 略优,同时也诚实地注明:在人类评分的可解释性上,三个家族几乎分不出高下,赢的是保真度指标,不是可读性。字典没有唯一正确的尺寸:从 2^14 加宽到 2^19 能在固定稀疏度下稳定降低 delta loss(把 SAE 拼回模型后多出来的交叉熵),但收益递减,而且无法保证多出来的容量学到的是真正的新特征,而不是旧特征的重新组合。
关键数字
两篇论文回答的是不同问题(一篇证明方法成立,一篇标定方法的成本),所以它们的数字不是同口径的基准对比,请把这张表当作演进脉络,而不是排行榜。
| 里程碑 | 探查的模型 | 分解对象 | 字典宽度 | 关键数字 | 来源 |
|---|---|---|---|---|---|
| Anthropic SAE(2023) | 小型 Transformer | 残差流激活 | 过完备,宽于模型宽度(具体尺寸不是重点) | 自动可解释性评分超过神经元、PCA/ICA 与残差基底;IOI 电路被因果定位,粒度细于此前工作 | 论文页 |
| GemmaScope(2024) | Gemma 2 2B 与 9B,27B 部分层 | 每个 block 3 个位置 × 2B 的 26 层 / 9B 的 42 层 | 2^14 到 2^20,即约 1.6 万到 100 万隐单元 | 400+ SAE、2000+ 检查点、3000 万+ 特征、每个 SAE 训练 4B–16B token、超过 GPT-3 算力的 20%、约 20 PiB 激活 | 论文页 |
两者不具可比性:Anthropic 的数字是定性评分结果,GemmaScope 的数字是覆盖范围与训练成本,二者没有共享的度量或测试环境。
在 GemmaScope 自己的结果里,有三条实测规律比任何单一数字都重要:
- 位置比宽度更关键。 残差流 SAE 的 delta loss 始终最高(那里的小重建误差对下游预测伤害最大),而注意力和 MLP 位置更容易拟合。
- 基座模型迁移到对话模型。 只在基座 Gemma 2 9B 上训练的 SAE,重建指令微调版 9B 的激活几乎和在 IT 模型上直接训练的 SAE 一样好,也就是说不必为每个模型变体各训一套。
- 英语偏科会露馅。 delta loss 在数学数据上最低、在多语数据(Europarl)上最高,正好镜像预训练语料的构成。
局限与存疑
鼓舞人心的版本和诚实的版本不是同一个故事。可解释性是被「测量」的,不是被「保证」的:「比神经元更可解释」是个低门槛,无论人类还是自动评分,仍有大量特征说不清含义。L1 稀疏惩罚会带来死特征和重复特征,字典宽度和惩罚权重的选择至今仍有相当的艺术成分,后续工作大把精力都花在这两个失败模式上。重建是有损的,所以 SAE 是观察模型的一面镜片,不是模型的忠实转写,它丢掉的东西,你的分析根本看不见。GemmaScope 自己的坦率提醒是:业界至今没有公认指标来判定一个 SAE「好不好」,delta loss 和「未解释方差占比」度量的是重建,不是可解释性,而且两者可能背离。特征分裂问题没有解决:更宽的字典有时学到真正的新特征,有时只是把旧特征重新组合,目前没有干净的办法区分这两种情况。此外,SAE 会系统性地漏掉那些只在更宽字典里才出现的特征,所以没有任何单个 SAE 能提供完整图景。给实践者的稳妥建议是:把论文报告的数字当作「在其设定下的证据」,按预算选位置和宽度,并对你打算实际操控的那几个特征单独做验证。
常见问题
稀疏自编码器(SAE)是什么,如何分解大模型的叠加?
稀疏自编码器是一个单隐层网络,训练目标是重建语言模型的内部激活,同时用 L1 惩罚把隐层代码压成大部分为零。它的解码器各列构成一本特征方向字典,每个方向往往只对单一、可命名的概念放电,把神经元「多义词」式的叠加拆成了可读的单元。
稀疏自编码器用了什么方法,能在神经元失败的地方找到可读特征?
神经元是多义词的,因为模型把比神经元数量更多的特征塞进了相互重叠的方向。SAE 的隐层刻意做成过完备(比模型维度更宽),加上稀疏惩罚,每个 token 只有少数分量被激活,于是每个被激活的分量只能承载一个具体含义。可解释性来自「重建 + 稀疏」这个目标本身,不需要人工标注。
GemmaScope 是什么,覆盖了多少特征?
GemmaScope 是 DeepMind 开放的稀疏自编码器套件,在 Gemma 2 2B、9B 的每一层和子层(以及 27B 的部分层)上训练了 400 多个 JumpReLU SAE,以 2000 多个检查点的形式发布,覆盖 3000 多万个学出的特征。训练它消耗了超过 GPT-3 算力的 20%、约 20 PiB 的激活存储,权重在 Hugging Face 上免费下载。
JumpReLU 和 TopK 稀疏自编码器有什么区别?
TopK 强制每个 token 恰好有 k 个特征活跃,而 JumpReLU 给每个特征各自可学习的阈值,活跃数量随 token 变化。在 GemmaScope 的测量里,JumpReLU 在重建-稀疏前沿上比 Gated 和 TopK 略占优势,但人类评分的可解释性上三者几乎无差别。
稀疏自编码器和直接读神经元,两种方法哪个更靠谱?
就这两篇论文的证据而言,在寻找单一语义单元这件事上是成立的:SAE 特征在盲评人类评分和自动评分下都高于神经元、PCA/ICA 分量和残差基底,且至少有一个电路(间接宾语识别)被以更细的粒度做了因果定位。但 SAE 是一面有损的镜片——重建误差意味着它是模型的一个视角,而不是模型的完整转写。