AnchorWorld 和 ABot-Earth 的区别:一个管交互、一个管尺度
两篇论文都在生成世界,但方向几乎不相交:AnchorWorld 让第一人称视频跟着全身动作走,ABot-Earth 0.5 把卫星图变成能在网页地图里漫游的行星尺度三维高斯场景。
AnchorWorld和ABot-Earth 0.5回答的是同一个大问题:「模型能不能生成一个世界?」但两份答案几乎不重叠。AnchorWorld 追求交互完整性:你戴着相机,全身动,周围的世界必须正确响应、几何上保持一致。ABot-Earth 0.5 追求尺度与可得性:给它普通卫星影像,它产出一个无缝、可漫游、能在浏览器里流式加载的三维地球。一篇论文检验的是「世界经不经得起一个活动的人」,另一篇检验的是「世界经不经得起整颗行星」。
这个对比之所以值得写,是因为两篇论文瞄准同一个买家:具身智能。机器人和无人机需要便宜、可控的环境来做训练与评测,而两篇论文从相反的方向砍成本。AnchorWorld 试图让一个又小又闭环的第一人称世界可信到能依赖;ABot-Earth 试图让一个又大又开放的世界便宜到能在地球任意角落部署。
两种相反的设计
AnchorWorld以三维人体动作和初始第一人称画面为条件,生成第一人称视频。它的核心难点是:第一人称相机看得见手和手臂,却看不见自己的全身,模型必须推断身体其余部分在场景里的位置。作者的解法是引入与智能体自身感官解耦的外部视角辅助监督,让模型即使在被第一人称画面截断时,也学得会全身与环境的空间关系。第二个机制是世界定制:在世界坐标系里定义锚点视角(anchor view),配上文字描述来规定局部场景如何随时间演化。模型分四个渐进阶段训练(第三人称动作、第一人称动作、静态场景、动态场景),各阶段训练数据分别为 200K+101K、100K、25K、25K+10K 条片段。
ABot-Earth 0.5是直接建立在三维高斯泼溅(3D Gaussian Splatting)表示上的生成式三维框架。它在真实城市重建上训练,重建由作者自研的 ABot-3DGS 管线完成,数据源是八个开源数据集,其中包括 UrbanScene3D(12.8 万图、55 平方公里)和 UrbanBIS(11.3 万图、10.78 平方公里)。推理时只需卫星影像,按 200 米乘 200 米的训练瓦片逐块生成新三维场景,并带层次化细节(LOD)结构:近景加载 zoom 17 到 19 的高精度瓦片,远景加载 zoom 14 到 15 的粗瓦片,通过 OGC 3D Tiles 规范导出,标准网页地图引擎即可渲染。作者报告已产出约 312,500 块生产瓦片,覆盖 190 多个国家的 300 多座城市。
这条光谱上还有第三个坐标:OmniDreams,一个闭环驾驶世界模型。它介于两者之间:像 AnchorWorld 一样交互,但为实时车辆仿真而设计,而不是人体具身控制。
关键数字
两篇论文从不在同一基准上评测,所以下表每一行都是不同的尺子:各论文自己的表内是同口径,跨论文之间不可直接比较。
| 维度 | AnchorWorld | ABot-Earth 0.5 | 同口径? |
|---|---|---|---|
| 输出形态 | 跟随三维人体动作的第一人称视频 | 由卫星影像生成的静态三维高斯地球 | 不可直接比较 |
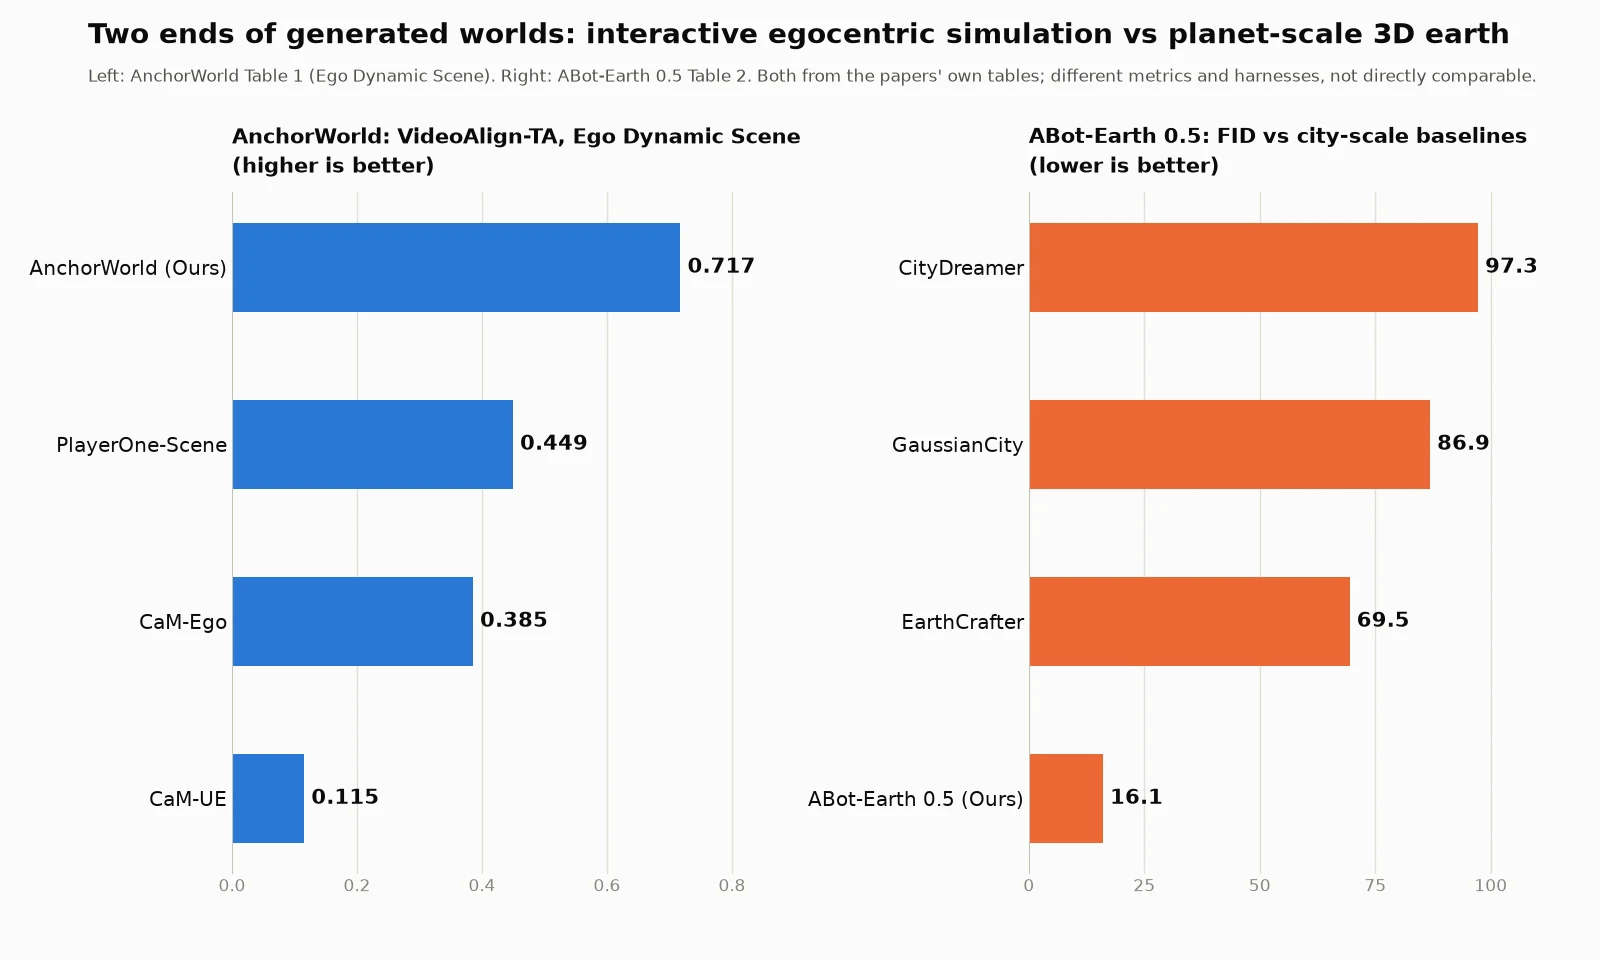
| 招牌指标 | 动态自我场景 VideoAlign-TA 0.717(表 1) | FID 16.1(表 2) | 指标不同,不可比 |
| 同表最强基线 | PlayerOne-Scene 0.449 VideoAlign-TA | EarthCrafter 69.5 FID | 各自只与自己的基线比 |
| 动态场景保真 | PSNR 16.37 / SSIM 0.555 / LPIPS 0.486,对 CaM-Ego 14.57 / 0.501 / 0.574 | 无对应视频指标 | 仅 AnchorWorld 内部口径 |
| 训练成本 | 四阶段共约 1,406 GPU 小时,16 张 80G 显卡(表 3) | 千卡集群单瓦片推理约 25 分钟 | 单位不同,不可比 |
| 服务规模 | 未报告 | 312,500 块瓦片、300 多城、190 多国、每平方公里十分钟内 | 仅 ABot-Earth |
| 定制能力 | 锚点视角加文字演化提示;锚点从 1 个增至 3 个,场景一致性 Mat. Pix. 4,074.94 升至 4,233.59(表 5) | 无;生成只以卫星影像为条件 | 不可直接比较 |
这张表有三处读法值得强调。第一,AnchorWorld 在动态自我场景上 VideoAlign-TA 0.717 领先同表所有基线,且优势不是单一指标的偶然:PSNR、SSIM、LPIPS 与轨迹误差(ATE 0.048 对基线 0.067 到 0.083)同向变动。第二,ABot-Earth 的 FID 16.1 远低于城市级生成基线,但论文自己的表注就写明:基线的 FID 与 KID 用了不同的真值集、不同的位姿与视角计算,差距存在夸大成分。第三,两行成本用的是完全不同的单位(每阶段训练 GPU 小时 对 生产集群每瓦片分钟),任何「谁更便宜」的结论都只能是编造,本页不做这个结论。
怎么选
选 AnchorWorld的场景:瓶颈是小空间里的交互保真。如果你在训练或评测一个必须理解「世界如何响应自己身体」的具身智能体,你需要的正是这篇论文优化的东西:全身动作控制、视野外一致性,以及一套用锚点视角加文字来规定场景演化的机制。定制方案是它的差异点,因为它让你用脚本写世界状态变化,而不必重新采集数据。
选 ABot-Earth 0.5的场景:瓶颈是覆盖。如果你需要可导航的三维环境来做无人机航线、数字孪生原型或地理尺度的仿真沙盒,一套每平方公里十分钟内、只靠免费卫星影像的生成系统,把重建瓶颈整个拆掉了。开放性同样关键:Google Earth 只通过 API 提供稀疏扫描的重建结果,ABot-Earth 把自己定位成开放生成平台,覆盖在原理上是无限的。
今天不要二选一错配:AnchorWorld 生成不了可漫游的平方公里,ABot-Earth 也不会在人体动作上闭环。把 ABot-Earth 式的大地形生成接到 AnchorWorld 式第一人称交互上,是显而易见的研究空白,两篇论文都没有宣称做到。
局限与存疑
AnchorWorld 侧:评测是内部口径,所有基线数字都来自作者自己的表、自己的场景划分;论文没有报告闭环下游任务(在仿真里训练或评测的智能体迁移到真实世界)的结果。训练成本约 1,406 GPU 小时(16 张 80G 显卡、四阶段),对一套输出是视频而非持久三维资产的系统来说不算便宜。锚点视角定制的场景演化主要以定性方式展示,定量表测的是静态与动作保真,没有测「被规定的演化本身在长时程上是否忠实」。
ABot-Earth 0.5 侧:招牌 FID 对比带着作者自己的表注(真值集与视角不同),16.1 对 69.5 的差距应视为线索而非结论。具身智能的下游主张(闭环无人机导航、避障、控制)由仿真到现实的动机与定性地标融合来支撑,但正文没有报告任何导航成功率基准。版本号叫 0.5 是有原因的:300 多城听起来是行星尺度,但作者注明性能主要在都会区与部分非城市地形上验证,几何质量取决于输入卫星影像与上游 ABot-3DGS 重建的质量。
跨论文的诚实声明:上表左列与右列的任何数字回答的都是不同问题。AnchorWorld 的指标问「世界对人的响应是否正确」,ABot-Earth 的指标问「生成的地球像不像真的」。给两篇论文排名没有意义,本页刻意不做。
常见问题
AnchorWorld 是怎么控制世界的?
AnchorWorld 以三维人体动作加初始第一人称画面为条件生成视频;定制世界时,用户在世界坐标系里定义锚点视角,配上文字描述规定局部场景如何演化,无需为每个场景重新训练。
ABot-Earth 0.5 生成一平方公里要多久?
论文报告的可扩展生成速率是每平方公里十分钟以内,输入只需卫星影像;千卡集群上单瓦片推理约 25 分钟。已部署系统约 312,500 块瓦片,覆盖 190 多个国家的 300 多座城市。
AnchorWorld 和 ABot-Earth 的数字能直接对比吗?
不能。AnchorWorld 的 VideoAlign-TA、PSNR、SSIM、LPIPS 测的是其自有场景切分上的动态第一人称保真;ABot-Earth 的 FID 与 KID 测的是生成三维地球瓦片的图像真实感,且论文自己就注明了真值集的保留条件。指标、数据集、测试台架完全不同。
做具身智能评测,哪一篇帮助更大?
二者对应不同的失效模式。AnchorWorld 提供可交互的第一人称世界,用来测智能体在动态场景与自身具身上的表现;ABot-Earth 提供地理尺度的静态环境,面向无人机航线仿真这类导航任务。两篇论文都没有为自己的一侧报告完整的闭环迁移基准。