
VLM3 vs ZipSplat vs Function2Scene 3D 对比
VLM3 用 4B 视觉语言模型直接读出几何,ZipSplat 用少 6-33 倍高斯球重建可渲染场景,Function2Scene 把文字需求变成室内布局。
真正该问的问题
「哪个 3D 模型最强」是个错误的问题,因为这几套系统做的是不同的工作,只是输入恰好都是普通 2D 素材。VLM3 回答关于几何的问题:那个点有多远、相机在哪里、两个像素是不是同一个点。ZipSplat 产出几何本身:一个可以从新视角渲染的 3D 高斯场景。Function2Scene 产出布局:由「人要在房间里做什么」驱动,而不是由「物体长什么样」驱动的室内排布。还有 DIRECT,它把物体带着明确的 3D 姿态编辑进现有照片,这是扩散 inpainting 从来没有给过的控制维度。先定任务,再选模型,下面的表就是按这个逻辑组织的。
关键数字
| 你手上有什么 | 你想要什么 | 模型 | 论文报告的核心数字 | 在哪里会失效 |
|---|---|---|---|---|
| 一张或几张照片 | 深度、相机位姿、像素对应、物体 3D 尺寸,以答案形式返回 | VLM3(4B 视觉语言模型) | 8 个数据集平均 0.904 δ₁ 深度精度;ETH3D+ScanNet++ 上 94.0% AUC@30° 相机位姿;物体级 3D 定性 91.35%、定量 58.51%;对应任务 15.37 px EPE | 密集对应仍输给专用匹配器 UFM 的 7.89 EPE(约一半误差);[0, 2000) 文本坐标限制了空间精度上限 |
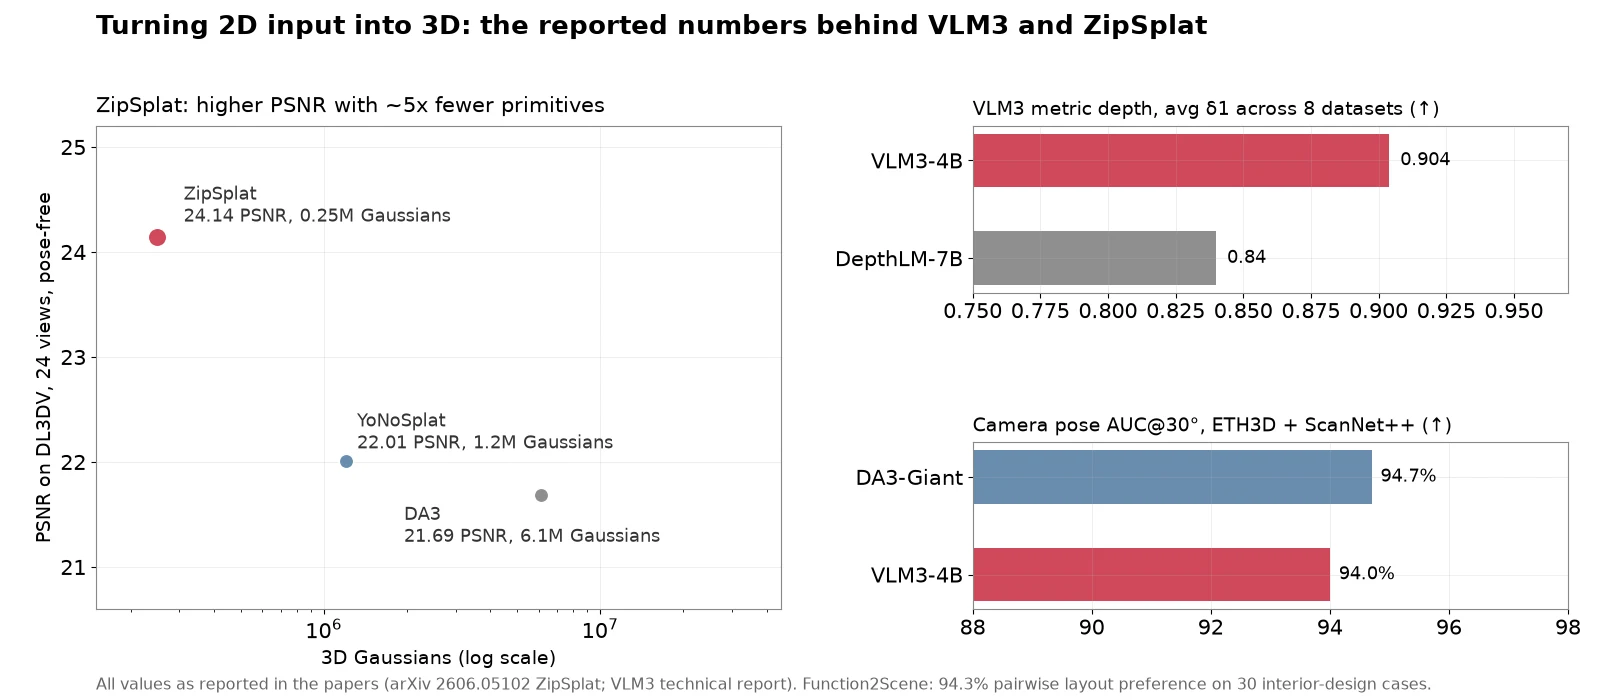
| 几张没有位姿的照片 | 一个可渲染的 3D 场景 | ZipSplat(前馈高斯泼溅) | DL3DV 24 视角免位姿 24.14 PSNR、仅 249K 高斯球,对比 YoNoSplat 22.01(1.2M)、DA3 21.69(6.1M);RealEstate10K 6 视角 26.20 PSNR、62K 高斯球;192 视角渲染 401 FPS | 稀疏视角下 LPIPS 落后于逐像素方法(纹理锐度);k-means 分配会饿着平坦区域;运动物体上退化 |
| 一段文字设计需求(谁用、做什么) | 支撑这些活动的 3D 室内布局 | Function2Scene(LLM+VLM 检查修复循环) | 30 个专业室内设计案例上,94.3% 的双盲对比偏好胜过 LLM 场景合成基线;功能设计准则 taxonomy 共 17 条 | 是 30 个内部案例上的人类偏好、不是公开基准;摘要未点名基线;衡量的是布局合理性而非照片级真实感 |
| 一张照片加一个参考物体、指定姿态 | 把物体按选定姿态合成进场景 | DIRECT(分解式注入 + 视觉代理) | 摘要声称几何可控性和视觉质量都优于此前插入方法;没有可引用的公开指标数值 | 无数字可核对;输出是 2D 合成图,不是全场景 3D |
第三列要当成四种不同的产品看,而不是同一个岗位的四个候选人。四行数字来自四套完全不同的协议,彼此不能直接比;表格第四列标出各自的边界,而不是假装它们可比。
VLM3:不用 3D 结构的 3D 理解
VLM3 的主张是四篇里最激进的:一个标准的 4B 视觉语言模型,不加代价体头、不加深度解码器、不加几何损失,就能在多数 3D 理解任务上追平专家模型。关键不在架构而在预处理。焦距统一把每张图重采样到等效焦距 1000 像素,消除了混合相机数据带来的矛盾监督;文本像素引用用 [0, 2000) 区间的整数坐标给像素命名,代替叠加视觉标记,于是对应和位姿任务都变成了普通文本生成。作者还说,有了这两处修复之后,数据混合加权「几乎」成了训练里最重要的事。
报告的结果在四项任务中的三项上撑住了强版本的主张。深度:8 个数据集平均 0.904 δ₁,追平 UnidepthV2 和 MoGe-2,还把 DepthLM-7B 的 0.84 提到 0.90,参数反而更少。相机位姿:ETH3D 和 ScanNet++ 上 94.0% AUC@30°,与 DA3-Giant 的 94.7% 统计上打平,并超过 VGGT。物体级 3D:定性 91.35%、定量 58.51%,两项都超过 SpatialRGPT-8B。诚实的例外是密集对应:15.37 EPE 虽胜过 DKM 和 RoMa,但误差约为专用匹配器 UFM(7.89)的两倍。如果你的任务是「看照片、答几何」,从 VLM3 入手;它自己的局限章节把专用模型仍然赢在哪里写得清清楚楚。
ZipSplat:高斯预算跟着场景走
ZipSplat 回答的是另一个问题:给几张场景照片,给我一个能渲染的东西。它的论点是逐像素前馈泼溅在浪费图元。每个输入像素一个高斯球,意味着白墙和枝叶繁茂的树拿到同样的预算,视角一多数量就爆炸。ZipSplat 用 k-means 把骨干网络的稠密 token 聚成少量场景 token,每个 token 解码成 32 个位置自由的三维高斯,平坦区域自然坍缩成少数 token、细节区域保留更多。压缩比是推理时的旋钮:一个训练好的模型靠调 r 就能覆盖整条质量数量曲线。
数字的强项恰恰建立在「少」上。DL3DV 24 视角免位姿,24.14 PSNR / 0.768 SSIM / 0.198 LPIPS,只用 249K 高斯球;对手 YoNoSplat 是 22.01(1.2M)、DA3 是 21.69(6.1M),每项指标都更好,图元只有约五分之一。在同一骨干上只换解码器,PSNR 高 1.5-2.7 dB、高斯球少 13-25 倍,说明增益来自解码器本身。RealEstate10K 只有 6 个视角时也拿到 26.20 PSNR(62K 高斯球),甚至小胜被允许用真值位姿的 DepthSplat(24.16)。代价在纹理上:稀疏视角下 LPIPS 落后逐像素方法,k-means 分配也可能饿着平面、宠着植被。注意它和 VLM3 的关系:ZipSplat 可以跑在 VGGT 或 DA3-G 骨干上,而这两类专家模型正是 VLM3 认为普通 VLM 可以替代的。两篇论文在「到底需要多少专用 3D 结构」上意见相左,而且各自都有数据支撑。
Function2Scene:由用途驱动的布局
Function2Scene 把输入彻底换掉了。你不给图,而是写一段功能需求,比如「一个有两孩的家庭周末一起做饭」,系统生成一个 3D 室内布局,评判标准是布局能在多大程度上支撑这些使用者。它把需求解析成使用者画像和活动,从 17 条功能设计准则(涵盖空间、人体工学、活动、环境四个维度)的 taxonomy 里推导约束,再通过「几何测量 + LLM 上下文推理 + VLM 视觉评估」的迭代检查修复循环生成,而不是让 LLM 一口气吐出最终场景。
报告的评测规模小但具体:在 30 个专业撰写的室内设计案例上,输出在 94.3% 的双盲对比中胜过近期基于 LLM 的场景合成基线。这个数字要看清成色:内部集合上的人类偏好、基线未点名。所以它的贡献应读作任务定义和检查修复架构,而不是榜单胜利。对需要「由使用方式而非外观驱动」的仿真、机器人或游戏团队,这是四者中唯一瞄准该任务的。
DIRECT:编辑这个特例
DIRECT 补全的是一个更窄的岗位:把参考物体以你可交互控制的 3D 姿态插入背景照片。此前的扩散式插入本质是 2D inpainting,对物体姿态没有显式控制。DIRECT 把注入条件拆成三部分:来自参考物体的外观引导、来自用户可调整 3D 代理的几何引导、来自背景上下文的引导,分通路注入避免特征纠缠,另配自动化数据构建管线。摘要只说在几何可控性和视觉质量上优于已有方法,没有给出任何指标数值,所以这里没有什么可引用的数字。把它放进对比,是因为它定义了这个岗位,而不是因为有证据它赢下了这个岗位。
怎么选
- 度量或查询已有照片里的几何(深度图、相机位姿、点对应、物体尺寸):选 VLM3。焦距统一让它不需要相机内参,4B 模型跑起来也便宜。密集匹配别用它,UFM 7.89 对 VLM3 15.37 的 EPE 是专用模型唯一明显赢的地方。
- 从几张照片重建可渲染场景、手头没有位姿:选 ZipSplat。免位姿是它的主打而非退路,喂真值位姿也只加约 0.1 dB。视角少时把压缩比调低,实用下限大约是 r = 0.5·sqrt(2/N),N 为视角数。
- 从文字需求生成室内布局:选 Function2Scene。94.3% 的偏好率来自 30 个内部案例,上线前用自己的户型验证,但功能准则的框架是「以使用者为中心」设计的正确起点。
- 把单个物体按选定姿态合成进照片:四者中只有 DIRECT 为此而造,但没有公开数字,采用前用自己的插入案例评测。
局限与存疑
四篇论文没有共享基准、任务或输出格式,两两之间不存在任何正面交手的数字;表格第四列就是诚实的替代。VLM3 的数字来自专家模型被调优过的基准,对应任务上的反例说明「无 3D 架构」的故事还不完整。ZipSplat 的对比混用了免位姿和需位姿基线,且对训练数据规模言之甚少,复现成本不明。Function2Scene 的评测是 30 个案例、基线未点名,是四者中证据基础最小的。DIRECT 则只贡献了任务定义,没有量化的结果。真正横跨四者的开放问题是:VLM3 认为通用 Transformer 只靠数据就能吸收 3D,ZipSplat 和 DIRECT 仍在上面盖专用几何结构。2027 年这个领域落在哪一边,将决定「3D 模型」是否还是一个独立品类。
常见问题
VLM3 比专家 3D 模型强吗?
在它报告的任务上,深度、相机位姿、物体级 3D 三项大体是:8 个数据集平均 0.904 δ₁、94.0% 位姿 AUC@30° 与 DA3-Giant 的 94.7% 统计打平、物体级 3D 定性 91.35%,全部出自一个 4B 通用 VLM。例外是密集像素对应:专用匹配器 UFM 的 7.89 EPE 对 VLM3 的 15.37,误差约为一半。
ZipSplat 需要相机位姿吗?
不需要。它在 DL3DV 和 RealEstate10K 上都免位姿重建渲染,喂真值位姿作为可选相机先验也只加约 0.1 dB。这正是 24.14 PSNR(24 视角、249K 高斯球)对 DA3 21.69(6.1M)成为头条对比的原因。
VLM3 和 ZipSplat 有什么区别?
从照片里产出的东西不同。VLM3 输出关于几何的答案(深度值、相机位姿、对应关系),以文本形式给出,不建任何场景表示;ZipSplat 输出一个真正可从新视角渲染的 3D 高斯场景。想查询照片,用 VLM3;想走进照片里,用 ZipSplat。
Function2Scene 的 94.3% 是基准测试结果吗?
不是公开基准意义上的。它是在 30 个专业撰写的室内设计案例上,人类评审在双盲对比中偏好 Function2Scene 布局的比率,基线是近期 LLM 场景合成方法但摘要未点名。读作「检查修复循环在该设定下胜过直接生成」可以,读作「排名已定」不行。
带 3D 控制的图像编辑该用哪个?
DIRECT。四者中只有它为「把参考物体按用户选定姿态合成进照片」而设计,靠外观、几何、上下文三路分开注入来实现。注意它的公开摘要没有给出任何指标数值,采用前请自行评测。