
R1 vs T1 vs WorldCraft:流式视频世界模型怎么选
Stream-R1 在训练时给蒸馏损失重新加权,Stream-T1 在推理时搜索,WorldCraft 加上拖拽操控:同一套流式视频栈的三种花钱方式,用论文数字讲清。
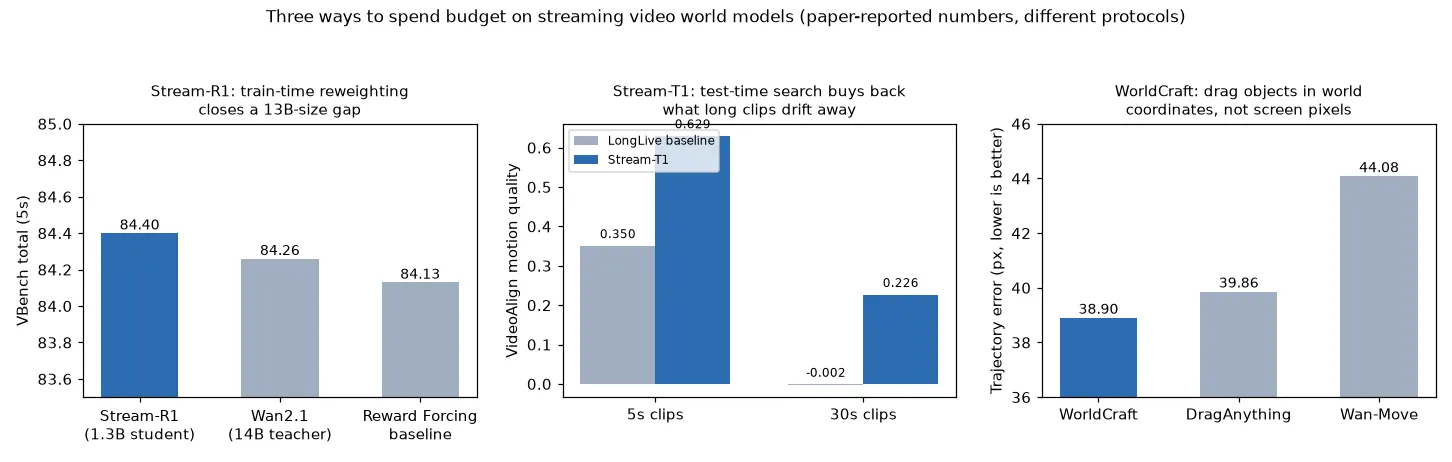
三篇论文,一台机器,三种花钱的地方
三篇论文出发点是同一类系统:自回归视频模型,靠着 KV cache 一块一块生成画面,快到能实时流式播放。这个设计换来实时生成和理论上无限的长度,也带来三个不同的问题,每篇论文拿不同的预算去解其中一个。
Stream-R1修的是训练信号。用分布匹配蒸馏(DMD)把多步教师蒸成几步学生时,梯度被浪费在已经没什么可教的 rollout 和像素区域上,于是 Stream-R1 按 rollout 可靠性和逐区域困惑度给损失重新加权。所有改动都在训练时发生,部署出去的模型原封不动。
Stream-T1假设的是相反的约束:模型冻结,只能在推理时多花算力。它给生成器套上一层块级搜索,内含三个部件:块间噪声传播、滑动十块窗口上的奖励剪枝、被挤出窗口的 KV cache 条目的记忆下沉。
WorldCraft攻的是另一条轴。镜头可控的视频世界模型能让你在场景里飞行,但碰不到里面的任何东西。WorldCraft 在冻结的镜头底座上加上了点选拖拽的物体操控,靠世界坐标轨迹和一个小适配器实现。
真正有用的问法从来不是「哪个最好」,而是「我手里到底有哪份预算」。
关键数字
每列只报各自论文测过的东西,协议互不相同,请按行读,别拿整张表排座次。
| 测了什么 | Stream-R1 | Stream-T1 | WorldCraft | 背景 |
|---|---|---|---|---|
| VBench 总分(5 秒片段) | 84.40 | 未报告 | 不适用 | 学生模型 1.3B;教师 Wan2.1-14B 为 84.26,Reward Forcing 基线 84.13 |
| VideoAlign 运动质量(5 秒) | 不适用 | 0.629 | 不适用 | 冻结基线 LongLive 为 0.350 |
| VideoAlign 运动质量(30 秒) | 不适用 | 0.226 | 不适用 | 基线崩到 -0.002,长片段正是漂移获胜的地方 |
| 推理速度 | 832x480 下 23.1 FPS | 搜索使每块算力成倍增加 | 不适用 | Stream-R1 的速度与普通 DMD 学生完全一致 |
| 训练成本 | 1000 步、8 张 A100、约 56 小时 | 无 | 27,027 条剪辑加一个约 50M 参数的 LoRA | WorldCraft 冻结镜头底座 |
| 轨迹误差(静态镜头,越低越好) | 不适用 | 不适用 | 38.90 px | DragAnything 39.86,Wan-Move 44.08 |
| 镜头 RPE 旋转 | 不适用 | 不适用 | 61 帧 0.131,253 帧 0.123 | 改用全量微调会劣化到 0.237 |
从表里能读出三件事。
第一,Stream-R1 的头条是尺寸倒挂:1.3B 的少步学生在 VBench 总分上拿到 84.40,压过自家 14B 多步教师的 84.26。优势很薄,论文自己在短片段上的证据也最弱。它更扎实的部分是收益能撑过 60 秒的生成(Qwen3-VL 评委打分:视觉质量 4.92、运动动态 4.04、文本对齐 4.11),以及在 50 条视频的人评里以 57.0% 的总体偏好率压过基线。只引用 84.40 对 84.26,等于挑了全文噪声最大的一格。
第二,Stream-T1 的数字恰好只在基线失手的地方大幅移动。5 秒片段上,它的 VBench 一致性指标几乎不动(运动平滑度 99.12 到 99.15,主体一致性 97.00 到 97.25),因为 LongLive 在这些项上本来就贴着天花板;真正跟着感知质量走的 VideoAlign 奖励指标,从 0.350 跳到 0.629。到了 30 秒,图景完全展开:基线运动质量趴在 -0.002,Stream-T1 拉到 0.226。读法是把 VBench 那几行当「没弄坏本来就能用的」,把 VideoAlign 那几行当真正的胜仗。
第三,WorldCraft 的数字初看平平(轨迹误差 38.90 对 DragAnything 的 39.86 算不上碾压),直到你注意到它保住了什么。加物体操控用的是约 50M 参数的 Spatial-Pathway LoRA,镜头 RPE 旋转维持在 0.131;而消融显示,为同样的能力做全量微调会把 RPE 劣化到 0.237。在 253 帧这种自回归滚出通常散架的长度上,它 0.0233 的综合 RPE 反而压过 WorldPlay 镜头基线。把核心想法单独拎出来的消融也值得引用:带迭代深度精炼的世界坐标轨迹在小旋转下轨迹误差 30.82,像素坐标变体是 35.82,这就是论文「控制必须活在世界坐标里,而不是屏幕上」的论据。
为什么不能拿这张表给三者排名
三篇论文测的是不同东西,用了不同台架,硬排就是制造假结论。Stream-R1 的 VBench 总分和 Stream-T1 的 VideoAlign 运动质量不是同一把尺上的两个读数:VBench 的一致性子项在强基线上就饱和在 97 到 99,VideoAlign 却还在动。WorldCraft 的轨迹误差是静态镜头下的控制精度指标,它的 RPE 数字来自纯镜头评测,证明的是镜头控制器活过了适配器,而不是说拖物体在视觉上零成本。三篇之间没有共同的底座、分辨率、提示集或评委。真正有信息量的对比在成本结构和失效模式上,这也是本篇剩下部分做的事。
怎么选
- 自己掌握蒸馏管线,能重训: Stream-R1 接近白捡的升级。两个信号都只是给已有 DMD 损失加权,不改架构、不加推理开销,配方也轻(8 张 A100 约 56 小时,1000 步)。代价是所有结果都只在 Wan2.1 这一对底座(1.3B 学生、14B 教师)一个分辨率上验证过。
- 模型冻结,或者训练不归你管: 三个里只有 Stream-T1 能选,这是它的构造决定的。它把生成器当黑盒,在块级搜索。账单开在推理侧:每块扩展并给多条候选续写打分,算力成倍增加,这和「实时流式」的目标天然有张力。部署有延迟余量或可以离线生成,这笔交易就划算;每一毫秒都有主,就不划算。
- 在造的是可交互的世界,不是片段生成器: WorldCraft。它贡献的是能力不是质量:点选拖拽的物体操控,且镜头在动时依然成立。因为它走 LoRA、底座冻结,理论上能叠在任一质量方法之上,不过本组论文没有一篇真的演示过这个组合。
- 要冻结模型出长片,且在意观感质量: 还是 Stream-T1,专门吃 30 秒这个区间,相对收益最大(运动质量从 -0.002 到 0.226)。注意 Stream-R1 的 60 秒证据来自它自己重训过的学生,回答的是另一个问题。
失效模式,提前标价
三篇论文都信一个学习出来的打分器,这是共同的隐性假设。Stream-R1 的 rollout 间可靠性加权会放大其预训练视频奖励模型自带的任何偏见;Stream-T1 的剪枝直接优化 VideoAlign,而对任何奖励指标用力过猛,都会漂向「评分器喜欢」而不是「看着对」;WorldCraft 继承其单目深度估计器的失效模式,而这恰恰是它的世界坐标重投影所依赖的部件,控制粒度是一个 latent token(约 16x16 像素),小物体无法被精确寻址。
每篇还有一个影响落地的范围限制。Stream-R1 只展示了一个底座对、一个分辨率,没有证据表明两级加权能迁到其他蒸馏配方。Stream-T1 只在单一基线(LongLive)两个基准上评测(946 条 VBench 提示、5 秒;128 条 MovieGen 提示、30 秒),好几个旋钮(噪声插值系数、动态奖励阈值、EMA 衰减)看起来都需要按模型调。WorldCraft 没有用户研究,所以「可控」落在轨迹误差和视觉指标上,而不是人能不能真的把它开到想要的位置;它的离屏持久化也只保你显式动过的物体。
局限与存疑
这组论文里没人做过的显眼实验是组合:用 Stream-R1 重加权训出的学生,套上 Stream-T1 的搜索,再叠 WorldCraft 的适配器。如果三份预算能相加,那个栈才是有趣的系统;如果互相打架(比如搜索放大重加权蒸馏带来的奖励劫持模式),这同样值得知道。第二个缺口是受控的质量对比:Stream-R1 和 Stream-T1 都声称提升流式质量,但数字对不齐,今天的采用者只能两个都跑一遍才知道哪个合身。第三,三篇都没有报按吞吐折算的质量,即服务时每 GPU 小时换来的东西,而这才是真实部署要按之做预算的数字。
常见问题
Stream-R1 和 Stream-T1 哪个更好?
两者解的是不同约束下的问题,数字不能直接比。Stream-R1 要重训(8 张 A100 约 56 小时、1000 步),换来推理零成本的收益,1.3B 学生 VBench 84.40 压过 14B 教师的 84.26;Stream-T1 不重训,但每生成一块都要多烧算力,把 5 秒片段的 VideoAlign 运动质量从 0.350 拉到 0.629。训练管线归你,Stream-R1 的收益留着更便宜;模型冻结,Stream-T1 是唯一的门。
Stream-T1 需要重训视频模型吗?
不需要。Stream-T1 按构造就是免训练的。它把流式生成器当冻结黑盒,推理时在块级施加三个手段:块间噪声传播、滑动十块窗口上的奖励剪枝、以及针对被挤出窗口(9 块窗口加 3 个注意力槽)的 KV cache 条目的记忆下沉。代价是额外的推理算力,而不是梯度步。
Stream-R1 的训练要花多少算力?
论文报告:Wan2.1-T2V-1.3B 学生、蒸馏自 14B 教师、832x480,1000 个优化器步、8 张 A100、有效 batch size 64,合计约 56 小时。推理不变,维持 23.1 FPS,因为可靠性信号和困惑度信号只改训练时的损失权重。
WorldCraft 能在镜头移动时拖动物体吗?
能,这正是它的核心主张。拖拽路径会从屏幕像素被抬进与镜头无关的世界坐标(用单目深度),再按每一帧当前的镜头位姿重投影回去,所以就算镜头在转,物体仍走你本意中的世界路径。消融给了量化证据:带迭代深度精炼的世界坐标轨迹在小旋转下轨迹误差 30.82,像素坐标变体是 35.82。
为什么三篇论文的基准数字不能互相比?
度量、台架、目标全都不同。Stream-R1 优化的是重训学生的短片段 VBench 总分;Stream-T1 报的是对冻结 LongLive 基线的 VideoAlign 奖励模型指标,它的 VBench 一致性行几乎不动,是因为那些项早已饱和在 97 到 99;WorldCraft 报的是像素轨迹误差和镜头 RPE,属于控制与跟踪指标,不是生成质量分。把这些数字排进同一列做出来的任何排名都是捏造的。
一句话:Stream-R1 花训练算力,Stream-T1 花推理算力,WorldCraft 花一个 50M 的适配器,选哪个取决于你手里是哪份预算。完整表格见Stream-R1 论文、Stream-T1 论文与WorldCraft 论文。