
MemDreamer vs TaskMem:视频智能体该学记什么,还是优化怎么查?
MemDreamer 用免训练的三层图记忆加 agentic 检索修读取端;TaskMem 用 RL 训练的记忆写入策略、再以 2,048 参数 adapter 适配部署任务,修写入端。
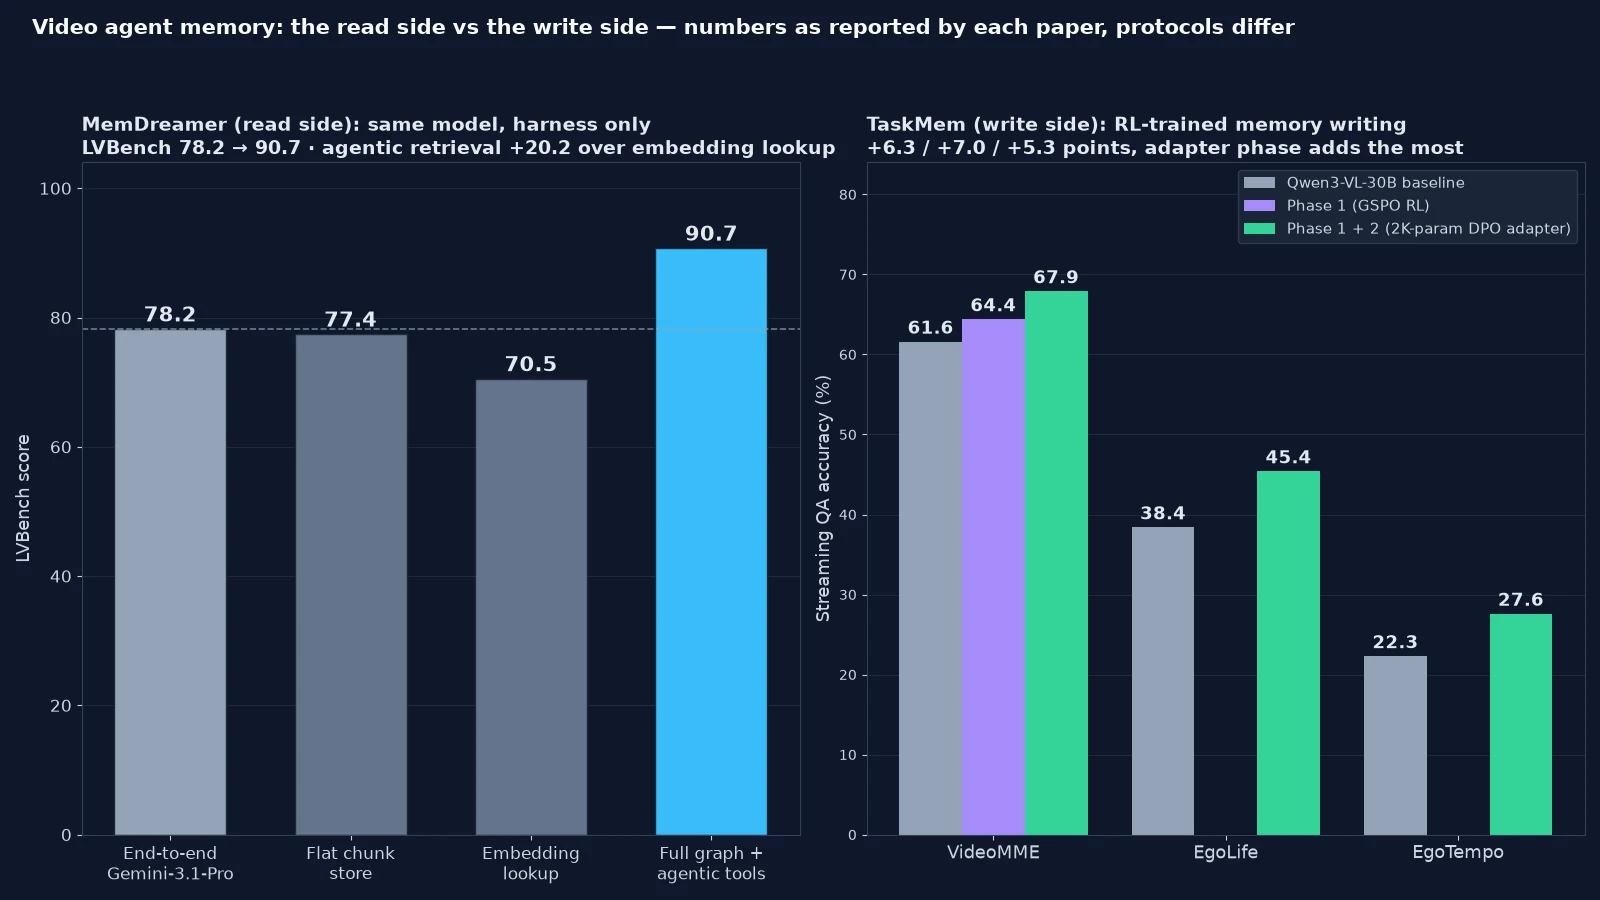
一个设计分歧:瓶颈在写入端还是读取端
两篇论文撞的是同一堵墙:两小时的视频按 1 FPS 采样超过 160 万 token,超出所有现有上下文窗口,耦合式 VLM 要么抽帧抽到答案失真,要么淹死在注意力稀释和「中间遗忘」里。两篇都拒绝重训基座模型,共识到此为止。之后它们把瓶颈放在了记忆管线的两端。
MemDreamer 把记忆当读取端问题:假设一个够强的感知模型离线把视频看一遍,写成一份紧凑的结构化记忆;真正的工程风险在于问答时推理模型能不能找到对的那条证据。它的答案是一个三层层级图(Video Root → Super Event → Macro Event,后者再展开出实体和微观事件子图),配七个检索工具做迭代式查询,而不是做 embedding 相似度匹配。
TaskMem 把记忆当写入端问题:假设智能体在看一条没有尽头的实时视频流,之后永远没有机会重看原始画面;真正的工程风险在于固定字幕器会记错东西:记太少,答案早就丢了;记太多,记忆本身长到没法用。它的答案是把「写记忆」变成一个可以用 RL 学习的策略,部署后再用一个 preference 微调的小 adapter 去适配具体任务。
两篇各做了一半:MemDreamer 的图是由感知模型用普通方式写的,没有学习过的写入策略;TaskMem 的智能体也只是普通地「读」自己写下的记忆,没有结构化检索。正因为各管一半,这个对比才有意义:下面的数字能告诉你每一半单独值多少。
关键数字
| 测量项 | MemDreamer | TaskMem | 场景与出处 | 同口径? |
|---|---|---|---|---|
| 基座模型(冻结) | Gemini-3.1-Pro(感知+推理) | Qwen3-VL-30B-A3B | 两篇都不动基座权重 | 否(基座不同) |
| 训练量 | 零(免训练) | 326 条视频上 GSPO RL,再对 layer 22 一个 2,048 参数 adapter 做 DPO | TaskMem 论文 | n/a |
| LVBench | 90.7,对照端到端 78.2(+12.5) | 未跑 | MemDreamer 论文 | 是,同一 Gemini-3.1-Pro |
| LongVideoBench | 92.9(+14.3) | 未跑 | 同上 | 是 |
| Video-MME(长视频) | 91.0(+14.0) | 67.9,对照基线 61.6(+6.3) | 两篇都测了,但基座不同 | 否,别把 91.0 和 67.9 直接比 |
| EgoSchema | 92.1(+11.8) | 未跑 | MemDreamer 论文 | 是 |
| EgoLife | 未跑 | 45.4,对照 38.4(+7.0) | TaskMem 论文 | 是,同一 Qwen3-VL-30B |
| EgoTempo | 未跑 | 27.6,对照 22.3(+5.3) | 同上 | 是 |
| 单次推理上下文 | 5.9K-6.3K token,对照端到端 240K-784K(约 40 倍压缩) | 未以 token 报告 | MemDreamer 论文 | 是 |
| 检索方式消融 | embedding 查找 70.5 对全套 agentic 工具 90.7(+20.2) | n/a | 同上 | 是 |
| 图结构消融 | 平铺存储 77.4;只加因果/时序边 84.8;只加层级 86.3;完整图 90.7 | n/a | 同上 | 是 |
| 两阶段拆分(VideoMME) | n/a | 阶段一 64.4,阶段一+二 67.9 | TaskMem 论文 | 是 |
| 记忆覆盖率/精度(VideoMME) | n/a | 79.3% / 85.6%;EgoLife 精度 73.3% → 80.5% | 同上 | 是 |
看这张表更要看它缺什么:没有任何一行是两篇在同样的基准、同样的基座上同场竞技。Video-MME 两篇都测了,但一边是 Gemini-3.1-Pro 的 91.0,一边是 Qwen3-VL-30B 的 67.9,这是基座差距,不是记忆方法的差距。所以这个对比只能各自回答「比自己的端到端基线强多少」,再用消融给每个设计选择标价,排不出两篇之间的名次。
MemDreamer 的读取端买到了什么
头条结果是最干净的那种同模型对比:Gemini-3.1-Pro 端到端跑 LVBench 得 78.2,同一套权重放进 MemDreamer 框架得 90.7,提升 12.5 分,距人类专家参考分还差 3.7 分。LongVideoBench(92.9,+14.3)、Video-MME 长视频(91.0,+14.0)、EgoSchema(92.1,+11.8)上是同一规律。因为零训练,框架对弱推理者的帮助更大:Qwen3-VL-235B 从端到端 63.6 跳到 84.8,提升 21.2 分。
消融才是真正的论证。把图退化成平铺的分块存储,LVBench 掉到 77.4,只比端到端好一点点;只加因果和时序边恢复到 84.8;只加层级恢复到 86.3;完整结构才到 90.7。层级和边修的是不同的失败,而且能叠加。检索侧,静态 embedding 查找 70.5,七个工具的 agentic 循环 90.7,差距 20.2 分,其中沿实体和因果边做图遍历单项就贡献 +6.6。把整个图直接塞进上下文(“Full Memory”)对总结题有帮助(81.3),推理题却崩到 72.7,未过滤的结构本身就是噪声。这和 超越语义相似度的检索反思 是同一个教训:对智能体检索来说,「看起来相似的片段」不等于「相关的片段」。
最有意思的是一个相关系数。八个模型上,AIME2025 推理分和 LVBench 的相关性,端到端摄入时是 Pearson 0.702(p=0.052,不显著),放进 MemDreamer 后升到 0.897(p < 0.01)。原始视频 token 会挡住模型调用自己已有的推理能力,解耦之后这条链路才接通。这把长视频理解的进展重新定义为检索与记忆问题,而不是感知问题。Watch, Remember, Reason 在整视频理解上做的是同一种解耦。
TaskMem 的写入端买到了什么
TaskMem 的绝对数字小一些,但它解的约束更难:智能体只能凭自己写下的记忆作答,流式场景里没有重看的机会。把三个基准改造成这个协议后,训练过的写入策略在 VideoMME 得 67.9%、EgoLife 45.4%、EgoTempo 27.6%,分别比 Qwen3-VL-30B-A3B 基线高 6.3、7.0、5.3 分。最大的绝对提升出现在第一视角日常生活视频上:这正是「不分青红皂白全记下来」最容易失效的场景。
阶段拆分证明起作用的是任务塑造,不是泛泛的摘要质量。阶段一用 GSPO RL 在 326 条长视频上优化记忆质量,奖励由格式合规、软长度惩罚、GPT-4o/Gemini-2.5-Flash 评判的质量项、以及组内 richness 排序项组成,把 VideoMME 从 61.6 提到 64.4,幅度有限。阶段二把部署端稀疏的任务反馈通过任务相关性奖励模型转成 DPO 偏好对,只微调 transformer 第 22 层一个 2,048 参数的 adapter,30B 基座全程冻结作参考模型。这一阶段补齐了剩余的提升到 67.9,同时把 VideoMME 记忆覆盖率推到 79.3%、精度 85.6%,EgoLife 精度从 73.3% 升到 80.5%。「适配智能体记什么」从此变成一个可以按部署下发的小开关,而不是一个重训练项目。
两个诚实的标记值得记住。EgoTempo 上所有方法都不到 30%,而且 GPT-5.2 参考模型在时间类问题上略胜 TaskMem(尽管 TaskMem 精度更高)。第一视角时序推理远没有被解决。另外整条奖励链依赖前沿模型当评委,继承了它们的偏差和每次调用的成本。
怎么选
- 视频已录好、问题事后才来、离线算力负担得起:选 MemDreamer。感知pass 建一次图,之后每个问题都很便宜,同模型 +12.5 到 +14.3 的提升零训练可得。
- 实时或无边界的视频流、没有机会重新索引:选 TaskMem。MemDreamer 的架构预设了离线建图;可穿戴设备、盯着屏幕看的助手这类必须「凭已写下的记忆作答」的场景,需要的是一个写入策略,而 2K adapter 的设计就是为部署后适配而生。
- 瓶颈是在一份好记忆里找不到事实:检索是短板,图结构和 agentic 工具是杠杆:embedding 到 agentic 的 20.2 分差距是整个对比里最大的单个数字。
- 瓶颈是记忆本身就记错了内容:写入是短板,任务塑造的写入策略是杠杆:阶段二在阶段一之上只调 adapter 还能再涨,说明任务相关性才是动分数的东西。
- 开源弱基座:两个都帮弱模型更多。MemDreamer 在 Qwen3-VL-235B 上 gains +21.2,大于 Gemini 上的 +12.5;TaskMem 的整个前提就是让冻结的 30B 在端到端读取必然失败的场景里仍然可用。
局限与存疑
MemDreamer 的成本藏在上游。「约 40 倍上下文压缩」只描述了推理阶段:推理窗口确实只有 5.9K-6.3K token,但建记忆本身在 LVBench 上每条视频花了 40.3K token 的感知上下文,而且感知错误会静默传播:一整条写错的子图会直接封顶准确率,感知没写下来的东西 agent 永远找不回来。感知模型从 Gemini-2.5-Pro 换成 Gemini-3.1-Pro 只动最终分数 0.4-1.4 分,这点让人安心,但两个阶段都没有报告耗时或费用。12 轮工具预算、检索 top-k、embedding 模型全是调过的旋钮;而且所有基准都是精心整理的视频 QA,规模化开放式总结、记忆需要在线更新的流式场景都没有测过。
TaskMem 的成本藏在下游。阶段二需要部署环境的真实任务反馈来构造偏好对;冷启动、没有任何任务信号时就退回阶段一的水平,64.4 而不是 67.9。评测全部是 VQA 形式,证明的是「记忆写入策略能提升问答」,不是规划、工具使用或动作选择。智能体记忆最终要在那些地方证明自己。EgoTempo 全员不到 30% 也在提醒:再好的写入策略,也救不了基座做不了的时序推理。
最明显的缺位实验是把两者合体:用 TaskMem 训练过的写入策略去生产 MemDreamer 的图节点,再用 agentic 检索去读。两篇都没跑这个组合,在有人跑出来之前,「写入端和读取端哪边更重要」没有受控答案。
常见问题
MemDreamer 和 TaskMem 哪个更好?
没有同场竞技的数字。MemDreamer 最硬的证据是同模型对比:Gemini-3.1-Pro 进框架后 LVBench 从 78.2 到 90.7。TaskMem 最硬的证据是相对基线:Qwen3-VL-30B-A3B 靠训练过的写入策略在 VideoMME 从 61.6 到 67.9。两篇的 Video-MME 数字(91.0 对 67.9)基座不同,不能直接比。
两篇需要重训基座 VLM 吗?
都不需要,这正是共同前提。MemDreamer 免训练,同一个冻结的 VLM 兼任感知和推理。TaskMem 冻结 30B 的 Qwen3-VL 骨干,只用 DPO 训练 layer 22 上一个 2,048 参数的 adapter,以阶段一模型为参考。
MemDreamer 到底省了多少上下文?
推理模型单次运行只保留约 5.9K-6.3K token,而端到端 VLM 要摄入 240K-784K,大约 40 倍压缩。这个数只算推理阶段;离线建图的感知 pass 在 LVBench 上每条视频消耗 40.3K token 感知上下文。
为什么 MemDreamer 里 agentic 检索打得过 embedding 搜索?
静态 embedding 查找在 LVBench 得 70.5,全套七工具循环得 90.7,差 20.2 分。单轮语义召回只能找到画面相似、和问题没有因果关系的片段,还不会自我纠偏;迭代循环能沿实体和因果边走下去,光图遍历一项就贡献 +6.6。
TaskMem 两阶段训练比单做 RL 多买到了什么?
阶段一(GSPO RL 优化记忆质量)把 VideoMME 从 61.6 提到 64.4;加上阶段二(用任务相关性偏好对 DPO 微调一个 2,048 参数 adapter)到 67.9。也就是说大头来自任务塑造,而不是更好的通用摘要能力。三个基准上阶段一都只贡献 1-2 分,其余全是阶段二的。
能把 MemDreamer 和 TaskMem 组合起来吗?
概念上它们互为补集:学习过的写入策略产出更好的图节点,agentic 检索负责读。目前没有公开结果跑过这个组合,这是这个方向上最值得做的开放实验。