
MemPrivacy 与 TaskMem 对比:智能体记忆写入的双重闸门
MemPrivacy 管住什么不能上云(效用损失压在 1.6% 以内),TaskMem 教会视频智能体什么值得记(VideoMME 61.6% 提到 67.9%)。同一道闸门的两个方向。
两篇论文从相反方向守同一道闸门
每个长期运行的智能体每天都要默默做同一个决定几十次:这条新到的观察,写进记忆还是不写?全写,又贵又不安全;不写,智能体就成了金鱼。关于持久智能体的综述persistent autonomous AI认为,从聊天机器人到数字同事的真正飞跃不是模型更大或工具更多,而是跨会话存活的状态。2026 年的这两篇论文恰好从相反方向攻这道状态,放在一起读比单独读任一篇都有用。
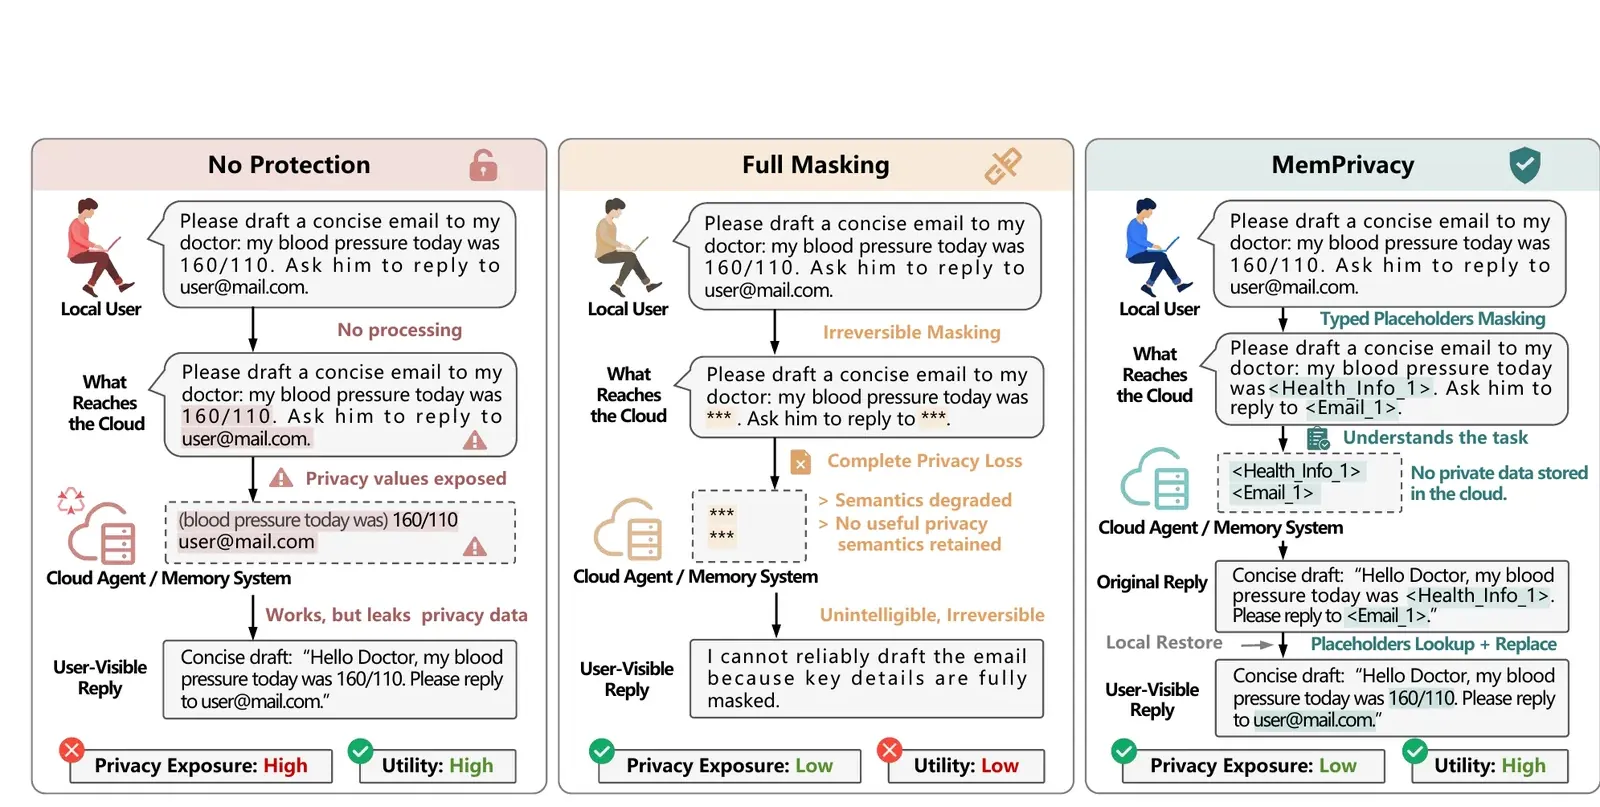
MemPrivacy(MemTensor、HONOR、同济大学,arXiv 2605.09530)从隐私侧看写入。端设备把记忆管理卸载给云端智能体时,血压读数、邮箱地址这类敏感片段会以明文离开手机。MemPrivacy 在端侧检测这些片段,换成带类型的占位符,让云端记忆系统在占位符之上正常工作,回复返回后再在本地还原原值。保护被刻意设计成可逆的,因为记忆场景下你几乎总是稍后还需要这个值。
TaskMem(ByteDance Seed、复旦大学,arXiv 2605.31075)从效用侧看写入。流式接收第一视角视频的多模态智能体面对的是观察的组合爆炸,而大多数记忆管线只会写下冻结字幕器碰巧产出的内容。TaskMem 把记忆生成重构为可学习的策略,用强化学习训练,让智能体按部署环境里真实任务奖励什么来决定什么值得记住。
同一道闸门,两个相反的问题。MemPrivacy 问”什么不许离开设备?“,TaskMem 问”什么配得上被记住?”只做一边的系统,要么泄露,要么遗忘。
MemPrivacy 如何保护写入
机制分三段,顺序很关键。第一段,端侧检测器给用户消息里的隐私敏感片段打标。第二段,被标中的值换成带类型占位符,“我今天的血压是 160/110”在上云前变成 <Health_Info_1>。第三段,云端智能体或记忆系统照常在占位符文本上工作,用户看到回复前在本地查表把原值填回。云端永远不存原值,但保留了足够的类型结构来维持可用性。
两个设计选择撑起了全部结果。给占位符标类型(健康信息、邮箱、姓名)保住了通用掩码会破坏的语义类别;论文显示无类型占位符仍损失 4.72-8.71% 效用,类型标注本身就在干活。又因为检测器只需要找片段、不需要理解任务,小型专用模型就够:作者用监督微调加 GRPO(奖励信号是检测 F1)训了六个 0.6B 到 4B 的检测器。
他们还自建了 MemPrivacy-Bench,因为现有基准覆盖不了分级、可逆的记忆隐私。训练集 26,016 轮、来自 160 名用户(12.5 万+隐私实例),测试集 6,337 轮、来自 40 名用户(2.99 万实例),合计约 100 万对话 token,中英文各半;人工核验标注准确率 98.08%。评测在三个常用记忆系统上进行:LangMem、Mem0、Memobase。
TaskMem 如何塑造写入
TaskMem 把记忆当作策略而不是固定的摘要步骤。训练分两阶段。Phase One 教策略”怎么记”:在正确性、非冗余、格式合规等基本保真要求下优化记忆质量,建模成多目标 RL。Phase One 单拎出来只带来 1 到 2 分的提升,说明通用记忆质量并不是瓶颈。
Phase Two 才是贡献所在。部署之后,策略通过微调一个只有 2,048 参数、位于 transformer 第 22 层的轻量 adapter 来学习”记什么”,以 Phase One 模型作为冻结参考。稀疏、嘈杂的任务反馈先经任务相关性奖励模型转成成对偏好数据,再用 DPO 调 adapter,让智能体的记忆写作偏向部署任务奖励的内容,全程不动基座权重。代价是冷启动:没有任务信号时,质量退回 Phase One 水平。
评测的诚实度值得点名。作者把 VideoMME、EgoLife、EgoTempo 改造成流式基准,问题必须仅凭记忆回答,不许回看原视频,基座是 Qwen3-VL-30B-A3B。
关键数字
| 维度 | MemPrivacy | TaskMem |
|---|---|---|
| 写入优化目标 | 敏感片段不上云,记忆仍然好用 | 任务相关的观察进记忆,其余的丢弃 |
| 机制 | 端侧片段检测、带类型可逆占位符、本地还原 | 两阶段 RL 记忆策略;Phase Two 微调第 22 层 2,048 参数 adapter |
| 基准规模 | MemPrivacy-Bench:200 名用户(160 训练 / 40 测试),12.5 万+ 训练与 2.99 万测试隐私实例,约 100 万 token,中英各半,标注准确率 98.08% | VideoMME、EgoLife、EgoTempo 改造成流式纯记忆问答 |
| 主打指标 | 检测 F1 85.97%(MemPrivacy-Bench),94.48%(PersonaMem-v2) | VideoMME 准确率 67.9%(P1+P2)对 61.6% 基线;EgoLife 45.4% 对 38.4%;EgoTempo 27.6% 对 22.3% |
| 对比前沿通用模型 | 比 GPT-5.2 高 +16.98 F1、比 Gemini-3.1-Pro 高 +7.56;PersonaMem-v2 上 +6.42 / +7.89 | GPT-5.2 参考在 EgoTempo 时间类问题上略超 TaskMem,尽管 TaskMem 精度更高 |
| 机制代价 | 全量保护(PL2-PL4)效用损失 0.71-1.60%,仅 PL4 为 0.08-0.33%,横跨 LangMem、Mem0、Memobase | Phase One 只加 1-2 分,其余靠 Phase Two;adapter 仅 2,048 参数 |
| 被击败的基线 | 不可逆掩码损失 16.99-41.87% 效用;无类型占位符损失 4.72-8.71%;OpenAI-Privacy-Filter 只有 35.50% F1 | 冻结字幕器记忆管线(Qwen3-VL-30B-A3B):61.6% / 38.4% / 22.3% |
| 延迟与体积 | 端侧检测 MemPrivacy-Bench 约 2 秒、PersonaMem-v2 不到 1 秒;检测器 0.6B-4B | 非重点;Phase Two adapter 本身极小(2,048 参数) |
两列要当成两种不同的度量读,不是同一张榜。MemPrivacy 的 F1 测的是作者自建基准上的片段检测质量,效用是三个具体记忆系统上的下游代价;TaskMem 的准确率测的是流式视频纯记忆问答,其 VideoMME 记忆精度 85.6%、覆盖率 79.3%,EgoLife 精度从 73.3% 升到 80.5%。能站住的跨论文结论很窄:两篇都证明记忆写入闸门是可学习、可低成本控制的,而朴素默认(全掩码或全记)要么代价惨重(最高损失 41.87% 效用),要么无用(忽略任务的字幕器)。
怎么选
你在给智能体搭记忆层,想知道抄哪篇。答案几乎都是”两篇都抄,按这个顺序”,但优先级看部署形态。
先做 MemPrivacy 的场景:用户文本可能含个人身份信息,且记忆处理的任何一环在设备之外。数字已经把账算清:全量保护只损失 0.71-1.60% 效用,而掩码反射在同样系统上损失 16.99-41.87%。端云拆分是现实的:0.6B-4B 的本地专用模型每次交互约 2 秒,检测任务本身比 GPT-5.2 高 16.98 F1。
先做 TaskMem 的场景:智能体被观察淹没,瓶颈是记忆内容质量而非隐私。可穿戴设备、屏幕助理、记录一天的机器人都是这个画像:冻结字幕器写什么就是什么,部署任务跟着吃亏。只要手里有真实任务反馈能构造偏好对,一个 2,048 参数 DPO adapter 是能活过生产环境的便宜旋钮。
两篇都跑的话,顺序有讲究:TaskMem 的策略决定什么值得占一个记忆槽位,MemPrivacy 的过滤器决定什么可以离设备去换这个槽位。TaskMem 默认记忆存储可信,MemPrivacy 默认写进来的内容值得保护,两个假设互不覆盖;且两篇都没评测过组合方案,这是真空白,不是吐槽。
局限与存疑
MemPrivacy 的保证强度等于检测器召回率:F1 85.97% 意味着总有敏感片段仍以明文出设备。基准是作者自建、人工标注到 98.08% 准确率,与 GPT-5.2、Gemini-3.1-Pro 的对比没有第三方复现。带类型占位符减少但不消除泄露,云端仍能学到私密数据的结构和类型。威胁模型假设云端”诚实但好奇”,不防用辅助信息主动反演占位符的云;1.6% 以内的效用数字只在三个记忆库上测过,不是任意多轮任务。
TaskMem 的评测全是 VQA 式:凭记忆答问题。它没有展示策略对规划、工具调用、动作选择的帮助,而智能体记忆最终要在那些地方证明自己。Phase Two 需要真实任务反馈,冷启动退回 Phase One 质量。质量奖励依赖 GPT-4o 和 Gemini-2.5-Flash 当裁判,继承了它们的偏见和成本。EgoTempo 的绝对数(所有方法都不到 30%)提醒:第一视角视频流上的时间推理远未解决,GPT-5.2 参考在该子集仍略胜 TaskMem。
常见问题
MemPrivacy 和 TaskMem 的核心区别是什么?
MemPrivacy 控制哪些记忆内容可以离开设备,手段是本地处理的带类型可逆占位符;TaskMem 控制哪些观察值得被写进记忆,手段是强化学习学到的记忆策略。一个是写入上的隐私过滤器,一个是写入上的相关性过滤器。
MemPrivacy 在 MemPrivacy-Bench 上的结果如何?
最好的 MemPrivacy 检测器 F1 达 85.97%,比 GPT-5.2 高 +16.98、比 Gemini-3.1-Pro 高 +7.56,而 OpenAI-Privacy-Filter 基线只有 35.50%。全量 PL2-PL4 保护在 LangMem、Mem0、Memobase 上损失 0.71-1.60% 任务效用,对比不可逆掩码的 16.99-41.87%。
TaskMem 在 VideoMME 和 EgoLife 上的结果如何?
TaskMem(Phase One 加 Phase Two)在 VideoMME 上达 67.9%,基线 61.6%;EgoLife 45.4% 对 38.4%;EgoTempo 27.6% 对 22.3%。Phase One 单独只贡献 1-2 分,其余提升由 2,048 参数的 Phase Two adapter 带来。
两篇方法能组合吗?
两者解决的问题不同,天然可组合:TaskMem 决定什么值得记,MemPrivacy 决定什么可以上云。但两篇都没评测组合方案,联合后的效用、延迟、记忆质量成本是工程上的开放问题。
这些数字能复现吗?
两篇都用自己的基准(MemPrivacy-Bench;VideoMME、EgoLife、EgoTempo 的流式改造),把头条数字当作绑定协议来读。MemPrivacy 放出了代码和模型,TaskMem 有项目页,但真正的检验是在你自己的任务上做第三方复现。