
MTP vs NITP:两种跳出「逐词监督」的路线
MTP 加离散头一次起草多个 token 换吞吐;NITP 加稠密目标预测下一 token 浅层表示,只花约 2% 训练算力换准确率。
共同的靶子
标准 next-token prediction(NTP)在每个位置只用一个离散标签监督模型:下一个 token 的 ID。两条研究路线都认为这种监督太浪费,但各自针对浪费的不同半边下手。
多 token 预测(MTP),代表作是 Bebop,抱怨的是 NTP 让算力串行消耗。每个位置模型只吐出一个 token 的分布就停手;MTP 头则基于同一个 hidden state 直接预测后面 γ 个位置(t+1 到 t+γ)。推理时这些额外的头负责成批起草 token,主模型负责验证,每接受一个草稿就省一次前向计算。收益体现在墙上时间上;在 RL 训练里 rollout 生成占了大头,这笔收益尤其可观。
下一隐式 token 预测(NITP),来自 NITP 论文,抱怨的是 NTP 的目标太稀疏。单个 token ID 几乎约束不了每个位置上丰富的 hidden state,表示空间的几何结构大部分只能被间接塑造,容易塌缩成低秩形态。NITP 增加第二个连续目标:在位置 t 预测 t+1 位置的浅层 hidden 表示。收益是表示质量,只在训练期付出,推理前即可丢弃。
两者都是加在 NTP 上的辅助目标,都没有替换交叉熵读出层。除此之外,几乎每个细节都不同,这正是本篇要对照的东西。
关键数字
| 指标 | MTP(Bebop) | NITP | 设置与出处 |
|---|---|---|---|
| 预测的对象 | t+1 … t+γ 的离散 token ID | t+1 的连续浅层表示(约 20% 深度,stop-gradient) | Bebop 第 3 节 / NITP 第 3 节 |
| 真正起作用的目标函数 | 端到端全变差(TV)损失 | 余弦相似度(MSE 会发散) | Bebop 图 8 / NITP 消融 |
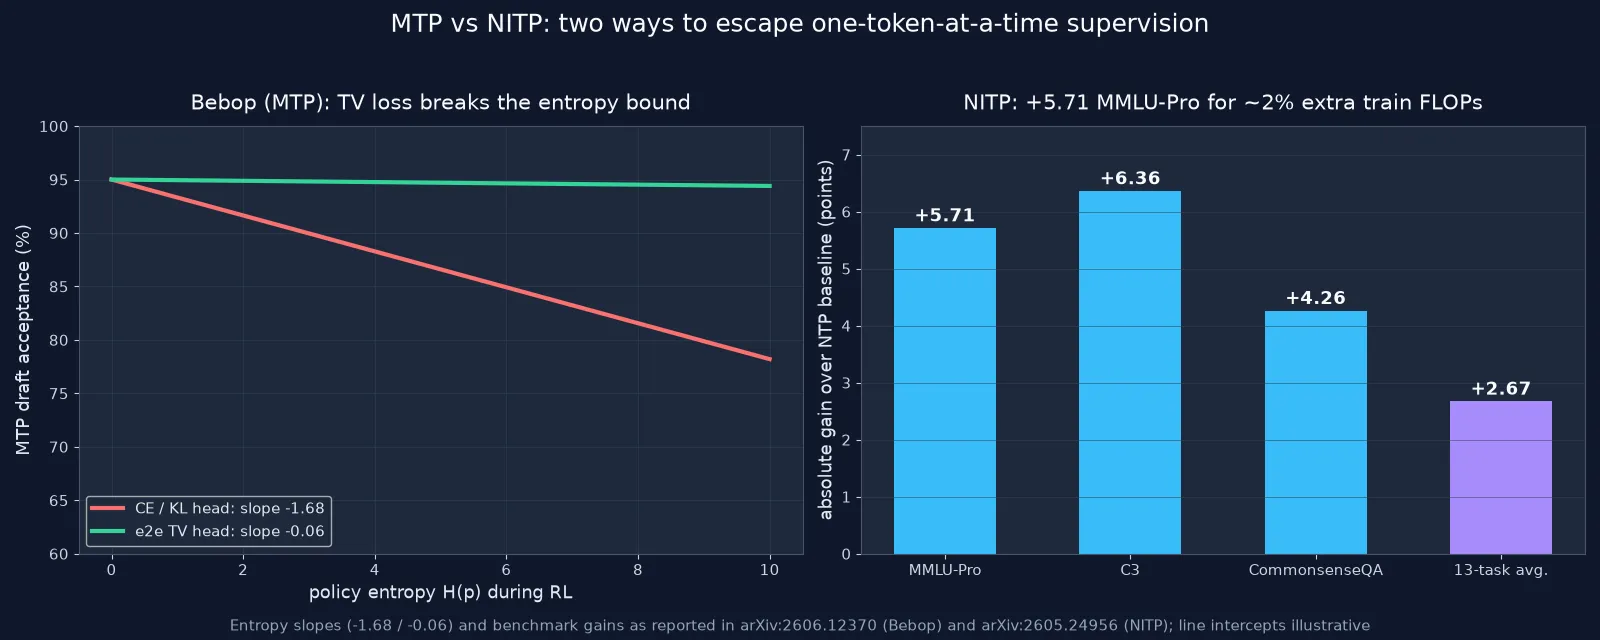
| 准确率 headline | 无;拒绝采样下输出可证无偏 | MMLU-Pro 15.29 → 21.00(+5.71),13 项基准平均 +2.67 | NITP,9B MoE(激活 1B) |
| 吞吐 headline | 接受率保持在 95% 附近(比 CE 高约 10 个点);RL 延迟降至 1/1.5–1.8,agentic rollout 2.4 倍 | 未测;纯训练期目标 | Bebop 图 8–9 |
| 抗熵能力 | 接受率对熵的斜率 −1.68(CE)→ −0.06(TV) | 未在 RL 高熵场景下测试 | Bebop 图 8 |
| 推理开销 | 零;MTP 头就是起草器 | 零;隐式 token 头训练后丢弃 | 两篇论文一致 |
| 训练开销 | RL 前一次性 TV 训练,需融合全词表 kernel | 约 2% 额外训练 FLOPs,墙上时间几乎不变 | Bebop 第 5 节 / NITP 第 4 节 |
| 收益衰减处 | 分布外任务:SWE-Bench 分布内 +8.0,MT-Bench 分布外仅 +2.3 | 45B 以上 MoE 未验证;收益集中在知识与阅读任务 | 两篇的局限节 |
| 验证过的规模 | Qwen3.5 / 3.6 / 3.7 的 RL 训练 | 1.9B–45B MoE、0.5B–3B dense | 两篇论文 |
请注意这张表没有的东西:把两个目标放进同一次训练、同时测准确率和接受率的对照实验。两篇论文里都不存在这个实验,所以表中每一行来自不同的模型家族和不同的测量口径,不能直接横向相减。
各自的机制
MTP:起草 γ 个 token,验证,接受
Bebop 的 MTP 头在 rollout 时向前起草 γ 个 token。它要解决的独特问题出在 RL 场景:论文证明,贪心校验下的草稿接受率随策略熵线性下降,即 α ≈ a − b·H(p)。而 RL 训练为了探索会刻意维持高熵:让 RL 生效的机制,恰好也在侵蚀让 rollout 便宜的东西,而 rollout 恰恰是异步 RL 的瓶颈。
Bebop 的修复由两个可拆开的部分组成。拒绝采样替代贪心校验:以概率 min(p(v), q(v)) 接受草稿 token v,无论草稿多差,采样输出都与目标分布严格一致,接受率等于 1 − d_TV(p, q)。但拒绝采样本身打不破熵界:用交叉熵训练的头,斜率还是 −1.68。真正承重的是全变差训练损失:它直接优化 d_TV,梯度有界且与草稿概率 q_j 成正比,优化力度落在概率质量真正在的地方,把熵斜率压到 −0.06。
消融实验把这个损失选择的重要性量化了。在同样的拒绝采样下:KL 比 CE 只多 +0.0 到 +0.2 个接受点,反向 KL +1.0 到 +1.3,逐 step TV +2.4 到 +5.2,端到端 TV +3.0 到 +8.0。损失越接近直接优化接受率这个量,效果越好。
NITP:监督表示,而不只是读出
NITP 不动 NTP 头,另训一个并行头,去预测下一位置的浅层 hidden state。三个设计选择都很关键,而且都是消融选出来的,不是拍脑袋。
第一,目标取自约 20% 模型深度的浅层,并过 stop-gradient,让它扮演稳定教师而不是移动靶;浅层目标明显优于中层和深层。第二,预测带时序位移:位置 t 的模型去匹配 t+1 的隐式 token,与 NTP 的前瞻对齐;对齐当前位置则明显更差。第三,损失用余弦相似度,论文报告 MSE 会直接发散。这说明该方法对目标归一化敏感,部署团队应把它当成需要调参的风险点,而不是免费的午餐。
论文给出的机制解释是几何层面的:NITP 训练出的表示有效秩更高,支持了「稠密目标抑制纯 NTP 留下的表示塌缩」这一说法。
各自真正买到什么
MTP 只买吞吐,别的什么都不买。 Bebop 明确说准确率不变,因为拒绝采样保证采样输出与目标分布一致。如果你看到「打破熵界」以为是推理能力提升,那不是。这里的熵是策略的采样熵,界是草稿接受率的界。它的商业账很纯:agentic RL rollout 提速 2.4 倍,普通 RL step 提速 1.5–1.8 倍,训练侧代价只是 RL 开始前对 MTP 头做一次性 TV 训练。值得注意的是,RL 进行中若改用 CE 继续训这个头,收益会流失回基线;继续用 TV 则没有额外收益,RL 前训好就足够了,顺带省掉了在线训头的显存开销。
NITP 只买准确率,别的什么都不买。 它没有推理期组件:隐式 token 头训练后即丢弃,部署模型与 NTP 基线完全一致,论文也没有测任何延迟指标。它的账是:约 2% 的训练 FLOPs 加价,换 9B MoE 上 13 项基准平均 +2.67 分,单项最大涨幅是 MMLU-Pro +5.71。3B dense 模型平均也涨了 +1.35,所以这个目标不是 MoE 专属。
局限与存疑
MTP 的接受率收益是分布内的。同一个头能把 SWE-Bench 接受率从 75.1% 抬到 83.1%,在分布外的 MT-Bench 上只多 +2.3,所以 TV 训练的头未必迁移到离 RL 数据很远的流量。接受率仍会随生成位置和采样温度下降(两者都推高熵),长 agentic rollout 还会出现周期性的接受率波动(「气泡问题」)。全词表 TV 损失需要融合 kernel;top-K=20000 的近似会拖慢收敛并损害效果。所有验证都在 Qwen 模型 + GRPO 上完成,向其他模型家族和 RL 算法的迁移是假设而非结论。
NITP 报告过的最大模型是 45B MoE(激活 5.5B),离前沿规模还很远,「2% 换好几分」的交易在数千亿参数上是否成立没有验证。基准收益集中在知识和阅读理解类任务上;对生成质量、长上下文、推理链的迁移未测。MSE 发散这一结果意味着余弦损失的选择不是装饰:重新实现的团队应当预期在目标归一化上花调参功夫。
怎么选
这是一个「瓶颈在哪」的问题,不是「质量谁高」的问题。如果成本大头在生成 token(RL rollout、高并发推理)且能加起草头,带 TV 损失的 MTP 是不损准确率的纯提速;周边的起草机制可见 Domino 投机解码,在线蒸馏起草头见 Draft-OPD。如果你在做预训练,想要这对论文里单位算力最便宜的分涨,NITP 用约 2% 加价换好几分基准收益是更划算的交易。
两个能一起用吗?两篇论文里没有任何内容排除这种组合,机制上也不冲突:一个改 MTP 起草头的损失,一个给主模型加表示层目标。但设计上的正交不等于叠加有效,也没有任何已发表结果把 NITP 和 TV 训练的 MTP 头放在一起训练、同时报告基准分和接受率。「可以叠加」是假设,不是建议。
常见问题
MTP 和 NITP 是一回事吗?
不是。MTP 向前预测多个离散 token ID,用这些预测在推理时起草并验证 token,追求的是吞吐。NITP 向前预测一个连续表示作为额外训练目标,追求的是表示质量。两者唯一的共同点是都认为 NTP 的监督太薄。
多 token 预测会提升模型准确率吗?
在 Bebop 的设置里不会。拒绝采样以概率 min(p(v), q(v)) 接受草稿 token,无论草稿质量如何,采样输出都与目标模型分布严格一致。收益全在 rollout 速度上:异步 RL 最高 1.8 倍,agentic rollout 2.4 倍,基准分不变。
NITP 的成本是多少?
约 2% 的额外训练 FLOPs,墙上时间几乎不变;推理零成本,因为隐式 token 头训练后即丢弃。对应回报是 9B MoE 上 MMLU-Pro +5.71、13 项基准平均 +2.67。
为什么 Bebop 里 TV 损失比交叉熵更适合训 MTP 头?
因为拒绝采样下的接受率等于 1 − d_TV(p, q),而 TV 损失直接优化这个量,其梯度与草稿概率 q_j 成正比,优化力度落在概率质量所在处。CE 和 KL 造成的是均匀的逐 token 失配,高熵策略会把概率摊到指数级大的有效支撑集上,失配随之累积,所以无论哪种,接受率都按 −1.68 的斜率随熵恶化;TV 把它压平到 −0.06。
我应该用哪个?
瓶颈在生成 token(RL rollout、高并发推理)且能加起草头,就用带 TV 损失的 MTP,它是纯提速、不损准确率。如果你在做预训练,想要这对论文里单位算力最便宜的分涨,NITP 用约 2% 加价换好几分基准收益是更划算的交易。瓶颈不同,工具不同。