OVO-S-Bench 对比 TVRBench:空间智能是看懂的还是要走到
OVO-S-Bench 测 38 个 MLLM 流式空间智能,最强 59.2、人类 92.2;TVRBench 要模型走到目标视角,零样本 12.0%,SFT 后 50.8%。
两篇论文在测同一个问题
多模态模型给照片写一段漂亮描述并不稀奇,它能不能跟住自己周围的空间?这个问题有两种很不一样的问法,两篇 2026 年的基准论文用数字而不是演示视频来回答。OVO-S-Bench 是被动的问法:看一段第一人称视频流,在某个时间戳回答空间问题,而且只能看该时间戳之前的内容。TVRBench 是主动的问法:把模型放进三维环境,让它转动头部、移动身体,直到眼前的画面和目标图片一致。
两篇论文在任何数字被读出之前就已经在一个 headline 上达成一致:基础模型的空间智能不在语言智能所处的位置。它们的分歧也同样有用:缺口到底出在哪,训练能不能补上。放在一起读,你能知道该测什么、该练什么、以及不该对外声称什么。
OVO-S-Bench:流式协议下的空间理解
定义 OVO-S-Bench 的设计选择是只给前缀。1,680 道题里每道都带查询时间戳和证据区间,评测时模型只能看到问题之前的视频流前缀。任何需要偷看未来帧的答案在这里根本不可得。问题按抽象程度分四级:瞬时第一人称感知、时空上下文追踪、生成式空间推理,以及以旁观者视角建图(allocentric spatial mapping),也就是给当前屏幕之外的空间画地图。
标注投入本身说明了标注有多难:12 名训练过的标注员,每人同时兼任盲审交叉评审,在 348 段源视频上花了约 804 个人工时做多轮质量检查。整个基准由人标注,所以它用得起可核对的答案,而不是靠模型打分。
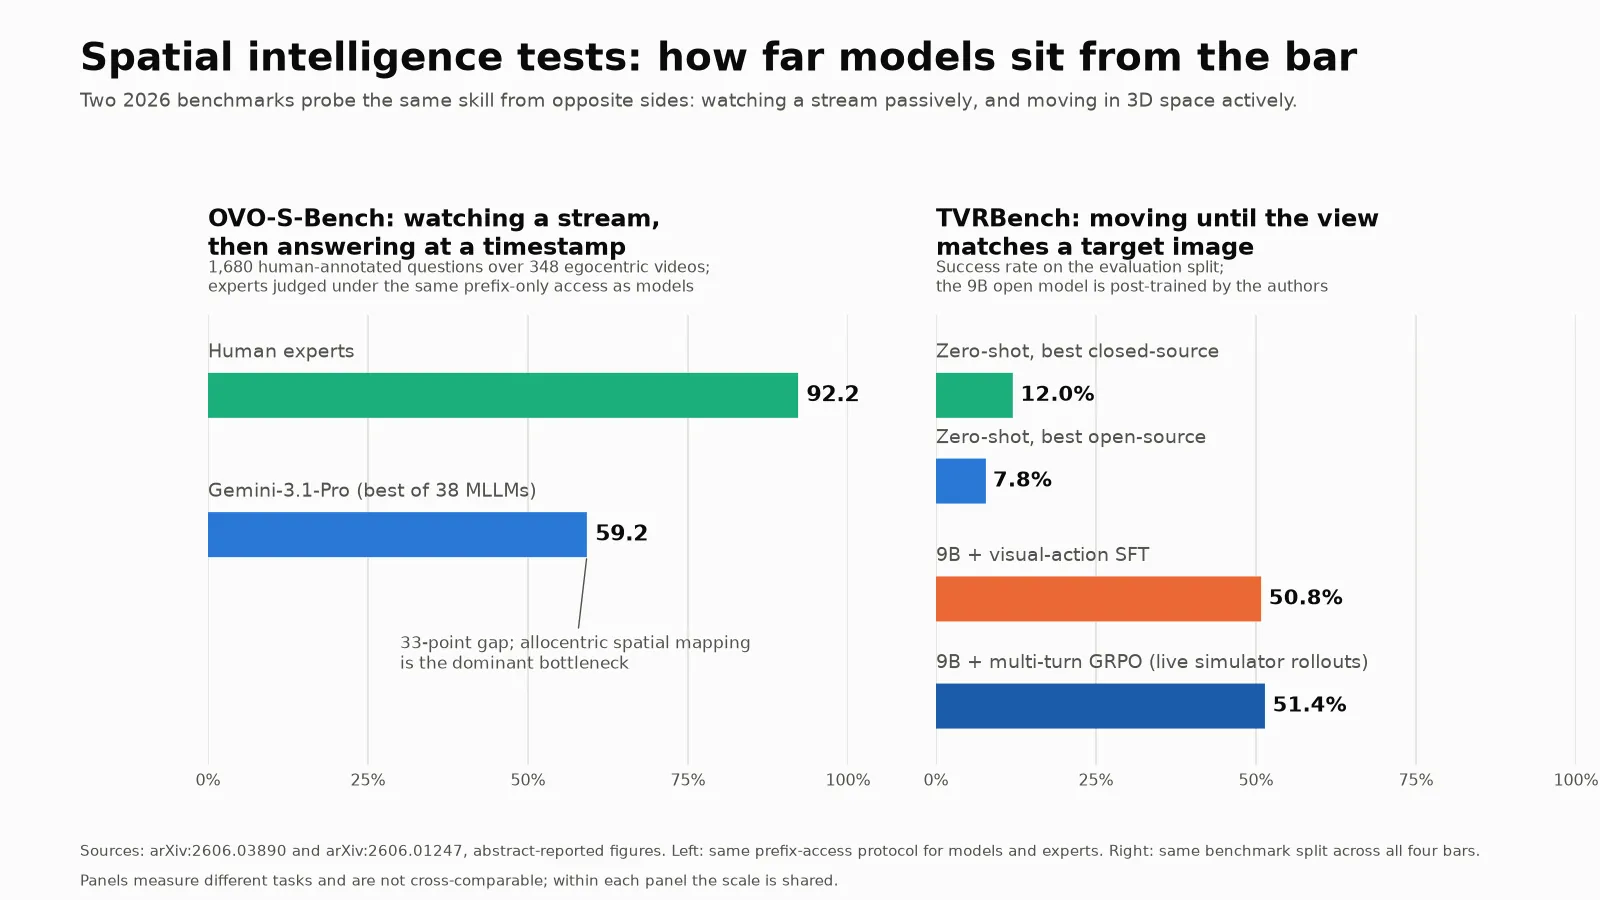
在 38 个闭源与开源 MLLM 中,最好的 Gemini-3.1-Pro 拿到 59.2,而在同样只给前缀的协议下,人类专家是 92.2。33 分的差距是论文的头条,比大小更重要的是差距的分布:以旁观者视角建图是最大的瓶颈,缺口恰好长在机器人、AR、自动驾驶助手真正需要的那一层。
两个次要发现才是开发者真正记住的东西。第一,为流式或空间任务微调过的 MLLM 反而打不过自己的基座,针对相近数据做定向调参在这里没有换来任何东西。第二,当推理没有扎根在视频流里时,思维链会放大空间错误;想得更久,答案更差。
TVRBench:把空间理解变成闭环控制
TVRBench 把提问换成了任务。目标视点复现(TVR)给智能体一张目标图,要求它在三维室内环境里调整自己的视点,直到实时画面和目标图匹配。每个回合的成功是二值的,基准还刻意变化场景规模和目标视角的视觉丰富度,不让一个数字躲在单一房型后面。
零样本下这个任务远未解决:在评测划分上,最强开源模型只有 7.8% 成功率,最强闭源模型 12.0%。细粒度分析点出两个一致的瓶颈:现成模型用不好多轮视觉历史;只要复现动作需要身体平移而不只是原地旋转,成绩就 sharply 下跌,暴露出把空间差异映射到具身动作上的缺口。
论文后半段是一个关于训练是否有用的受控实验。作者搭了统一的后训练框架,四个臂分别是:专家轨迹 SFT、带理由监督的 CoT-SFT、离线单轮 GRPO、以及在线多轮 GRPO(用模拟器实时 rollout)。结果的排序才是科学上有意思的部分:视觉动作 SFT 贡献了主要增益,把 9B 开源模型从个位数成功率拉到 50.8%;多轮 GRPO 补上跨房间的精修,总分 51.4%。而 CoT 监督和单轮 GRPO 都损害了闭环表现。换句话说,在静态基准上获胜的配方,也就是更多 verbal 推理,在模型必须照着所见行动时反而帮了倒忙。代码、数据和模型均已开放,所以这套框架同时是一份训练配方,不只是记分牌。
两个探针指向同一结论
三条结论经得起协议差异的考验。第一,卡脖子的约束是跨时间的状态,不是单帧感知:OVO-S-Bench 强迫模型在没有未来的前缀上推理,TVRBench 强迫模型在多步移动里积累视觉历史,两篇都在这里发现模型断掉。第二,熟悉配方的朴素放大在两个设定里都翻车:OVO-S-Bench 报告流式与空间微调让模型低于自家基座、无根思维链放大空间错误;TVRBench 报告 CoT-SFT 和单轮 GRPO 损害闭环成功。空间任务会惩罚一切不扎根于观察的推理。第三,主动设定里的缺口可训练,被动设定里未必:TVRBench 用视觉动作 SFT 加在线多轮 GRPO 把 9B 模型从 7.8% 拉到 51.4%,翻了七倍;OVO-S-Bench 没有 equivalent 的捷径,最好的零样本模型仍落后人类 33 分,作者试过的干预都没能缩短距离。规模带来的能力没有自动迁移成流式空间能力。
请把两边的百分比分开看:两个基准测的是不同任务、不同协议,只有同一面板内部才共用一把尺子。站内两篇论文页同样带这个提醒,下表在相关行里也逐行写明。
关键数字
| 维度 | OVO-S-Bench | TVRBench |
|---|---|---|
| 任务 | 只凭时间戳之前的前缀回答空间问题 | 在三维环境里移动到目标图对应的视点 |
| 规模 | 348 段第一人称视频上的 1,680 道题 | 变化场景规模与目标丰富度的室内仿真回合 |
| 标注 | 12 名标注员约 804 人工时,盲审交叉 | 专家轨迹做 SFT,模拟器实时 rollout 做 GRPO |
| 受测模型 | 38 个闭源与开源 MLLM | 开源与闭源基础模型,外加作者自训的 9B 开源模型 |
| 最佳零样本 | Gemini-3.1-Pro 59.2 | 闭源 12.0%、开源 7.8% 成功率 |
| 人类参照 | 同协议下专家 92.2 | 摘要未报告 |
| 训练的作用 | 流式或空间微调反低于基座 | 视觉动作 SFT 到 50.8%,多轮 GRPO 到 51.4% |
| 思维链的作用 | 无根 CoT 放大空间错误 | CoT-SFT 与单轮 GRPO 损害闭环成功 |
一条值得交叉阅读的相关工作:CrossView 重新审视了 MLLM 里空间推理该怎么训练,与 OVO-S「微调没有迁移」的发现正好呼应。它的数字来自另一套设定,当作背景读,别当表里的第三列。
怎么选
当你的问题是某个 MLLM 能不能充当流式系统的感知层,也就是机器人助手、AR 导览、自动驾驶副驾这一层,选 OVO-S-Bench 的数字。它的四个层级能告诉你失败发生在瞬时感知、上下文追踪、生成式空间推理还是建图级思考,这种诊断比单一能力分可行动得多。
当你的问题是模型能不能作用于空间而不只是描述空间,选 TVRBench。它的成功度量是二值的,后训练框架完全开放,而且 7.8% 到 51.4% 的轨迹让它成为少见的那种基准:本身就是一份训练配方,每个臂的回报都量得出来。
两个都别当采购排行榜用。两篇论文都在各自协议各自数据上报告结果,两边百分比不可互比;一个在人类 92.2 的基准上拿到好成绩,离部署问题被解决也还有距离。
局限与存疑
注意点大多在迁移上。OVO-S-Bench 全人工标注、协议干净,但只给前缀的流式设定仍然简化了真智能体,真智能体可以要求多看几眼;人类天花板是 92.2 而非 100,说明这套协议对专家自己也有代价。TVRBench 只有室内仿真,成功率搬到真实具身硬件上会不会变化没有测过;摘要也没有报告人类基线,所以光看论文不知道 TVR 上的人机差距有多大。
训练结果同样要克制解读。50.8% 和 51.4% 来自作者自家的后训练框架、自家的基准,载体只有单个 9B 开源模型。这作为「缺口可训练」的内部自洽证据是够的,作为「配方可跨模型家族跨环境迁移」的独立证据还不够。
两篇放在一起会引出一个值得追的问题:如果主动缺口靠训练在收拢,而被动缺口顶住了训练,那么 OVO-S 的部分 deficit 也许是数据和调参问题,而不是能力天花板。两篇都没有直接验证这一点,这是这组对比给出的最有价值的后续方向。
常见问题
做空间智能相关声明该引哪个基准,OVO-S-Bench 还是 TVRBench?
让声明对上任务形态。声明关于流式第一人称视频理解,引 OVO-S-Bench,引用同一前缀协议下 59.2 对 92.2 的人类对比;声明关于主动走到目标视点,引 TVRBench,引用 7.8% 与 12.0% 的零样本成功率以及 50.8% 与 51.4% 的训练后结果。
TVRBench 的后训练真能把成功率从 7.8% 拉到 51.4% 吗?
在 TVRBench 内部,可以,但带保留条件。专家轨迹上的视觉动作 SFT 贡献主要增益,把 9B 开源模型推到 50.8% 成功,在线多轮 GRPO 用模拟器实时 rollout 补上跨房间精修,总分 51.4%。另外两个臂,CoT-SFT 和单轮 GRPO,反而损害了闭环表现,所以这个提升依赖的是训练模型照着视觉反馈行动,而不是训练它谈论行动。
思维链在 OVO-S-Bench 上有用吗?
没有,这恰是论文最有分量的发现之一。当推理没有扎根在视频流里时,思维链会放大空间错误。更长的 verbal 推理让空间答案更差,这与 TVRBench「CoT 监督损害闭环视点控制」的结果正好互相印证。
OVO-S-Bench 里 Gemini-3.1-Pro 与人类专家相差 33 分,对机器人 MLLM 意味着什么?
它定位了缺口的位置。差距在旁观者视角建图这一级最大,也就是系统必须表示当前视野之外的空间的那一层,而这正是机器人、AR、驾驶助手需要的。所以这个数字最合理的读法是告诉你该投资哪一层,而不是宣判 MLLM 在空间任务上不可用。