COLLEAGUE.SKILL 与 MMSkills 对比:技能包里该装什么
两篇论文都把智能体技能做成「包」,但一个从真人痕迹蒸馏双轨文本包,一个从轨迹挖出带截图的多模态包,衡量的东西完全不同。
同一个设计问题
2025–2026 年,agent skill 的容器格式普及了:技能以文件夹形式随装随用,不再是隐藏的记忆库或手调的人设提示词。容器有了之后,真正的问题就变成里面装什么、内容从哪来。COLLEAGUE.SKILL 和 MMSkills 给了两种不同哲学,而它们给出的数字种类差异大到(诚实地说)本身就是对比的主要内容。
COLLEAGUE.SKILL 从人的证据出发:把一个人散落的文档、决策、聊天记录蒸馏成一个带版本的双轨技能包。MMSkills 从机器的证据出发:从公开交互轨迹(OpenCUA)里自动挖掘面向视觉智能体的紧凑多模态包。一个把工件优化得可审计、可纠正;另一个把工件优化得能在活的 GUI 或游戏画面里识别状态。
关键数字
| 维度 | COLLEAGUE.SKILL | MMSkills | 数字到底量了什么 |
|---|---|---|---|
| 包的内容 | 双轨:能力轨(实践、心智模型、启发式)+ 有界行为轨(风格、规则、纠正历史) | 三部分:文本流程 + 运行时状态卡 + 多视角关键帧 | 设计选择,不是分数 |
| 内容来源 | 单人的工作痕迹,端到端蒸馏 | OpenCUA 的 4,205 条 Ubuntu + 3,157 条 macOS 轨迹,自动挖掘 | 生产方式 |
| 库规模 | 画廊收录 165 位贡献者的 215 个技能 | OSWorld 247 个包、macOSWorld 248 个、VAB-Minecraft 24 个、超级马里奥 10 个 | 生态规模 vs 基准覆盖 |
| 采用信号 | GitHub 约 18.5k star,listed 技能卡累计超 100k star | 未报告 | 社区热度,不是质量指标 |
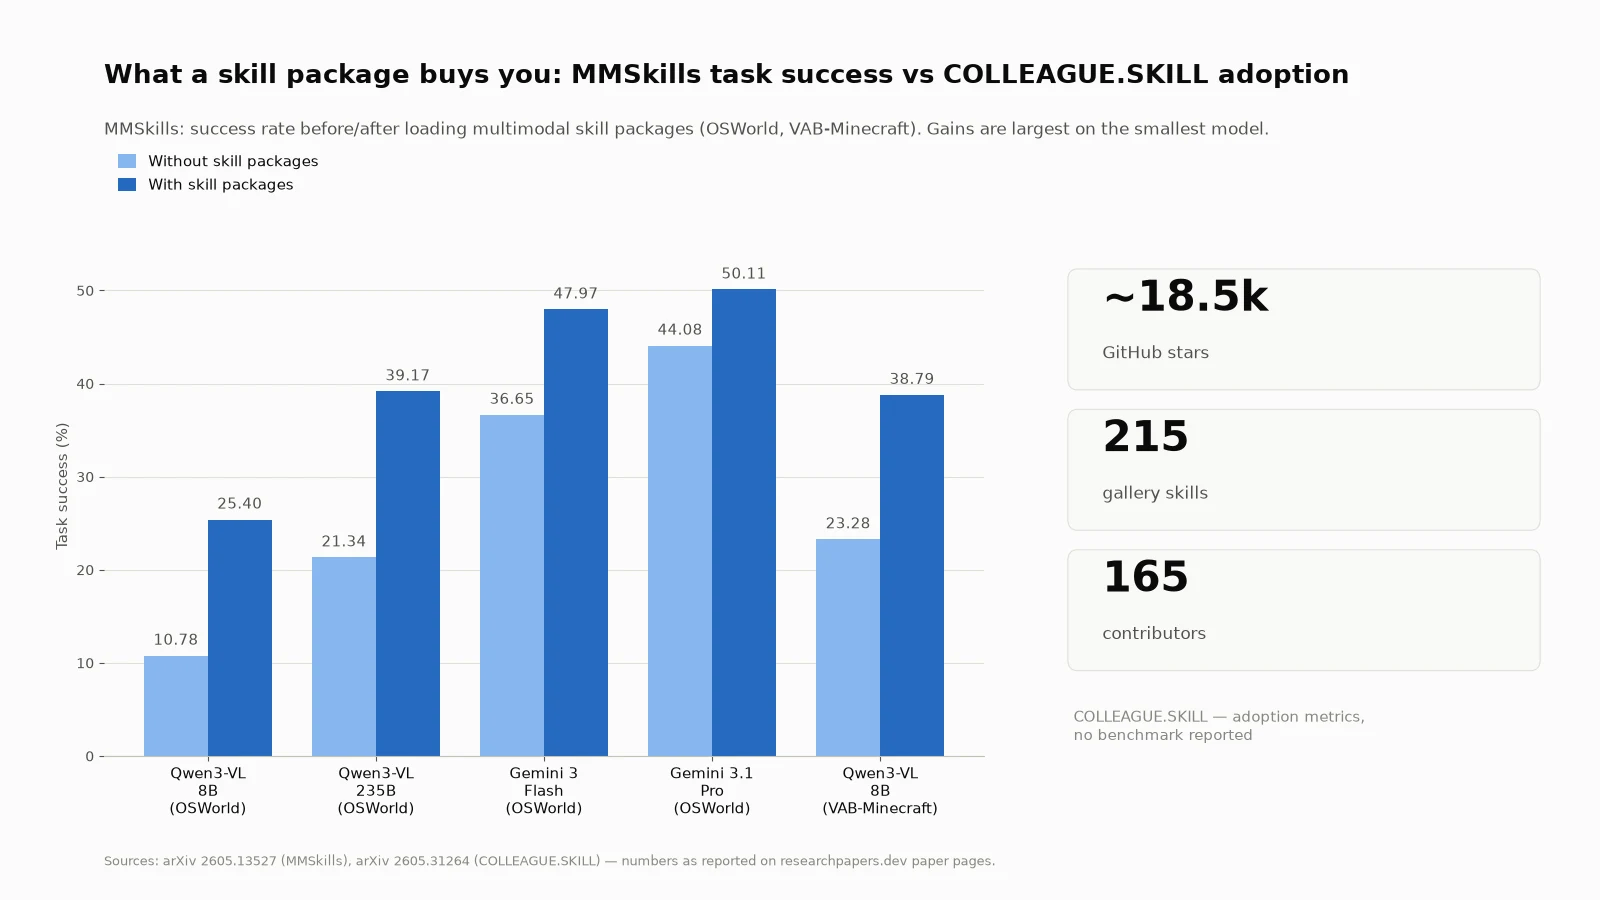
| OSWorld(Qwen3-VL-235B) | 未评测 | 21.34% → 39.17% | 同一基准的任务成功率 |
| OSWorld(Qwen3-VL-8B-Instruct) | 未评测 | 10.78% → 25.40% | 小模型成功率翻倍以上 |
| OSWorld(Gemini 3.1 Pro) | 未评测 | 44.08% → 50.11% | 前沿模型上的增量 |
| OSWorld(Gemini 3 Flash) | 未评测 | 36.65% → 47.97% | 快速档模型上的增量 |
| VAB-Minecraft(8B) | 未评测 | 23.28% → 38.79% | 从 GUI 迁移到游戏环境 |
| 保真度研究 | 无(没有任务成功率或真人对照实验) | 无(没有技能作者的真人保真度测量) | 两篇都留的空 |
逐列读这张表,不对称本身就是故事:COLLEAGUE.SKILL 的每个数字都是采用或设计数字(star、贡献者、画廊规模、回滚能力);MMSkills 的每个数字都是基准增量(OSWorld、macOSWorld、VAB-Minecraft、超级马里奥上的任务成功率)。两篇论文互不测量对方量的东西:COLLEAGUE.SKILL 说不出蒸馏出的技能能不能让智能体把任务做得更好;MMSkills 说不出挖出来的包是否忠实编码了人类会称之为「经验」的东西。
包里装什么
COLLEAGUE.SKILL 的双轨设计把「这个人会什么」和「这个人怎么做」拆开。能力轨装可迁移的 know-how:启发式、决策背后的心智模型、标准实践。有界行为轨装交互层(语气、这个人守住的规则)外加一份持续积累的纠正日志。「有界」是刻意的:行为被约束在显式、可审计的边界内,而不是凭感觉自由发挥;整个包像代码一样可读、可 diff、可回滚。
MMSkills 针对的是另一种失败。对视觉智能体来说,流程里难的往往不是动作,而是读屏:判断当前处在哪个状态、上一步到底成没成。文本流程写不出「文件选择器长这样」或「这个徽章变绿才算完成」。所以每个 MMSkills 包捆三部分:带前置条件的有序文本计划;描述智能体将经过的运行时状态的「状态卡」;以及锚定在这些状态上的多视角关键帧截图(进度、成功或失败的视觉证据)。加载方式是分支式的:智能体只检索并加载与当前状态相关的那一个包分支,于是每一步都能参考视觉证据,又不必为整个库付出上下文窗口的代价。
包怎么被生产出来
COLLEAGUE.SKILL 是一条带生命周期的「痕迹到技能」蒸馏管线:原始专家材料进,结构化、可审查的包出;之后主人用自然语言反馈更新它(「你太啰嗦,简洁点」),改坏了就回滚,同一个包可以装到不同的智能体宿主上,常见岗位还有领域预设。它的设计赌注是:值钱的单元是可纠正的工件,而不是冻住的提示词。
MMSkills 则全程自动:OpenCUA 的 4,205 条 Ubuntu 和 3,157 条 macOS 轨迹被挖成 247 个覆盖 OSWorld 360 个测试用例的包、248 个覆盖 macOSWorld 143 个用例的包,另有 VAB-Minecraft 24 个、超级马里奥 10 个。没有人手写任何一条流程。自动化的代价是继承:OpenCUA 里没有先例的任务就得不到包,库的覆盖很不均,OSWorld 有 247 个包而超级马里奥只有 10 个,所以游戏那一行的结果要带着保留地看。
诚实地读 MMSkills 的数字
结果内部的规律比任何单行数字都重要。最大的增益出现在最小的模型上:Qwen3-VL-8B-Instruct 在 OSWorld 上从 10.78% 翻倍到 25.40%,在 VAB-Minecraft 上从 23.28% 跳到 38.79%;235B 模型涨 17.8 分;前沿模型相对涨得最少,Gemini 3.1 Pro 从 44.08% 到 50.11%,约 6 分。直接的解读是:技能包借给小模型的是它们自己不具备的程序性能力,而前沿模型多半已经把这部分知识装在内部了。这正好对上成本敏感的 GUI 自动化的经济学,那里本来就是要部署小模型。它也帮你设定期望:如果底座已经是前沿档,同一个库买到的是个位数到低十几分的提升,不是翻倍。
诚实地读 COLLEAGUE.SKILL 的数字
头条数字(GitHub 约 18.5k star、165 位贡献者的 215 个画廊技能、listed 技能卡累计超 100k star)是真实世界的采用信号,而且相当强。但它们不是质量测量。论文没有给出任何基准、真人对照实验或任务成功率对比,所以「蒸馏出的技能能复现专家判断」这个核心主张,是靠一个能跑的系统加社区热度证明的,而不是靠测出来的保真度。两个更硬的问题悬而未决:蒸馏真人的痕迹带来肖像与授权问题,「受控分发」只是一笔带过;而有界行为的安全性,取决于写边界的人记得把什么写进去。
怎么选
- 瓶颈是视觉智能体读屏(GUI 自动化、游戏):用 MMSkills 式多模态包。纯文本流程编码不了状态识别,而 OSWorld 的增量说明这个格式值钱。
- 资产是某个具体人的专业经验(资深操作员、专家的判断力):用 COLLEAGUE.SKILL 式双轨包,因为你更需要纠正生命周期和回滚,而不是基准分数。
- 要规模化建库:像 MMSkills 一样挖轨迹;按人蒸馏扩不到几百个任务。
- 需要可审计的行为边界:选双轨拆分,有界行为是一条显式、可审查、带纠正历史的轨。
- 需要「这个技能真的有效」的证明:两篇论文都给不全。MMSkills 量了任务成功率但没说保真,COLLEAGUE.SKILL 给了保真度的设计却没测量。无论走哪条路,都要给自己留评测预算。
局限与存疑
这个对比缺的实验是:同一套包格式,既测任务成功率、又测作者保真度,从人蒸馏的包上基准测一测,或把挖出来的包拿去和真人判断对照审一审。在那之前,「多模态包提升任务成功率」和「蒸馏包承载人的经验」是两个由两篇不同论文分别支撑的独立主张。MMSkills 内部还有一个安静的依赖:分支加载只有在检索选对包分支时才有帮助,选错了分支会主动误导智能体,这个部件从头条数字里是审不出来的。两篇的适用范围也都收得很窄:MMSkills 只在 GUI 控制和游戏上评测,没碰开放式网页或物理任务;COLLEAGUE.SKILL 对真人蒸馏的授权问题,在法律和社会层面仍无定论。
常见问题
COLLEAGUE.SKILL 和 MMSkills 的核心区别是什么?
COLLEAGUE.SKILL 把一个人的工作痕迹蒸馏成带版本的双轨文本包:能力轨装实践和决策启发式,有界行为轨装风格、规则和纠正历史。MMSkills 从公开交互轨迹挖出多模态包(文本流程、运行时状态卡和关键帧截图),供视觉智能体按需加载。一个关心如何捕捉一个人怎么工作,另一个关心如何帮智能体读懂屏幕。
MMSkills 能把 OSWorld 提高多少?
OSWorld 上,Qwen3-VL-235B 从 21.34% 提到 39.17%,Qwen3-VL-8B-Instruct 从 10.78% 提到 25.40%,Gemini 3.1 Pro 从 44.08% 提到 50.11%,Gemini 3 Flash 从 36.65% 提到 47.97%。同一套包还把 8B 在 VAB-Minecraft 上从 23.28% 拉到 38.79%。
COLLEAGUE.SKILL 有基准测试结果吗?
没有。论文报告的是采用度数字,GitHub 约 18.5k star、165 位贡献者的 215 个画廊技能、listed 技能卡累计超 100k star,但没有任何基准或真人对照实验,测量蒸馏出的技能能在多大程度上复现专家的判断。
MMSkills 的包从哪来?
全部自动挖掘自公开交互轨迹:OpenCUA 的 4,205 条 Ubuntu 和 3,157 条 macOS 轨迹,产出 OSWorld 247 个包、macOSWorld 248 个、VAB-Minecraft 24 个、超级马里奥 10 个。
多模态技能包只对小模型有用吗?
不是,但对小模型帮助最大。Qwen3-VL-8B-Instruct 的 OSWorld 成功率翻倍以上,而 Gemini 3.1 Pro 只涨约 6 分,这说明前沿模型内部已经带着大部分程序性知识,技能包把最多的能力借给了最小的智能体。