
Role-Agent 与 Skill1 对比:agent RL 怎么靠自产信号变强
两家用 GRPO 系 RL 在 ALFWorld、WebShop 训 Qwen2.5 agent,胜同一 GiGPO 基线。Role-Agent 自产奖励与课程;Skill1 共演化技能库。
快速答案
Role-Agent和 Skill1回答的是同一个问题:RL 训练的 LLM agent,在没有外部奖励模型、没有手写模拟器的情况下,怎么持续变强?两者的答案方向相反。Role-Agent 向内求:同一个模型轮流扮演智能体和环境,给自己发”预测奖励”,还从失败轨迹里自动安排课程。Skill1 向外求:一个 GRPO 策略统一学会检索技能、使用技能、提炼新技能,全部挂在同一个任务结果奖励上。
在两家都报告的设定下,Skill1 的 7B 数字更强:ALFWorld 平均成功率 97.5%,Role-Agent 是 93.8%,而两篇论文测同一个 GiGPO 基线都是 90.8%。这个正面对比有前提,下面会讲清楚。两种方法也不互斥:Role-Agent 的调制层完全可以架在 Skill1 式策略之上。
核心设计差异
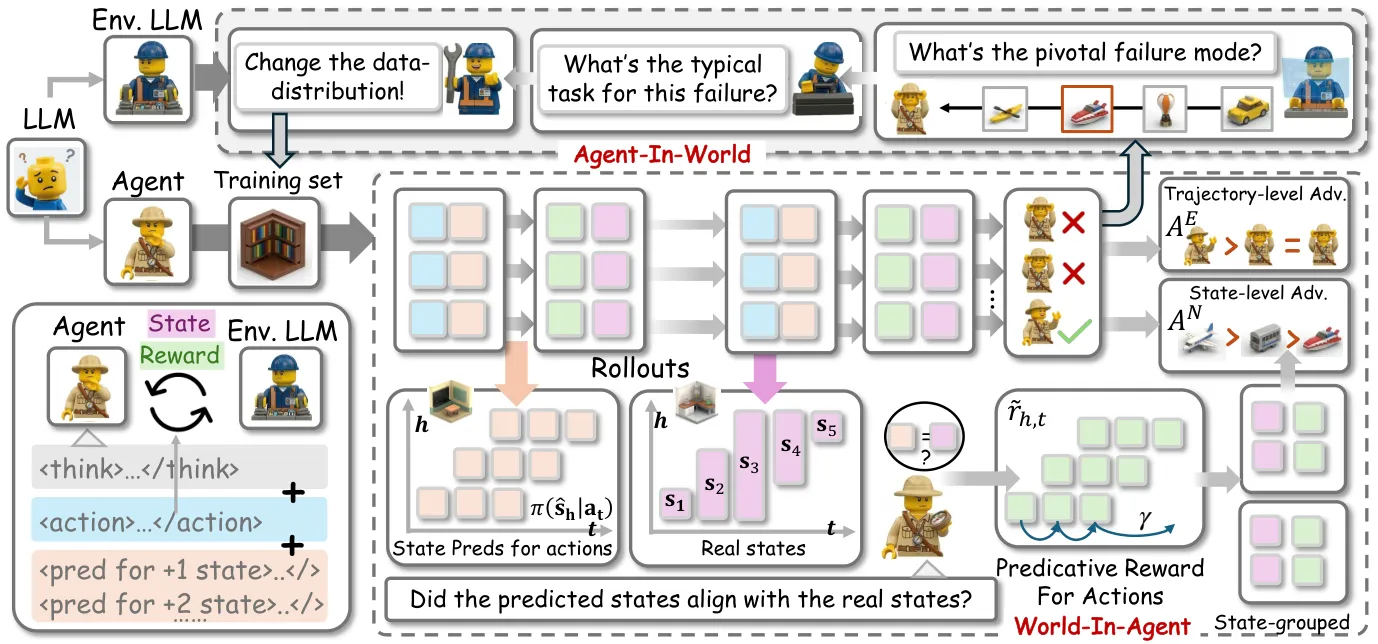
Role-Agent 分两半:World-In-Agent(WIA)和 Agent-In-World(AIW),同一个 LLM 戴两顶帽子。当智能体时,它在每个动作之后预测接下来 H 步的环境状态,用最长匹配子序列给预测打分,变成预测奖励去乘任务奖励。当环境时,它读自己的失败轨迹,用文字写下失败模式,再检索同类任务加练。除了策略本身,不训练任何新东西。
Skill1 把三件事折进一个策略:技能选择、技能使用、技能提炼,用 GRPO 统一训练。每局结束后策略可以把新技能写进上限 5000 条的技能库;指数滑动平均(速率 0.05)跟踪每条技能是否真的带来成功,没用的就被剪掉。两个辅助损失各带 0.3 权重,分别约束选择与提炼。
优化器都是借来的,不是新发明。Role-Agent 架在 GiGPO 上;Skill1 用普通 GRPO,组大小 16,学习率 1e-6。两篇的贡献都在信用分配:训练信号从哪来,又怎么传到系统里真正需要它的位置。
关键数字
| 指标 | Role-Agent | Skill1 | 设定与出处 |
|---|---|---|---|
| ALFWorld 平均成功率,Qwen2.5-1.5B-Instruct | 90.9%,GiGPO 86.7%(+4.2) | 未跑 | Role-Agent 论文 |
| ALFWorld 难子任务,1.5B | Pick2 +13.6%,Look +11.0% | 未跑 | Role-Agent 论文 |
| WebShop,1.5B | 71.9%,GiGPO 65.0%(+6.9) | 未跑 | Role-Agent 论文 |
| 搜索增强 QA,Qwen2.5-3B-Instruct | 45.8%,GiGPO 42.1%;2WikiMultiHopQA +8.2,MuSiQue +5.2 | 未跑 | Role-Agent 论文,NQ/HotpotQA 训练 |
| ALFWorld 平均成功率,Qwen2.5-7B-Instruct | 93.8%,GiGPO 90.8% | 97.5%,GiGPO 90.8%(论文报 +6.5) | 两篇论文,同骨干家族 |
| WebShop,7B | 77.1% 成功率,GiGPO 72.8% | 89.7 得分,82.9% 成功率 | 指标口径不同;可比的是成功率那一对 |
| Skill1 分品类 ALFWorld,7B | 未报告 | Pick 100.0,Look 98.6,Heat 99.2,Clean 97.3,Cool 96.1,Pick2 96.0 | Skill1 论文 |
| 消融 | 去 AIW:WebShop −5.0,ALFWorld −3.4;去预测奖励:−3.6,−2.9 | 去技能库:97.5 → 80.9(−16.6);去选择:−5.7;去提炼:−5.1 | 各自论文的消融 |
| 内部信号细节 | 预测奖励与结果奖励相关 0.41(p < 0.01);预测对齐度从初始 0.60 升到收敛时 0.70 段;最佳预测跨度约 max 步数的 5%,10% 反而掉 | 技能效用 EMA 速率 0.05;辅助损失权重各 0.3;技能库上限 5000 | 各自论文 |
| 训练成本 | WIA 与 AIW 在基线生成之上额外增加逐步运行时间 | 100 到 150 步,8 张 H800 约 30 小时 | 各自论文 |
两行需要细读。第一,ALFWorld 7B 那一行是真正的跨论文锚点:两篇论文都报 GiGPO 在 Qwen2.5-7B 上是 90.8%,所以相对同一基线的提升,Role-Agent 是 +3.0 点,Skill1 论文报 +6.5。但基线是各自跑的,这是论文间的数字一致,不是同一个 harness。第二,WebShop 那行混了口径:Skill1 的 89.7 是得分,82.9% 和 Role-Agent 的 77.1% 才是成功率。拿 89.7 直接比 77.1 是错的。
两家为什么都能赢同一个基线
GiGPO 是 2026 年 LLM agent 的标准组相对 RL 基线,由 GRPO 改造到智能体场景。能赢它,是新 agentic RL 方法的入场券。两家赢的方式都是从纯结果奖励丢弃的信息里捡回信号。
Role-Agent 的逻辑是:模型知道的比奖励记录的多。能预测自己动作后果的智能体,对动态的理解更好,信用就该加权。预测奖励和真实结果的相关只有 0.41,看着太弱,但它是乘在任务奖励上,而不是替代任务奖励,足以抬高可预见动作的信用、压低靠运气的动作。
Skill1 的逻辑是:经验本身就是信号。一个任务解决过一次就不该从零重学,而 GiGPO 每局都清零。把一个结果奖励同时穿过选择、使用、提炼三个环节,技能库才会复利。技能库消融是本页最大的单一数字:拿掉技能库,ALFWorld 从 97.5% 掉到 80.9%,损失 16.6 点,超过两篇论文里任何其他消融。
两篇都不是新 RL 优化器的证据,而是在组相对更新之上做更好的信用分配。离开”结构化基准 + 可检查成功信号”这个舒适区,提升是否还在,两篇都没有答案。
怎么选
选 Role-Agent 的条件:任务奖励稀疏,没有稠密模拟器反馈;基座模型较小(论文覆盖 1.5B 到 7B);已经在跑 GiGPO 或 GRPO 循环,想要一个便宜插件,不需要额外标注、不训练额外模型,但要接受 WIA 和 AIW 带来的逐步运行时间。
选 Skill1 的条件:任务成族出现、结构重复;结果奖励可检查;失败的和成功的回合应该沉淀成可复用的东西。训练成本约 30 小时 8 卡、100 到 150 步收敛,在 agentic RL 里算温和,代价是系统复杂度:一个嵌入编码器、一套 EMA 效用跟踪、一条剪枝规则。
几个组合与反例。如果你有稠密奖励或干净的模拟器,Role-Agent 的预测半边收益很小,论文作者自己也建议只留失败检索课程。如果任务从不重复,Skill1 的库没有可复利的对象。如果基座是前沿规模,两篇都没有证据:Role-Agent 的提升从 1.5B 到 7B 在收窄,Skill1 只在 7B 测过。相邻工作指向同一方向:Ctx2Skill用自 Play 从上下文里提炼技能,无人工标注无外部奖励;OpenSkill从开放网络上构建技能及其验证器。
局限与存疑
两篇的评测都绑定 Qwen2.5、止步 7B,且都依赖成功可检查的结构化环境:ALFWorld 的家庭模拟器、WebShop 的脚本化网店。Role-Agent 加了搜索 QA 第三个任务族,Skill1 没有。代码、真实 API 工具调用、长程真实任务,两篇都没测。
Role-Agent 的存疑在内部信号。失败模式提炼依赖同一个 LLM 正确说出自己为什么失败,论文给了案例研究,却没有量化这个”说法”有多准。逐步运行时间有报告,但没换算成每点提升的成本,和”直接多跑 rollout”的交换比不清楚。arXiv 版本标注为进行中的工作。
Skill1 的存疑在技能库。5000 条上限和 EMA 剪枝是工程选择,没有分析库饱和或技能冲突时会发生什么。单一 7B 骨干让规模问题双向开放:更强的基座可能追平更简单的基线,也可能让技能库在更大规模上更重要。最后,两篇都假设结果奖励可检查,而大多数真实任务并不满足。
常见问题
两篇论文的结果谁的 ALFWorld 数字更好?
Skill1,且是两家重叠的唯一设定。Qwen2.5-7B 上,Skill1 报 97.5% 平均成功率,Role-Agent 是 93.8%,两家测的 GiGPO 基线都是 90.8%。Skill1 还给了分品类数字,从 96.0% 到 100.0%。这说明技能库在结构化基准上复利良好,不是普适排名。
为什么两篇都拿 GiGPO 当基线?
GiGPO 是 LLM agent 组相对 RL 的标准基线,从 GRPO 适配到智能体场景。2026 年任何新的 agentic RL 方法要入场,赢它是必要条件,这也正是 90.8% 同时出现在两篇论文里的原因:它是让跨论文对比成为可能的共享参照点。
Role-Agent 的预测奖励能和 Skill1 式技能库合起来用吗?
两篇论文都没有排除这个组合,两套机制碰的是循环的不同位置。预测奖励调节的是一局内部的信用;技能库储存的是跨局的经验。一个既检索技能、又按预测打分给自己加成的策略,是合理的第三种系统,但目前没有任何公开数字。
各自方法的主要局限是什么?
Role-Agent 只在 Qwen2.5 的 1.5B 到 7B 上验证,平均提升约 4%,且随基座变强而收窄;它自报失败分析没有准确度测量。Skill1 只在单一 7B 模型、两个结构化基准上验证,技能库的管理规则没有原理支撑,更大规模未经验证。
基座模型变大之后,提升还在吗?
未知,而且唯一的数据点指向不好的方向。Role-Agent 的提升从 1.5B 的约 4.2 点收窄到 7B 的约 3.0 点,符合”更强的基座已经内化了预测信号的一部分”这个解释。Skill1 两个方向都没有更大模型的结果。