
SDPG vs SDAR vs AntiSD:特权教师信号该怎么花
RLVR 一轨迹一比特。SDPG 在判对轨迹上照搬提示教师,SDAR 逐 token 门控照搬,AntiSD 奖励分歧而非照搬:同一特权教师信号的三种花法。
特权教师技巧
可验证奖励强化学习有个著名的带宽问题:一条长思维链最后只拿到一个标量,这个标量还得回摊到几百个 token 上。为什么带裁剪的组相对基线(见 GRPO vs PPO)还是成了默认方案,那是另一页的故事。本页三篇论文用同样的原料攻同一个瓶颈:同一套模型跑两次,其中一次带上部署时永远拿不到的额外上下文。
把可部署的策略叫学生,把带额外上下文的副本叫教师。教师从来不是更大的模型,而是条件于训练时合法、推理时不可得信息的学生自己:标准答案加一份参考解法、从历史经验检索到的技能、或者一段当作提示的部分解答。第二次前向在权重上几乎零成本,因为它复用学生自己的参数,这就是这一族方法在 2026 年的 RLVR 论文里反复出现的原因。
三篇论文的分歧在于拿到教师输出之后做什么:
- SDPG 照搬:在验证器已判对的轨迹上,把学生到教师的 KL 缩到最小,再用参考策略 KL 项防止照搬把策略压崩。
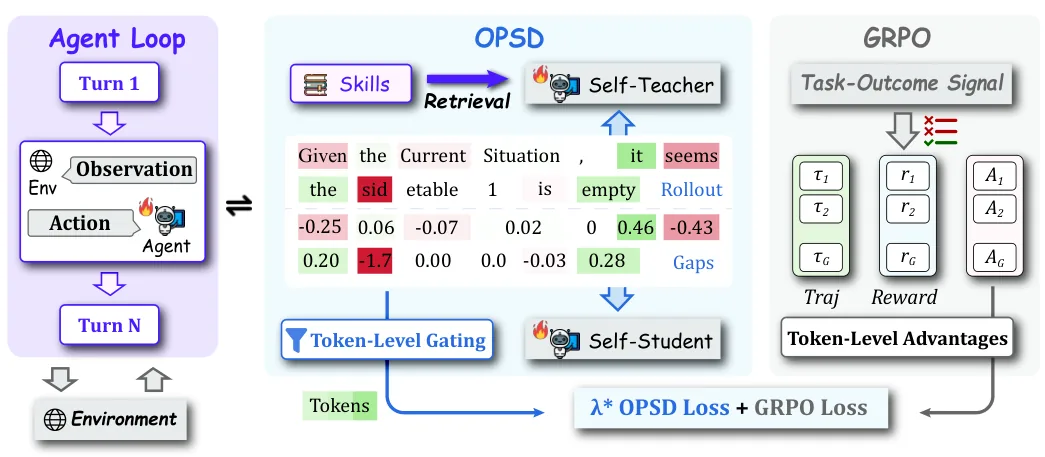
- SDAR 有选择地照搬:逐 token 过 sigmoid 门控,因为在多轮智能体场景里,教师在超过一半的 token 上其实不如学生。
- AntiSD 拒绝照搬:把教师与学生的分歧本身当作奖励,用下一 token 对特权上下文的逐点互信息来衡量。
连起来看,这是一条光谱:无条件照搬是失败的朴素基线;中间两篇是受控照搬,门控粒度不同;AntiSD 是端点,“照搬”被”挖掘分歧”彻底取代。DelTA、AntiSD 与 DVAO 对比那篇讲的是 AntiSD 的奖励塑造层;本页讲的是它与 SDPG、SDAR 共享的特权教师轴。
SDPG:照搬教师,但只在获胜轨迹上
SDPG(自蒸馏策略梯度)为数学 RLVR 设计,前提是每道训练题你都握有已验证的参考。特权上下文很直接:正确答案是 {answer},一种常见解法是:{solution},其中解法由 Gemini 2.5 Pro 生成。同一套 Qwen3-4B 权重既当学生(只看题)又当教师(题加提示),目标函数叠三项:分母稳定的组相对验证器优势、全词表在线蒸馏损失、以及一个系数 alpha = 1e-3 的参考策略 KL 惩罚。
两个开关让照搬活得下来。正优势门控只在验证器判对的轨迹上施加蒸馏损失,避免”很尖但不完美”的教师在全局错误的路径上强化局部看似合理的 token。beta 调度让蒸馏权重先升、再稳、训练末段衰减,让最终策略不再依赖测试时拿不到的信息。
数字,Qwen3-4B 训 400 步(pass@1,mean@32):AIME2025 末检查点 0.327,GRPO 类训练 0.242,自蒸馏基线 RLSD 0.300;AIME2024 0.380 对 0.280;AMC23 0.858 对 0.714。最有信息量的内部对照是 RLSD:同样从特权教师蒸馏,却没有刹车,约第 250 步熵崩塌。SDPG 的参考 KL 让 actor 熵全程保持高位;增益不属于”加自蒸馏”,而属于”加自蒸馏,然后别让它吃掉策略”。一个诚实的保留:论文没报教师第二次前向的时钟与 token 成本,且 AIME 最优与末检查点之差(0.408 对 0.380)暗示这个规模的训练仍有噪声。
SDAR:同一个技巧搬进多轮智能体,而教师经常是错的
SDAR(自蒸馏智能体强化学习)把特权教师思路从单轮数学搬到多轮智能体(ALFWorld 家务任务、多跳 Search-QA、WebShop 网购),用普通 GRPO 加一项辅助蒸馏损失训练。教师是同一个策略加上推理时看不到的检索技能,目标便宜且在线。
SDAR 存在的理由是一个该让所有做特权教师 RL 的人警觉的测量:由于技能检索不完美,超过 50% 的 token 上教师-学生的对数概率差是负的,即教师在多数位置上字面意义地比学生差。无门控照搬会在这些 token 上主动帮倒忙,论文的证据也证实了这一点。于是对概率差过 sigmoid 门:教师确实更好的地方放大蒸馏,其余地方软性衰减。即使检索换成随机噪声(纯噪声当技能),门控仍抠出 +1.9(ALFWorld)的小幅增益,这是”起作用的是门控而不是技能”最干净的证据。
结果,SDAR 相对自家 GRPO 基线:Qwen2.5-3B-Instruct 上 ALFWorld 75.0% 到 84.4%(+9.4)、Search-QA 36.4% 到 43.4%(+7.0)、WebShop 准确率 63.3% 到 68.0%;Qwen2.5-7B 上 WebShop 72.6% 到 82.8%(+10.2);单一最大跳幅是 Qwen3-1.7B 在 WebShop 的 +20.3,但那是从 38.3% 的弱基线上起跳。增益跨检索档位保持,这正是读这篇的正确方式:它是信任管理层,不是检索改进。它留下的开放问题是 SDPG 永远不必回答的:有真更大的模型可用时,同尺寸带门控的教师是否打得过直接蒸馏大模型。
AntiSD:停止照搬,把分歧变成奖励
AntiSD(反自蒸馏)从一个诊断出发:朴素特权教师照搬会卡死,是因为它在恰好错误的地方增强置信,换行、“Step”、等号这类结构性套话越来越尖,而模型真正在权衡选项的斟酌 token 却被压平。最小化师生分歧,等于把梯度花在从来不是瓶颈的 token 上。
于是 AntiSD 把符号反过来。它计算下一 token 对特权上下文的条件逐点互信息,并奖励这个分歧;advantage 用一个平滑 phi 函数塑形、负侧有界,斟酌 token 不会被过度惩罚。一个用 5 步 warmup 标定的熵门:教师熵跌破基线的 0.93 倍就关闭奖励,因为自信的教师已无分歧可挖,这让信号可以早期激进、晚期无害。
结果是样本效率声明:AntiSD 在 4B 到 30B 的五个模型上用 2 到 10 倍更少的训练步数追平 GRPO 的精度,终局最多高出 11.5 分。最强单点是 Qwen3-8B 在 HMMT 2025:约五分之一的步数到达 GRPO 峰值,终局高出约 15 分。与另外两篇一样,它的验证停留在特权上下文容易构造的地方(竞赛数学),而 0.93、warmup 长度这些常数读起来是调过的。
关键数字
| 测量项 | SDPG | SDAR | AntiSD | 设置与出处 | 同一套评测? |
|---|---|---|---|---|---|
| 主打结果(对 GRPO) | AIME25 末检查点 0.327 对 0.242(+0.085);AMC23 0.858 对 0.714(+0.144) | WebShop +10.2(7B:72.6 到 82.8);ALFWorld +9.4(3B:75.0 到 84.4) | 2 到 10 倍步数追平 GRPO;终局最多 +11.5;HMMT25 约 1/5 步数、约 +15(Qwen3-8B) | 各自论文表格 | 否 |
| 特权上下文 | 标准答案 + Gemini 2.5 Pro 解法 | 从历史经验检索的技能 | 题目 + 部分解答(提示) | 各论文 | 是(均为”训练多给、推理不给”) |
| 信号方向 | 最小化对教师的全词表前向 KL | 门控地最小化(按师生对数概率差的 sigmoid) | 最大化 PMI 分歧作为奖励 | 各论文 | 是 |
| 门控设计 | 轨迹级:仅正优势 + beta 退火 | token 级:sigmoid 门;负差 token 超 50% | 熵门:低于 0.93×warmup 基线即关 | 各论文 | 否 |
| 测试模型 | Qwen3-4B(附录 1.7B) | Qwen2.5-3B/7B、Qwen3-1.7B | 五个 4B 到 30B 模型,含 Qwen3-8B、Qwen3-30B-A3B、OLMo-3-7B 两个 | 各论文 | 否 |
| 领域 | 数学竞赛(AIME24/25、AMC23) | 智能体:ALFWorld、Search-QA、WebShop | 数学(AIME、HMMT、MinervaMath),代码抽查(HumanEval+/MBPP+) | 各论文 | 否 |
| 每步额外开销 | 第二次前向(未报墙钟) | 检索 + 第二次前向 | 特权上下文前向 | 各论文 | 是 |
| 防坍缩机制 | 参考 KL(alpha = 1e-3);无刹车的 RLSD 基线第 250 步坍缩 | 门控衰减多数 token | 熵门在教师自信后关闭信号 | 各论文 | 否 |
读这张表要读结构,不要当排名读:除设计行外没有任何一行在共享 harness 下测过;主打行捆了三个不同基准、三个模型家族、三种评测预算。真正可直接比较的是设计空间:三者都付一次额外前向,都必须移除或门控特权信号,只是门控粒度不同:轨迹级(SDPG)、token 级(SDAR)、时间级(AntiSD 的熵调度)。
局限与存疑
除了上面各篇的局限,整个方法族还有三条共同存疑。其一,证据全是作者自测且面窄:每个主打数字都来自论文自己的设置,三篇之间没有共享 harness,也都没有第三方头对头复现。其二,特权上下文是被假定而非被解释的:SDPG 要求每道题有已验证参考,SDAR 要求有值得检索的技能库,AntiSD 要求提示确实含有信息;构造不出来时,方法不是退化,而是根本不适用。其三,三篇都低估了训练账单:每步都要多付一次教师前向,只有 SDAR 另加检索开销,而只有 SDPG 的论文完全没报墙钟成本。把样本效率与精度增益当作”真实但有界”,采纳前在自己的任务分布上重跑对比。
怎么选
从特权上下文是什么出发。 手里有已验证参考(答案、解法、单测),SDPG 是最直接的匹配,它的三个控件(轨迹级门控、参考 KL、beta 退火)是任何特权教师方案的最低可行套件。它的数字也是三篇里最保守的:每个增益都对同预算同模型的 GRPO 而报。
任务是多轮的话,无条件照搬直接出局。 SDAR 那个”负差 token 超 50%“的测量是这里可迁移的结论:任何额外上下文靠检索而非验证得到的场景,都该预期教师在相当一部分 token 上更差,并相应加门。随机检索消融说明,哪怕上下文是噪声,门控也能抠出价值。
如果 rollout 成本占大头、领域又容易构造提示,AntiSD 的主张最强:2 到 10 倍提速是算力声明,不是榜单微调,但它也最”调过”:0.93 的熵阈值和 5 步 warmup 值得先做敏感性检查再谈迁移。
共同要预算的失效模式是向教师坍缩:SDPG 盯熵,SDAR 盯逐 token 信任,AntiSD 盯教师置信度。选一个与你特权信号最可能撒谎的位置匹配的护栏。如果你的任务构造不出便宜的特权上下文,这三个方法一个都不适用;那才是真正的入场费,不是那次额外前向。密集信号 RLVR 修法的更广谱系见 DelTA、AntiSD 与 DVAO 对比,蒸馏一侧的故事见 on-policy distillation 解读。
常见问题
SDPG、SDAR 和 AntiSD 需要一个更大的教师模型吗?
不需要,这正是这一族方法的要点。三篇里教师都是同一套权重加上额外上下文:答案加解法(SDPG)、检索技能(SDAR)、部分解答(AntiSD)。蒸馏目标是第二次前向,零额外参数。SDAR 留下的问题是:真有更大模型时,同尺寸带门控教师是否打得过直接蒸馏大模型。
哪个方法解决自蒸馏里的熵崩塌?
SDPG 最直接。它的 RLSD 基线(无刹车的特权教师蒸馏)约第 250 步坍缩;而 SDPG 的参考 KL(alpha = 1e-3)加衰减蒸馏权重让 actor 熵全程保持高位。AntiSD 从结构上绕开了问题:它从不照搬教师,自然没有可坍缩上去的教师;教师一旦自信,熵门就关掉 PMI 奖励。
SDPG、SDAR、AntiSD 哪个不需要已验证的训练答案?
基本都需要。SDPG 明确要求每道题有标准答案加参考解法。AntiSD 要求能构造部分解答,数学容易,别处很难。SDAR 要求最低(特权上下文是检索技能),但它的增益假设检索存在,且最好的结果仍来自精心整理的技能库。三者都是”已握有额外监督时的微调方法”,不是从裸验证器奖励里凭空变出监督的办法。
增益到底有多大?实话说。
SDPG:三个数学竞赛末检查点比 GRPO 高 0.085 到 0.144,内部 RLSD 基线夹在中间。SDAR:智能体基准比 GRPO 高 +4.7 到 +10.2,最大单值(+20.3 WebShop)从最弱基线上起跳。AntiSD:2 到 10 倍样本效率、终局最多 +11.5,而 +15 的 HMMT25 数字只在单个模型上。每个都是真实但有界的增益,由作者各自测于各自设置;尚无第三方头对头复现。
三个方法推理时各花多少?
部署时零成本,因为特权上下文在三个方法里都只存在于训练期。花的是训练时:每步多一次教师前向(SDPG、AntiSD),外加检索(SDAR)。只有 SDPG 没报第二次前向的墙钟价格,扩展之前请在自己的环境里先测。