
APPO、SDAR、SCOPE、LongTraceRL 方法对比
GRPO 给多轮智能体一回合一个标量奖励,四篇论文分别在分支、数据与奖励、蒸馏、自我博弈四层修信用分配,这是各自的数字。
四篇论文共同的起点
标准 RLVR 用 GRPO 训练:采样一组轨迹,给最终答案打分,组内归一化,更新。数学任务上这很好用,因为奖励是回答末尾一个可对答案。智能体不一样:它要搜索、点击、下单、重试,走上几十轮,环境到最后才吐出一个成功位。一个标量要解释几百个 token 级的决策,而 GRPO 把这一个数均匀地抹在整条轨迹上。
这四篇论文从同一个缺口出发,但改的是管线的不同环节。APPO 改的是 rollout 在哪里分支、奖励记到哪些 token 头上。LongTraceRL 改的是 模型练什么数据、奖励检查什么,面向长上下文。SDAR 改的是 训练信号的密度,用同一个模型的特权副本做蒸馏。SCOPE 改的是 训练数据和评委从哪来:最好哪都不来。
这个拆解就是理解 agentic RL 的心智模型。它不是一种技术,而是信用分配问题在四个不同层面的解法,而且这几个层面大多是正交的,常常能叠加而不是互斥。
APPO:在决策处分支,而不是在工具调用处分支
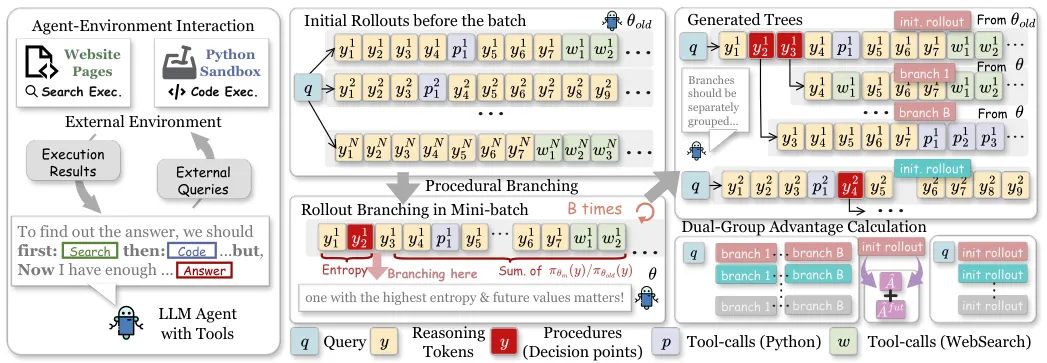
此前的 agentic RL 方法比如 ARPO,按启发式单元(通常是工具调用边界)分支 rollout。APPO 的图 1 分析指出这个锚点选错了:高熵 token 并不聚集在工具调用处,而且光看熵也不够,因为有些熵峰只是生僻词。APPO 给每个 token 打分的指标是两个 z 分数归一化信号的乘积:token 熵,加上一个折扣累积的重要性采样比率,用来估计这个 token 一变、后续轨迹会偏多少。只有既不确定、又有下游影响的 token 才值得分支。
训练循环按这个分数建树,后半段再重塑信用:初始 rollout 和分支续写分进不同的优势组,避免混用不同采样分布;再用同一个似然比构造的未来感知优势项乘进基础优势,让下游影响大的 token 分到更多奖励。
结果是配方级提升,不是基座模型能力跳跃。Qwen2.5-7B-Instruct 上 13 个基准的平均分从 58.3(ARPO)涨到 62.2,AIME24 从 30.0 到 36.7;Llama3.1-8B 上平均涨 2.1 分。深度搜索上,GAIA 在 Qwen3-8B 上从 38.8 到 42.7,Qwen3-14B 上从 43.7 到 46.6。消融告诉你价值在哪:去掉未来感知优势项掉 3.4 分,去掉双组分组掉 2.1 分,分支打分只用熵掉 1.8 分。
LongTraceRL:把干扰段落做难,再加一个刷不了分的 rubric
LongTraceRL 面向长上下文推理,一次修掉标准 RLVR 的两个软肋。一是干扰文档太简单:往上下文里塞随机段落,模型学到的是”忽略明显无关的文本”,而不是”在两个都像答案的段落里做区分”。二是只看结果的奖励会纵容跳步蒙对:最终答案对了,中间推理抄近道,RLVR 照样强化。
两个修复出自同一个来源:解多跳问题的搜索智能体的轨迹。智能体打开读过但没引用的文档是 Tier-1 干扰项,话题贴脸、实体重叠,足以骗过一个有能力的读者;搜索结果里没点开的是容易排除的 Tier-2。智能体一路链过去必须经手的实体,则构成过程奖励:模型回答里命中金实体的比例。关键在于 rubric 加分只在最终答案已经正确时才给。如果答错也给,模型就会往错误答案里狂喷金实体刷分;用正确性做门槛,这个作弊路径就被堵死了。
Qwen3-4B-Thinking-2507 上,五个基准的均分从 53.3 到 59.0。涨幅跟着瓶颈走:MRCR 从 36.2 到 45.8(+9.6),AA-LCR 从 33.2 到 41.8(+8.6),都是”针藏在以假乱真的干扰里”的检索重任务;FRAMES(+2.8)和 LongBench v2(+2.4)涨得少,因为基线本来就高。rubric 消融单独验证了它的贡献:只有困难干扰没有 rubric,只到 53.7,加上 rubric 到 59.0。规模上,Qwen3-30B-A3B 从 60.5 到 63.7,但 DeepSeek-R1-0528-Qwen3-8B 只涨 1.1,暗示这套配方是为 Qwen3-Thinking 家族调的。
SDAR:从和学生一样大的教师那里拿稠密信号
SDAR 直接攻击稀疏性。在 ALFWorld、Search-QA、WebShop 这类多轮任务上,GRPO 只在回合结束给一次梯度,于是它在 GRPO 上叠一个辅助的 on-policy 自蒸馏损失。教师不是更大的模型,而是同一个策略加上检索来的技能作为特权上下文,这些技能学生推理时看不到。因为师生只差上下文,蒸馏目标是廉价的、on-policy 的。
真正的工程贡献是逐 token 的 sigmoid 门控,用师生对数概率差做门。动机是实测出来的:多轮场景里超过一半的 token 教师反而更差,因为技能检索并不完美。不带门的蒸馏会把这些错误也复制过去;门让教师真正更强的 token 得到更多蒸馏,其余被柔化衰减。随机检索消融把话说得很干净:技能换成噪声,ALFWorld 仍涨 1.9 分,说明门是在抢救弱信号,而不是依赖强信号。
相对 GRPO 的提升在三个 Qwen 尺寸上都稳定。Qwen2.5-3B-Instruct:ALFWorld 从 75.0% 到 84.4%(+9.4),Search-QA 从 36.4% 到 43.4%(+7.0),WebShop 准确率从 63.3% 到 68.0%(+4.7)。Qwen2.5-7B-Instruct:WebShop 从 72.6% 到 82.8%(+10.2)。最大的单点数字 +20.3 属于 Qwen3-1.7B 的 WebShop,但那里的基线本来就只有 38.3%,诚实的读法是:方法在余地最大的地方帮得最多。
SCOPE:没有验证器也没有数据时的自我博弈
数学和代码撑得起自我博弈,因为答案能规则化地检查。深度研究、学术问答、规划、创意写作这类开放任务没有这样的裁判,以往的做法要么人工策展数据集,要么租用前沿模型当评委。SCOPE 两个都不要。同一个基座模型拆成三个角色:Challenger 围绕采样的文档出题,难度压在”难但能解”的区间;Solver 通过多轮检索作答;Judge 是训练起点模型的冻结快照,它对照从源文档里抽出来的 rubric 给 Solver 打分,而不是凭自己的参数化知识。Challenger 和 Solver 交替互相训练,一起进化。
冻结评委是刻意的约束。如果评委跟着 Solver 一起进化,双方可能在共同的捷径上串通;冻结让目标保持静止,代价是奖励上限不超过第零天模型的接地判断。
八个开放基准、三个基座模型平均,SCOPE 最多涨 10.4 分。Qwen2.5-7B 三轮迭代后从 24.4 到 34.8,超过用约 9K 条策展提示训练的 GRPO_data(33.4),而 SCOPE 一条策展数据都没用。Qwen3-8B 上 43.1 对 41.5。OLMo-3-7B 是例外:SCOPE 38.5,策展基线 39.0,所以”不需要策展数据”是平均意义成立,不是定律。最值得看重的是迁移:留出的一组短问答基准上最多涨 13.8 分,说明模型学到的是检索和接地,而不是把答案写得又长又合 rubric。
关键数字
| 方法 | 改的环节 | 对打基线 | 代表数字 | 设置 |
|---|---|---|---|---|
| APPO | 分支与信用落点 | ARPO | 13 基准均分 62.2 对 58.3(+3.9);AIME24 30.0 → 36.7 | Qwen2.5-7B-Instruct,同一 checkpoint 微调 |
| LongTraceRL | 数据难度 + 过程奖励 | 标准 padding 的 GRPO | 五基准均分 59.0 对 53.3(+5.7) | Qwen3-4B-Thinking-2507 |
| LongTraceRL | rubric 贡献(消融) | 无 rubric 的困难干扰 | 59.0 对 53.7 | 同模型同配比 |
| SDAR | 稠密辅助信号 | 纯 GRPO | WebShop 82.8% 对 72.6%(+10.2);ALFWorld +9.4 | Qwen2.5-7B / 3B |
| SDAR | 门控有效性 | 随机检索消融 | 技能为噪声时 ALFWorld 仍 +1.9 | Qwen2.5-3B |
| SCOPE | 无数据无评委训练 | 约 9K 策展提示的 GRPO_data | 34.8 对 33.4;43.1 对 41.5 | Qwen2.5-7B / Qwen3-8B,八个开放基准 |
| SCOPE | 策展数据反例 | OLMo-3-7B 上的 GRPO_data | 38.5 对 39.0,唯一落败的基座 | 同基准套件 |
这张表要连着”它没有的东西”一起读。没有任何两行共享同一个模型、同一套任务、同一套评测,所以各列说的是每个杠杆在各自匹配的基线上买到了什么,而不是谁赢。APPO 的 +3.9 和 LongTraceRL 的 +5.7 不能直接比大小,能比的只是”这个杠杆被证明了有效”这件事。
怎么选
- 已经在跑 agentic RL、想要最便宜的升级: 从 APPO 的分支打分开始。它是对工具调用边界分支的即插即用替代,消融显示未来感知优势项一家就值 3.4 分。
- 瓶颈是长上下文里真假难辨的段落: LongTraceRL。Tier-1 干扰加正样本门槛 rubric,正面打击”针藏在以假乱真材料里”的失败模式,而且恰好在这些地方涨得最多(MRCR +9.6)。
- 奖励稀疏、有检索设施、请不起更大的教师: SDAR。教师就是模型自己,推理时零改动,门控保证检索质量差也不 poison 训练。
- 没有验证器、没有策展数据、没有前沿评委的预算: 四个里只有 SCOPE 能内部同时造任务和造奖励。接受奖励上限,把它用在文档可接地的技能上,别指望开放式创意。
- 任务本来就有检查器(数学、代码、结构化抽取): 这些都不需要。带验证器的朴素 GRPO 更简单也更可能更强,SCOPE 作者自己也是这么说的。
局限与存疑
四篇论文没有一个实测过组合。APPO 的分支树、LongTraceRL 的困难数据和 rubric、SDAR 的门控,叠起来是很诱人的栈,但没有人叠过;奖励变稠密、信号也变稠密,恰恰是信用重复计算可能悄悄伤人的地方。算力账目普遍很薄:APPO 只说工具调用数”相当”,没有硬预算数字;SDAR 门控的逐步开销也没折算成吞吐。规模也大多没验证:SCOPE 止步 8B,SDAR 止步 7B,这些机制撞上 70B 智能体和真实产品轨迹时会怎样,是开放问题。
常见问题
什么是 agentic RL?
Agentic RL 是面向多轮行动(搜索、浏览、调用工具)模型的强化学习,区别于单回答生成。它的定义性难点是信用分配:环境每个回合只给一个结果信号,方法必须判断中间几百个 token 和步骤里哪些配得上这份奖励。GRPO 开箱即用地做不好这一点,因为它把同一个优势值均匀抹在整条轨迹上。
agentic RL 和 RLHF 有什么区别?
RLHF 是聊天模型对齐用的 PPO 或 DPO 循环,用学习出来的偏好奖励训练单轮回答。agentic RL 训练多轮轨迹,通常对可验证的结果(任务成功、答案正确)发奖励,研究前沿集中在信用分配:在决策处分支 rollout、加过程奖励、蒸馏逐 token 稠密信号,或者用自我博弈自己造数据。
哪个方法涨得最多?
对各自基线而言,SDAR 单点最大(Qwen3-1.7B 的 WebShop +20.3),但那个基线本来就弱(38.3%)。证据最均衡的是 APPO 相对 ARPO 的 13 基准 +3.9 和 LongTraceRL 的五基准 +5.7,而且都是在已经 RL 调过的模型上测的。跨论文比大小没有意义,因为没有共享评测。
这些方法需要更大的教师模型吗?
只有 SDAR 用教师,而且刻意用同一个模型加特权上下文,不需要任何外部或更大的模型。SCOPE 更进一步,用训练起点模型的冻结副本当评委。APPO 和 LongTraceRL 完全不用教师,一个改 rollout 结构,一个改数据和奖励设计。
这些方法能叠加吗?
论文里没有一处禁止,而且环节基本正交:APPO 改分支位置,LongTraceRL 改数据和奖励,SDAR 加辅助损失,SCOPE 换数据来源。但没有任何已发表结果真的叠过,奖励变稠密加信号变稠密的组合有重复记信用的风险,所以把叠加当研究方向,别当配方。
一句话:GRPO 给智能体一回合一个标量;APPO 决定决策在哪,LongTraceRL 把训练题做难、把奖励做密,SDAR 加一位带门控的同尺寸教师,SCOPE 干脆删掉数据和评委。完整数字和局限见各论文页。