
提升文生图:Z-Reward 与 InterleaveThinker 对比
一篇用分数分布替代标量奖励(9B 学生单 token 达 88.6% 偏好准确率),一篇用规划-批评智能体包裹冻结的生成器(UEval 18.2→66.3)。
两根杠杆,一个冻结的生成器
两篇论文的出发点相同:底模本身已经不再是预算最值得花的地方。重训 FLUX 级别的生成器太贵,问题就变成了:不动底模(或尽量少动),还能在哪些地方下功夫。
Z-Reward 动的是奖励这一端。它是一个文生图后训练用的奖励模型,不再输出一个标量分数,而是预测一份评分分布:在「图文对齐、真实感、美学、物理合理性」四个维度上,各给出一个 9 级半分制(1.0 到 5.0)的概率分布。训练用 GDSO(组内直接分数优化),蒸馏用 RISD(推理内化分数蒸馏)。它本身不生成图,而是嵌进 RL 或偏好优化循环里,当生成器的「教练」。
InterleaveThinker 动的是推理这一端。它面向交错图文生成,也就是教程、视觉故事、分步流程这类需要一连串互相一致的图片的场景。系统不训练生成器,而是在冻结的生成器外面套一个「规划器 + 批评器」的智能体回路:规划器在一张图都还没生成之前,先把整条图文指令序列写好;批评器在每张图生成后检查成败,失败了就改写提示词重试。
区别在于失败的形态不同。奖励不行,后训练全盘皆输;缺了规划-批评,长序列的错误会一步步复利式放大。
Z-Reward:把评委的不确定性留下,把评委的成本砍掉
标量奖励的毛病是丢信息:两张图分别得 4.0 和 4.2,差距又小又噪,标量头却把它当成 2.0 对 4.5 那样的鸿沟来处理;标注者之间的分歧也被抹平了。Z-Reward 用分布来保留这些信息,不确定性直接编码在分布形状里,同时分布的期望仍然能给优化器一个平滑的标量。
教师模型的目标函数 GDSO 叠了三项信号:由分布期望算出的策略梯度项(把推理链接到可用的奖励上)、逐点交叉熵项(把每个分数桶钉在人类标注上)、以及成对项(强制两张图的预测分差等于标注分差)。最后一项保证了即使绝对校准漂移,排序仍然正确。
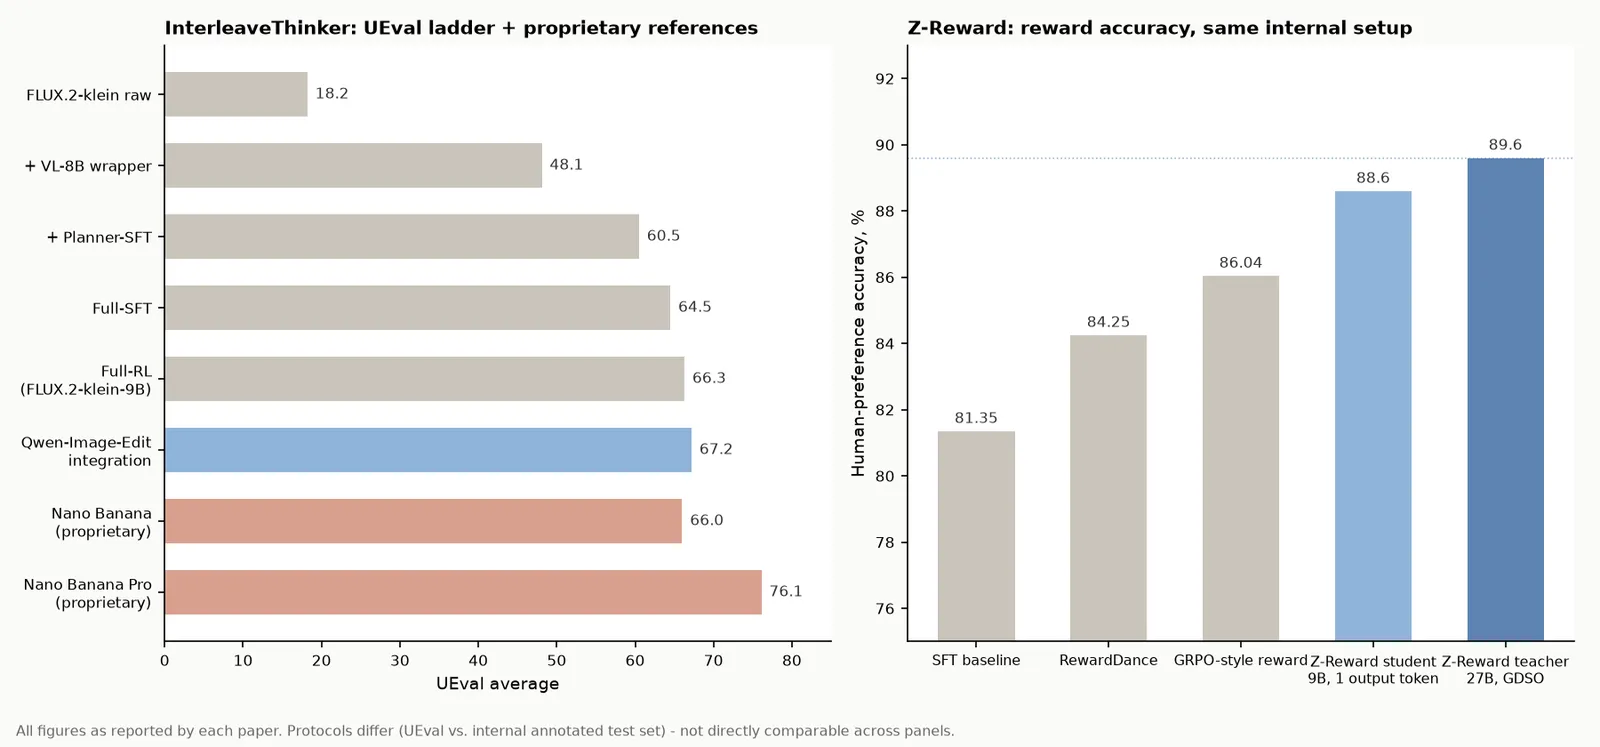
教师是一个 27B 视觉语言模型,在作者内部的标注测试集上做到 89.6% 人类偏好准确率(HPA),PLCC 0.7620、SRCC 0.7132。同一套设定下的基线:SFT 81.35%,RewardDance 84.25%,GRPO 式奖励 86.04%。也就是说,大约 3 到 8 个点的 HPA 提升来自分布式目标本身,而不是靠堆参数或堆数据。
真正可部署的是学生模型:RISD 用 KL 项去对齐教师「推理条件化后的分布」,而不是复刻推理文本,所以 9B 学生推理时只输出一个 token,就达到 88.6% HPA,只比 27B 教师低约 1 个点。对照实验最能说明问题:保留显式推理的在线蒸馏(OPD)要用约 750 个 token 换 83.11% 的准确率;价值活在分布里,不在推理链文本里。
下游方面,作者报告用这个奖励做后训练,相比 SFT 基线取得 41.3% 的净 GSB(好-同-差)人类偏好提升。这个数字要带护栏读:GSB 是人和人比出来的偏好分,比的是「没有奖励」的起点,而不是「用强标量奖励调过的生成器」;也没有 FID 或 GenEval 交叉验证。诚实的结论是「比没有奖励更好的优化目标」,剩下的证据在准确率那张表里。
InterleaveThinker:在冻结的生成器外面做规划与批评
InterleaveThinker 治的是另一种病:交错生成。一份教程或视觉故事要求一串图片前后一致,错误会跨步复利:第二幅图里物体画错,第五幅图就跟着歪。单次调用的生成器没有任何机制能发现这种事。
系统把两件事拆开。规划器在生成任何图片之前先写出完整的图片指令序列,刻意避免计划被早期的视觉错误带偏;批评器在每张图生成后检查、判断该步是否成功、失败则改写提示词。两者都从 Qwen3-VL-8B-Instruct 出发,训练数据分别是 Planner-SFT-80k、Critic-SFT-112k、Critic-RL-13k,RL 阶段用 GRPO,奖励一是「判断对错」的准确率,二是「让下一步变好」的步进奖励。训练约 50 小时、8 张 H800;推理时每步最多可以重试 5 轮。
消融阶梯是全文最硬的机制证据,完整 UEval 对照如下:
| 系统 | UEval 平均分 | 备注 |
|---|---|---|
| FLUX.2-klein 原始 | 18.2 | 消融,无外壳 |
| + Qwen3-VL-8B 包装 | 48.1 | 消融基线 |
| + Planner-SFT | 60.5 | 消融 |
| Full-SFT(规划+批评) | 64.5 | 消融 |
| Full-RL | 66.3 | FLUX.2-klein-9B |
| 单智能体变体 | 54.5 | 合并规划与批评 |
| Qwen-Image-Edit 接入 | 67.2 | 换底模 |
| Nano Banana(专有) | 66.0 | 论文报告参照 |
| Nano Banana Pro(专有) | 76.1 | 论文报告参照 |
阶梯(18.2 → 48.1 → 60.5 → 64.5 → 66.3)说明规划和批评是可分的两种能力:合并成单智能体的变体掉回 54.5。而天花板也很实在:Nano Banana Pro 的 76.1 比最优外壳配置高出约 10 个点。外壳把开源 9B 生成器托到了中等专有模型的水平,但离前沿还差一截。
序列级指标同样支持论文论点:WISE 从 0.47 提到 0.73;RISE 总分从 13.3 到 28.9,其中时序类目从 7.1 跳到 36.5;CoMM 两项任务的风格一致性 9.3/9.6、实体一致性 9.2/9.6。RISE 的时序跃升正是批评器存在的意义,它修的正是单图指标永远看不见的跨步漂移。
关键数字
| 指标 | Z-Reward | InterleaveThinker | 口径与出处 | 同口径? |
|---|---|---|---|---|
| 头号数字 | 9B 学生 88.6% HPA、单 token | FLUX.2-klein-9B 66.3 UEval | 各自论文的基准 | 否,任务不同 |
| 对最强基线 | 教师 89.6% vs GRPO 式 86.04% | 67.2 vs Nano Banana Pro 76.1 | 内部测试集 / UEval | 各自论文内同口径 |
| 最大消融差 | RISD 88.64%(1 token)vs OPD 83.11%(约 750 token) | 单智能体 54.5 vs 完整系统 66.3 | 同学生规模 / 同冻结底模 | 各自论文内同口径 |
| 下游效果 | 净 GSB +41.3%(对 SFT 基线) | WISE 0.47→0.73;RISE 时序 7.1→36.5 | 人评对比 / 序列指标 | 各自论文内 |
| 服务成本 | 每个分数 1 个输出 token | 每步最多 5 次生成调用 | 报告的设计 | 不适用 |
怎么选
两张表几乎完全互补。Z-Reward 假设你掌控训练循环、拿得出评分制标注;InterleaveThinker 假设模型冻结、你的问题是序列一致性而不是单图质量。成本结构也互补:Z-Reward 贵在训练端(27B 教师加两阶段蒸馏,还需要成规模的分布标注),但服务时学生只要一个 token;InterleaveThinker 把成本推到推理端(每步最多 5 次生成调用,外加规划和批评),适合一致性比延迟更值钱的场景。
两者没有在同一设置下做过联合实验,所以「先拿分布式奖励后训练、再套规划-批评外壳」只是从两个机制推出的合理叠加,不是实测结论。
局限与存疑
两篇的头号数字都出自各自的内部设定。Z-Reward 的 HPA 和 GSB 来自内部标注集和自研四维评分表:既无公开偏好基准,也无 FID、CLIPScore、GenEval 交叉验证,GSB 的对手是没奖励的 SFT 基线而非强标量奖励。InterleaveThinker 的 UEval、WISE、RISE、CoMM 把人类的视觉预期压成了分数;真实用户会在意的版式品味、叙事节奏不在指标内,而且批评器的训练数据由 Gemini 2.5 Pro 打分构建,审美偏好部分继承自这个评委。
常见问题
不重训底模,这两个方法哪个能用?
InterleaveThinker 可以:它包裹冻结的生成器,把 FLUX.2-klein 的 UEval 从 18.2 提到 66.3。Z-Reward 单独做不到,因为它是奖励模型;但它的 9B 学生推理只出一个 token,训练好之后奖励这一端几乎免费。
为什么规划器和批评器要分成两个智能体?
消融给的最直接证据:合并成单智能体的变体从 66.3 掉到 54.5,而分阶段的 SFT 阶梯(单规划器 60.5、全量 SFT 64.5、全量 RL 66.3)显示每一级都在真实贡献增益。
Z-Reward 真的比标量奖励强吗?
在奖励准确率上、且只在作者的内部设定下:27B 教师 89.6% HPA,对比 GRPO 式标量奖励的 86.04% 和 RewardDance 的 84.25%,9B 学生 88.6%。在生成图质量上证据偏弱:41.3% 净 GSB 的对手是 SFT 基线,不是用强标量奖励调过的生成器。
InterleaveThinker 打得过专有模型吗?
打不过最强的。最优配置配 Qwen-Image-Edit 达 UEval 67.2,高于 Nano Banana 的 66.0,但明显低于 Nano Banana Pro 的 76.1。它的位置是「开源底模 + 智能体外壳 ≈ 中等专有系统」。
InterleaveThinker 在 UEval 之外的序列指标涨了多少?
WISE 从 0.47 提到 0.73,RISE 总分从 13.3 到 28.9,时序类目从 7.1 跳到 36.5;单图生成器无法自我纠正的跨步漂移,正是批评器回路修好的东西。
一句话:Z-Reward 让奖励变得值得优化,InterleaveThinker 让冻结的生成器值得包裹。瓶颈在训练信号还是序列一致性,决定了你该选谁。完整设定见 Z-Reward 原论文与 InterleaveThinker 原论文。