
智能体技能自学六法对比:SkillOpt 与 Ctx2Skill 怎么选
六篇 2026 年论文让智能体不重训就学会新技能:SkillOpt 把技能文档训出 +23.5 分,Ctx2Skill 自博弈挖技能,OpenSkill 零监督自学,附真实数字与选型。
一个问题,六份答案
现在的智能体系统几乎都有「技能」层:模型出厂时不会、但工作里反复用到的流程和领域知识。2026 年的开放问题是这些技能从哪来。六篇新论文给了六个不同的答案,除了一点之外几乎处处不同,而这一点是:模型本身通常都是冻结的。
分歧发生在其他地方。更新什么(一份技能文档、整个技能库,还是模型自己的 LoRA 权重)、学习信号从哪来(可打分的轨迹、自博弈、失败归因、开放网络)、以及整套做法的开销。SkillOpt 只把一份技能文档当作可训练对象,用优化训练模型的纪律去训练它;Ctx2Skill 在没有验证器时自己造反馈,靠自博弈挖技能;OpenSkill 更激进,假设任务零监督,从开放网络里学;LatentSkill 干脆离开提示词,把技能编译进权重;SkillAdaptor 从定位到的失败出发改技能库;SkillsVote 问的是治理问题:很多智能体往同一个库里写技能之后,怎么防止这个库把自己毒化。
下面这张表请当作六条各自的头号声明来读,而不是排行榜。每个数字都来自该论文自己的评测集,跨论文排名没有意义;能迁移的是机制和开销结构。
关键数字
| 方法 | 更新什么 | 头号结果 | 在哪测的 | 与其他方法同口径? |
|---|---|---|---|---|
| SkillOpt | 一份自然语言技能文档,有边界的增删改 | 平均 +23.5 分(GPT-5.5 直聊),52 个(模型×基准×外壳)格子全部最优或并列 | 6 个基准,如 SearchQA 77.7→87.3、SpreadsheetBench 41.8→80.7 | 否,自家套件 |
| Ctx2Skill | 从一份长上下文挖出的技能集 | GPT-4.1 解题率 11.1→16.5,GPT-5.1 21.2→25.8 | CL-bench:500 个上下文、1,899 个任务 | 否,自家基准 |
| OpenSkill | 技能加自写的虚拟测试 | SkillsBench 通过率 43.6%,比最强基线 +8.9,人类参照 44.5% | SkillsBench 11 个领域,Claude Opus 4.6 | 否,自家基准 |
| LatentSkill | 从技能文本编译出的 LoRA 适配器 | ALFWorld 见过集 +21.4 分(74.3% 对 52.9%),prefill token 省 64.1% | ALFWorld + Search-QA,Qwen3-8B | 否,自家基准 |
| SkillAdaptor | 可检索技能库的文本编辑 | WebShop 得分 +2.3、PinchBench +1.5、Claw-Eval +1.8 | 三个基准,冻结骨干 | 否,自家基准 |
| SkillsVote | 共享技能库的准入门禁生命周期 | Terminal-Bench 2.0 离线最高 +7.9 个百分点,SWE-Bench Pro 在线 +2.6 | GPT-5.2 编程智能体 | 否,自家基准 |
从 +2 到 +23 的跨度是基准的属性,不是方法的排名。SkillOpt 和 LatentSkill 在技能真正有用的任务套件上报告了大数字;SkillAdaptor 故意以低成本可靠性补丁自居,诚实地报了个位数。表里信息量最大的格子其实是 Ctx2Skill 的 +5 分,因为它带着绝对水平:即使是最好的辅助模型,CL-bench 也只解出 25.8%。
学习信号从哪来
决定其他一切的机制是反馈回路,六篇论文各自造了一个不一样的。
可打分的轨迹,当作训练数据对待。 SkillOpt 的赌注是:提示词修补一旦遵守优化纪律就会变得可靠。优化器模型读轨迹、对一份技能文档提有边界的修改;文本学习率(每步约 4 个单位的编辑预算)限制单步位移,留出选择集充当验证门,被拒编辑进入缓冲区防止重复提同一个坏主意。消融证明纪律有价值:去掉缓慢的跨轮元更新,SpreadsheetBench 掉 22.5 分(77.5 跌到 55.0);最终技能只要 1 到 4 次被接受的编辑,长度 379 到 1,995 token。前提也很硬:没有自动打分,这一切都不成立。
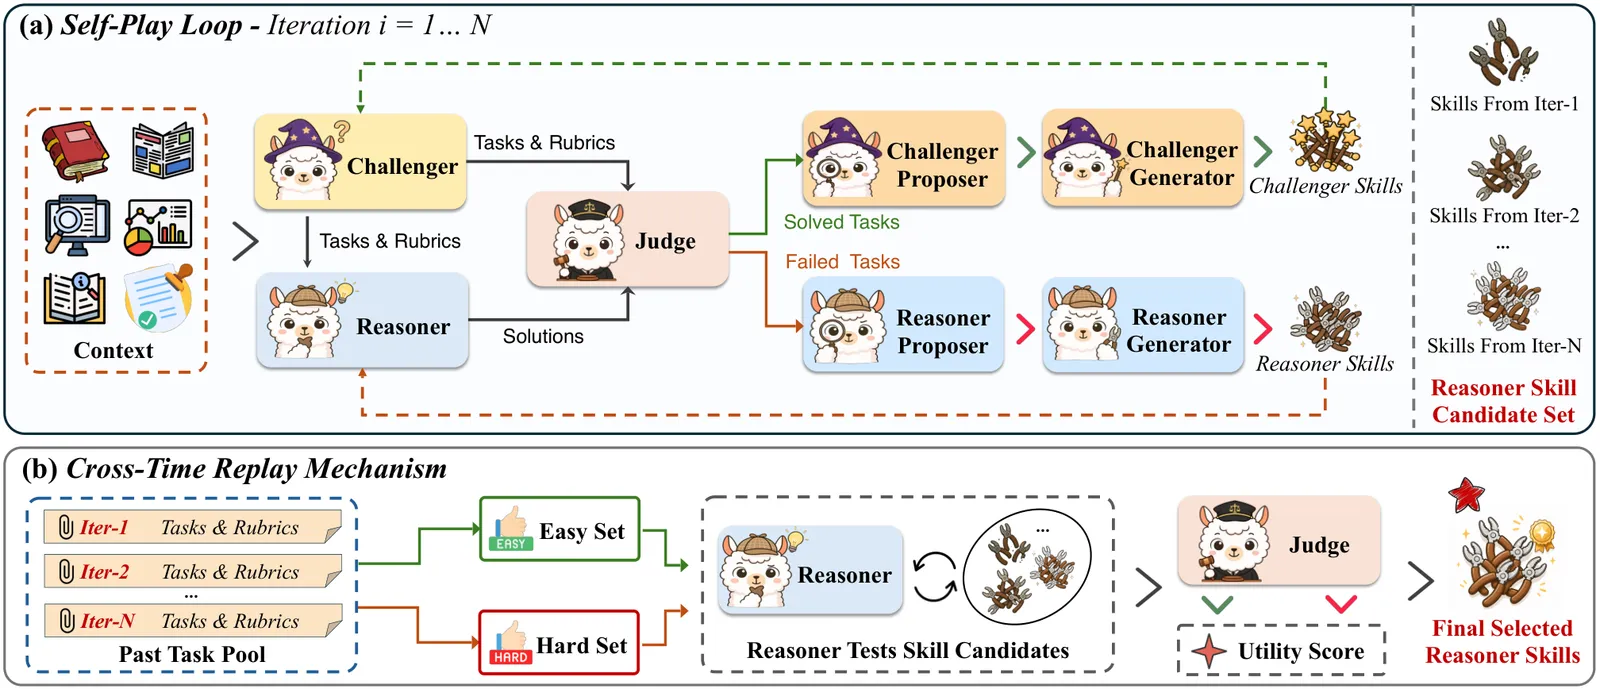
没有验证器时的自博弈。 Ctx2Skill 瞄准的正是 SkillOpt 碰不了的情形:一份没有标准答案的密集技术文档。Challenger 智能体从上下文出探测题,Reasoner 带着不断演化的技能集解题,Judge 只给二元对错;Proposer 和 Generator 把失败转成两侧各自的技能更新。纯对抗自博弈会崩,所以加了 Cross-time Replay:不回盲目保留最后一轮,而是在所有轮次里挑对易难案例都平衡的技能集。每个上下文跑 5 轮、每轮 5 题,挖出的技能对所有受测骨干都有提升,但绝对水平仍然低。
把开放网络当监督。 OpenSkill 假设最难的部署场景:没有答案、没有人工整理的技能、没有评分器。它的智能体分别检索任务知识和「验证锚点」(文档、仓库、论坛),然后用锚点自写虚拟测试,配合 gap 还是 bug 的分类器迭代技能。自建的验证器对隐藏真值达到 80.5% 召回、56.9% 精确率,也就是说它宁可错杀、多烧迭代,但错的方向更安全。在 SkillsBench 上这套零监督循环做到距人类参照 1 分之内(43.6% 对 44.5%),但在 SocialMaze 和 ScienceWorld 上优势缩到 1 到 2 分,所以开放网络的优势随任务而变,不是普适的。
步级失败归因。 SkillAdaptor 保持骨干冻结,在轨迹失败后追问:该怪哪个技能。Localizer 找到第一个可行动的出错步(最早一个换动作就能改变结局的位置),Linker 把责任摊到候选技能上,Modifier 改写或新建技能,资格门用新旧两套技能各重跑一次任务,性能不下降才接受编辑。这个门禁是防止技能库劣化的关键,代价是被接受的编辑大约翻倍执行开销。三个基准上的提升都是个位数,稳定为正,也稳定地小。
要治理,不要学习。 SkillsVote 几乎不插手技能怎么写,它管的是谁能活下来。框架先给百万级开放技能语料做画像,评估环境要求和可验证性;运行前推荐技能;运行后把轨迹拆成技能关联的子任务并做信用归因,只放行进真正有复用价值的发现。收益恰好出现在朴素写回伤害最大的地方:多个智能体长期共用的库,Terminal-Bench 2.0 离线最高 +7.9 个百分点,SWE-Bench Pro 在线更保守的 +2.6。
进权重。 LatentSkill 是异类:它论证塞满提示词的技能库其实是「伪装的参数」。一个在约 17.1 万份技能文档上预训练的超网络,一次前向就把任意技能文本编译成 LoRA 适配器,新增技能是一次推理而不是一次训练。编译后的技能在 ALFWorld 上省 64.1% 的 prefill token,同时在见过集上比提示词基线高 21.4 分;权重空间的组合也成立,但前提是先把技能拆成对齐的子成分再合并,直接加整个适配器会失败。
怎么选
诚实的答案是:这些方法处在一个权衡三角的不同顶点上——监督可不可得、能不能动权重、技能复用频次多高。
- 轨迹能自动打分,且同一类任务反复出现:选 SkillOpt。一份不到 2,000 token 的文本值 +23.5 分,是这个对比里最便宜的部署故事。
- 输入是一份又长又密的文档,没标注也没验证器:选 Ctx2Skill,它自己把缺失的反馈信号造出来。
- 智能体在真实环境里跑,面对的是没人评过分的任务:选 OpenSkill,接受检索开销和噪声自验证器。如果你能供给监督,就别付这个钱。
- 骨干是闭源 API 模型、失败留下可归因的中间信号、任务便宜:把 SkillAdaptor 当可靠性补丁用。允许微调且失败是稠密奖励的地方,别用它。
- 很多智能体共用同一个技能库、跑几个月:选 SkillsVote,没有准入门禁,共享记忆劣化的速度超过个体学习补偿的速度。
- 权重在你手里、技能是流程性的、提示词 token 是瓶颈:选 LatentSkill。知识检索类技能,朴素的 RAG 仍是更好的工具。
局限与存疑
三条警告对六个方法同时成立。第一,评测是自指的:每篇论文都在自己的套件上测,上表只能比机制,排不了名次。第二,绝对能力仍然薄。辅助后最好成绩 25.8%、自建评分器 56.9% 精确率、冻结骨干个位数提升,都在提醒:技能学习扩展的是模型能可靠做的事,替代不了训练。第三,成本核算口径不一:OpenSkill 付开放网络检索延迟,SkillAdaptor 为接受的编辑大致翻倍执行,SkillsVote 要给百万技能语料画像,Ctx2Skill 每份文档烧约 25 个智能体任务。没有一篇把摊销问题(复用多少次才值回挖掘成本)算完整。
悬而未决的研究问题也是共通的:挖出的技能能不能跨上下文迁移,还是每份文档都得重挖?自建的验证器和技能自身的盲区若相关,还能不能信?权重路线能不能走出单骨干、两基准——这是 LatentSkill 目前证据的全部范围。
常见问题
哪个智能体技能学习方法的报告提升最大?
SkillOpt 报告的平均提升最大:GPT-5.5 直聊跨六个基准 +23.5 分,Codex 外壳下 +24.8,Claude Code 外壳下 +19.1,52 个受测格子全部最优或并列。LatentSkill 在自家地盘接近这个数:ALFWorld 见过集 +21.4 分。这些数字跨论文不可比,因为各方法用了不同的基准套件和骨干。
这些方法能在 GPT-5.5 这类闭源模型上不做微调就跑吗?
可以,其中大多数就是为此设计的。SkillOpt、Ctx2Skill、OpenSkill、SkillAdaptor、SkillsVote 都保持模型权重冻结,把学习放到模型外的文本工件里。LatentSkill 是例外:它需要权重访问权限来挂载超网络生成的 LoRA 适配器,闭源 API 模型上跑不了。
什么时候该选 SkillOpt 而不是 Ctx2Skill 或 OpenSkill?
有自动打分信号(精确匹配、可执行检查、验证器)和留出集时选 SkillOpt,因为它的验证门和文本学习率都假设轨迹可打分。输入是没有标注的长文档时选 Ctx2Skill,它通过自博弈自造二元反馈。完全没有任务监督、智能体只能靠开放网络凑齐技能和评分信号时选 OpenSkill。
LatentSkill 和基于提示词的技能方法区别在哪?
LatentSkill 通过超网络把技能文本编译成 LoRA 适配器,技能住在权重里,运行时几乎不占上下文 token,ALFWorld 上省下 64.1% 的 prefill。提示词路线把技能当可检索文本,可移植、可检查,但每一步都要付 token。LatentSkill 的代价是需要权重访问,且目前的证据只覆盖单一骨干。
用这些智能体技能框架必须有验证器吗?
只有 SkillOpt 严格依赖可靠的打分函数,因为它的编辑接受机制建立在留出验证门上。Ctx2Skill 和 OpenSkill 正是为零验证器场景设计的:Ctx2Skill 用自博弈 Judge 给二元反馈,OpenSkill 用开放网络的验证锚点构造虚拟测试,对隐藏真值达到 80.5% 召回。SkillAdaptor 需要的是失败带有可观测的中间信号,不一定是形式化验证器;SkillsVote 需要的是能合成任务来验证技能。