Agent Harness 对比模型:为什么外壳能决定成败
三篇论文量化 agent harness:同一模型只换适配器,Pass@1 从 19.1% 到 73.4%;RHO 无标注优化 harness 到 0.78。
同一层东西,三篇论文
2026 年再问”agent harness 是什么”,最有用的答案是:模型没有写出来、却天天在用的那一整层,也就是指令、工具、技能、工作区契约、补丁提取、停止规则、运行预算。模型是固定的,harness 才是你真正交付和迭代的系统。三篇论文从三个方向打这一层,合在一起给出一个很难反驳的结论:harness 是和模型同量级的一等变量。
Code as Agent Harness 是地图:UIUC 牵头的综述,主张代码不是 agent 的产出物,而是它行动所依托的运行底座,并整理出三层分类。Claw-SWE-Bench 是测量:350 个任务的基准,把 harness 从模型身上剥离开,量化”只改 harness”能让分数动多少。RHO 是扳手:微软与香港城市大学的方法,只靠 agent 自己的历史轨迹、全程无标注地改进 harness。
关键数字
下表是三条互相独立的结论,不是排行榜;每行数字出自各自的实验设定,能迁移的是”该给 harness 单列预算”这个判断。
| 论文 | 它分离出什么 | 代表数字 | 证据基础 |
|---|---|---|---|
| Code as Agent Harness | 概念:harness 是可执行的底座 | 约 20 个代码推理系统 + 20 个代码行动系统入表;3 层、5 个应用领域、7 个开放问题 | 综述,无新基准 |
| Claw-SWE-Bench | 同任务下 harness 与模型各自贡献 | 同一个 GLM 5.1,仅换适配器,OpenClaw Pass@1 从 19.1% 到 73.4%;harness 选择波动 27.4 分,模型选择 29.4 分;Lite-80 花 22.9% 的成本,均分 0.643 对 0.639 | 350 个 GitHub issue 任务,8 种语言,43 个仓库 |
| RHO | 无标注条件下的 harness 改进 | 一轮优化 SWE-Bench Pro 0.59 到 0.78,无任何外部打分;同预算下胜过 Meta-Harness 的 0.62(103 对 41 次 agent 调用);去掉 self-consistency 掉到 0.56,比不改还差 | SWE-Bench Pro、Terminal-Bench 2、GAIA-2,固定 Codex |
最该停下来看一眼的是第一行:19.1% 到 73.4%,不是换模型、不是加长上下文、不是新提示词技巧,是同一个模型换了个适配器。如果你的评测管道只输出”每个模型一个数”,这个数背后藏的就是这种东西。
harness 到底是什么
综述的重构值得先消化,因为它解释了效应为什么这么大:别把 LLM 写的代码当成”生成物”,要把它当成 agent 推理、行动、协作所依托的运行底座。代码有三个天然优势:可执行,意图能跑出一个可以验证的结果;可检查,中间状态看得见,不锁在权重里;有状态,长任务有地方跨步保留工作记忆。综述把领域分成三层,这层划分本身就是实操清单:第一层是 harness 的接口(用于推理的代码、用于行动的代码、用于环境的代码);第二层是让它在长程任务里活下来的机制(规划、六类记忆、四族工具用法、Plan-Execute-Verify 控制环);第三层是扩展,多个 agent 围绕共享代码库协作,代码本身成为同步介质。
实践中真正值钱的一个区分,是”agent 自己写出来的代码产物”和”系统提供给它的基础设施”之间的界线,而大部分调试会话把这个搞混,把 hours 花在了错的那半边上。Claw-SWE-Bench 和 RHO 的数字,本质上就是反复演示基础设施那半边有多值得单独投入。
测量:harness 对分数的影响几乎等于换模型
Claw-SWE-Bench 从一个契约问题出发:SWE-bench 要求干净的 Docker 工作区、一个补丁、一个预测格式。通用 agent 工具用得再好,契约不满足照样零分:补丁提不出来、工作区管不住、停错时机。基准加了适配器协议,让五花八门的 harness 在同一套提示、预算、工作区规则、补丁提取与评测器下跑,harness 从看不见的管线变成可控变量。
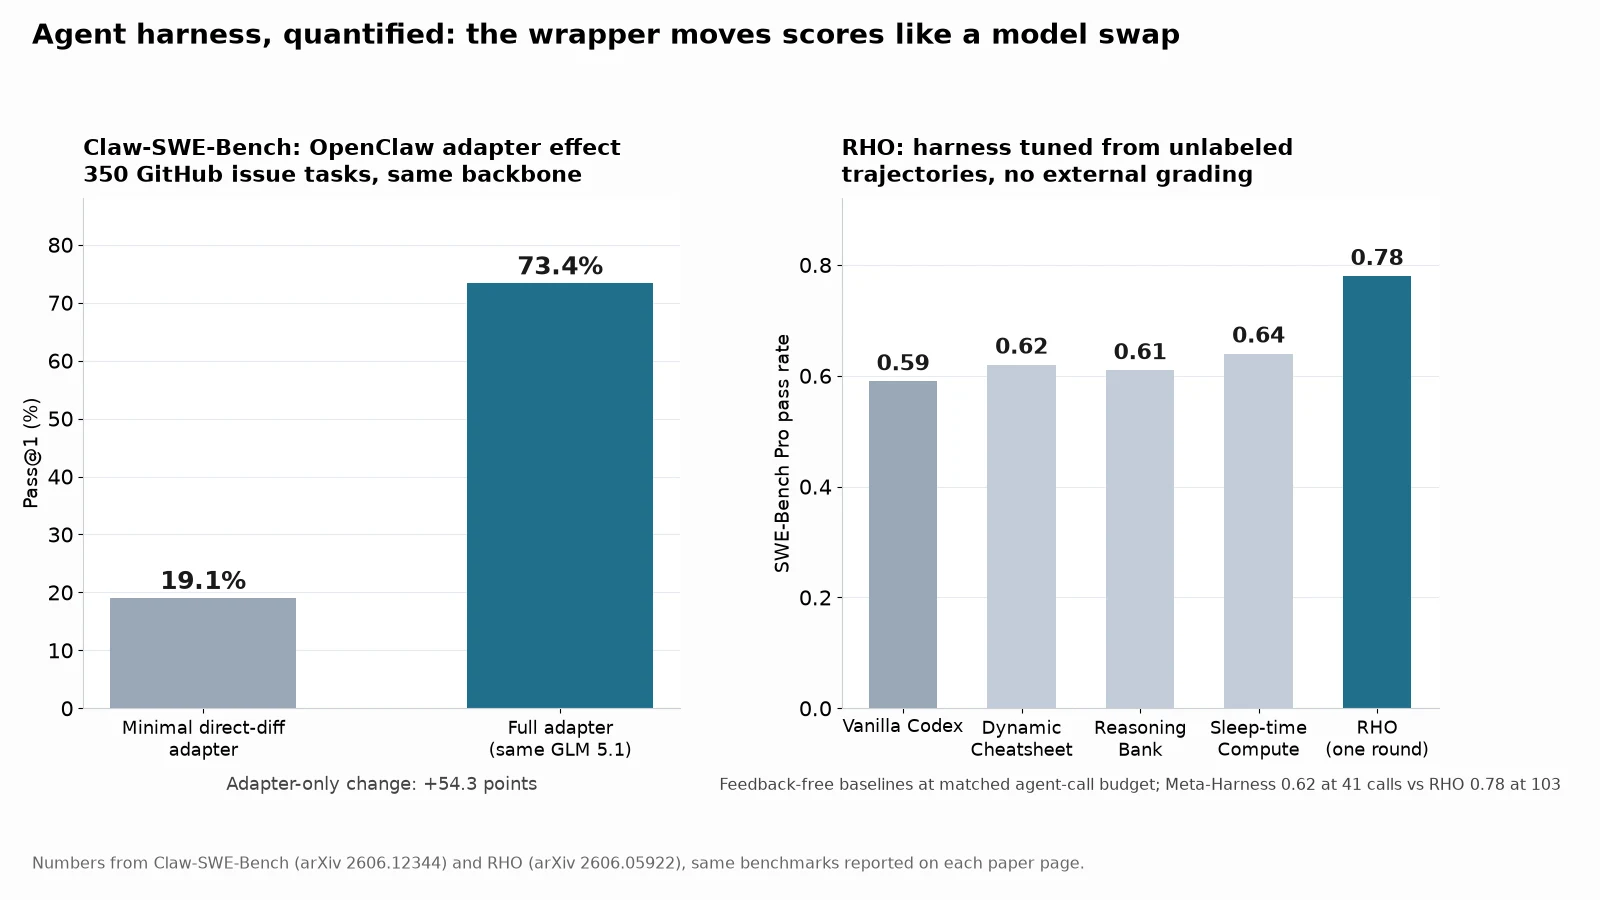
结果毫不含糊:350 题全集上,GLM 5.1 搭最小直连适配器只有 19.1% Pass@1,换全量适配器到 73.4%;同一模型同一批题,54 分全靠适配器设计。两个维度的扫描把 harness 摆到模型旁边:九个模型在同一 harness 里换,模型选择带来 29.4 分的波动;五个 harness 固定模型换,harness 选择带来 27.4 分。两个量级几乎一样,而只报”模型名+一个分”的榜单排的根本不是它以为的那个东西。
两个设计细节值得直接抄。一是 Claw-SWE-Bench Lite:按 17 个校准列做成本感知、排名感知的挑选,选出 80 题、覆盖 43 个仓库中的 34 个,成本约为全量的 22.9%,聚合行为保持一致:Lite 均分 0.643,全量 0.639,差 0.4 分。这是 harness 迭代想要的回归测试:便宜到每次改动都跑得起,又不至于骗你。二是 future-commit 清理:把泄露 issue 之后信息的仓库历史去掉后,没有任何一轮分数上升,掉得最多的是 Claude Opus 4.7,从 84.7% 到 76.7%。污染处理会改变排名,所以凡是基准给了清理后数字,就用清理后的。
扳手:没有标注时怎么改进 harness
Claw-SWE-Bench 告诉你 harness 重要,RHO 回答的是周二下午的场景:一堆历史 agent 运行记录,没有带标注的验证集。常规 harness 优化器靠标注打分挑候选;RHO 用 agent 对自己 rollouts 的判断替掉标注,分三步。
核心集选择:用行列式点过程(DPP)从过去的任务里挑一小批又难又分散的子集,平衡”挑难题”和”摊开覆盖”两个拉力。论文的分析值得记住:只按难度选会扎堆在某一类任务上,只按覆盖选会把预算浪费在简单题上,两个单边版本都跑不过随机采样,只有组合起来的 DPP 拿到最高增益。
从 rollouts 里诊断:并行重解核心集任务,提取两个无标注信号:self-validation 在单条轨迹里找 agent 自己失败了的检查,self-consistency 在并行轨迹之间找同一任务上的分歧。都不需要答案。
Best-of-N 提案与自偏好:从诊断里采样多个候选 harness,重跑,让 agent 在成对比较里选它更偏好的那个上线。消融显示每块都承重:去掉 self-consistency,SWE-Bench Pro 掉到 0.56,比 0.59 的原始基线还差;去掉 self-validation 得 0.70;不做诊断直接喂原始轨迹得 0.60。单次提案随机性太大,采样加过滤不可省。
回报具体体现在两处。分数上:一轮把 SWE-Bench Pro 从 0.59 拉到 0.78,全程无外部打分;同 agent 调用预算下,反馈无关的记忆与技能类基线只有 0.62、0.61、0.64;用标注的 Meta-Harness 在同单轮预算下 0.62(RHO 花 103 次 agent 调用,它花 41 次;放宽到十轮、约 3 倍算力,Meta-Harness 到 0.80,但终究依赖 RHO 从不碰的标注)。Terminal-Bench 2(0.71 到 0.76)和 GAIA-2(0.29 到 0.37)的增益真实但小得多,所以 SWE-Bench Pro 是顺风局。内容上:优化出来的 harness 不是抽象的提示词微调,而是具体的工程修复:agent 发现 Go 工具链不在默认路径里、Python 缓存目录不剥掉补丁就会应用失败,于是写出 check_build_and_lint 工具把两件事都固化下来。这些是从失败数据里自动挖出来的可调试修复。
怎么选
三篇论文拼得成一条流水线,而不是互相竞争。
- 先审计契约:优化之前,先确认 harness 满足任务契约:补丁提取、工作区卫生、停止规则。19.1% 就是一个有能力模型的”harness 契约不及格”形态,契约缺失没有优化器能补。
- 两个轴分开埋点:固定 harness 报模型分,固定模型报 harness 分。只跟踪”每个模型一个数”,模型回退和 harness 回退你永远分不清。
- 搭便宜的回归环:学 Lite 的思路选一个小子集,按排名保持而不是”友好度”来挑,每次 harness 改动都跑。花 22.9% 的成本抓住 50 分的适配器回退,是这一页里最划算的交易。
- 再谈优化,没标注也行:有带分 rollouts,用标注的优化器仍然最省样本;没有,RHO 的路线走得通,但要把真实成本算进去:诊断信号是算力(每轮 103 次 agent 调用),自偏好可能奖励”模型喜欢”而非”能泛化”的改动,而且方法假定基模型够强、自一致性本身有信号;模型太弱、rollouts 分歧原因不对时,诊断会带偏,论文没测这条边界。
局限与存疑
三篇都有自己的天花板。Claw-SWE-Bench 的结果多为单次运行聚合,harness 轴的扫描只有五个 harness、两个模型,证明了”harness 重要”但没画全模型×harness 的交互面;供应商定价与缓存记账也会影响成本数字。RHO 的头条是单基准单轮固定 agent 的结果,+5 和 +8 分的小增益才是常态;给自己打分的 agent 可能批准讨好它自己的 harness 改动;RHO 自己的 Table 3 里,被选中的候选也并非总是真实最高分。综述是地图不是证据:可执行、可检查、有状态这个框架干净但不可证伪,把旧工具使用研究换个标签装进来,不等于标签就是对的。三篇共同留下的开放问题是:代码任务上的模型-harness 不可分性,对浏览器 agent、桌面 agent、研究 agent 是否同样成立,还没有人给这些轴做过基准。
常见问题
什么是 agent harness?
模型没有写出来、却构成其运行环境的那一整层:指令、工具、技能、工作区契约、补丁提取、停止规则和运行预算。综述的框架是:代码是 harness 的天然底座,因为它可执行、可检查、有状态。
harness 对 coding agent 分数影响有多大?
非常大。Claw-SWE-Bench 上,同一个 GLM 5.1 只换适配器,Pass@1 从 19.1% 到 73.4%;受控扫描里,harness 选择带来 27.4 分波动,接近模型选择的 29.4 分。
没有 ground-truth 标注能优化 harness 吗?
能。RHO 只靠无标注历史轨迹:用 DPP 选又难又分散的核心集,用 self-validation 和 self-consistency 诊断失败,采样候选 harness 后让 agent 成对自偏好选出上线的那个。一轮就把 SWE-Bench Pro 从 0.59 拉到 0.78,全程无外部打分。
迭代 harness 最便宜的方式是什么?
成本感知的 Lite 子集,学 Claw-SWE-Bench Lite-80:按 17 个校准列选 80 题,成本约全量 350 题的 22.9%,聚合 Pass@1 差距仅 0.4 分。每次 harness 改动都跑一遍。
一句话:harness 不是管线工事的杂活,而是值 27 分 Pass@1 的一等变量,还能从你自己的无标注轨迹里调出来。读原文:Code as Agent Harness、Claw-SWE-Bench、RHO。