
4-bit 训练 vs 适配器共享:一台 GPU 变强的两条路线
LongLive-2.0 把长视频模型压进 NVFP4 4-bit,64 秒生成显存 112.9→36.3 GB;MinT 让基座常驻只换 LoRA 适配器,稠密模型切换提速 18.3 倍。
两把刀切的是同一个账单
两篇论文回答的是同一道算术题:前沿模型对大多数人手里的硬件来说太大了,而”多买 GPU”早就不是方案。但它们的切入点完全相反。
LongLive-2.0把模型本身按比特数做小:把一个 5B 长视频扩散模型的训练与推理全部跑在 NVIDIA 的 NVFP4 4-bit 格式里,再配上 Balanced SP 序列并行(把干净与带噪的 latent 块配到同一张卡上)让长片段训练不再爆显存。它的主张不是”4-bit 推理没问题”(这已是常识),而是连训练在内的整条管线都能在 4-bit 下几乎不掉质量地活下来。
MinT把要服务的”模型集合”按参数量做小:一个基座常驻显存,每个微调版本只是一枚可插拔的 LoRA 适配器,rank-1 设置下常常不到基座的 1%。昂贵的”加载新模型”于是变成廉价的”挂上新适配器”。它是为百万级适配器目录、万亿参数以上的共享基座设计的。
一个压缩大家共用的权重,一个压缩彼此之间的差异。
关键数字
| 指标 | LongLive-2.0(NVFP4 4-bit) | MinT(共享基座 LoRA) | 同口径? |
|---|---|---|---|
| 省的是什么 | 单模型的显存与时间 | 多模型间的切换与存储 | 单位不同 |
| headline 提速 | 训练 2.1x、推理 1.84x(对 BF16) | 切换 18.3x(4B 稠密)、2.85x(30B MoE) | 各对各自基线 |
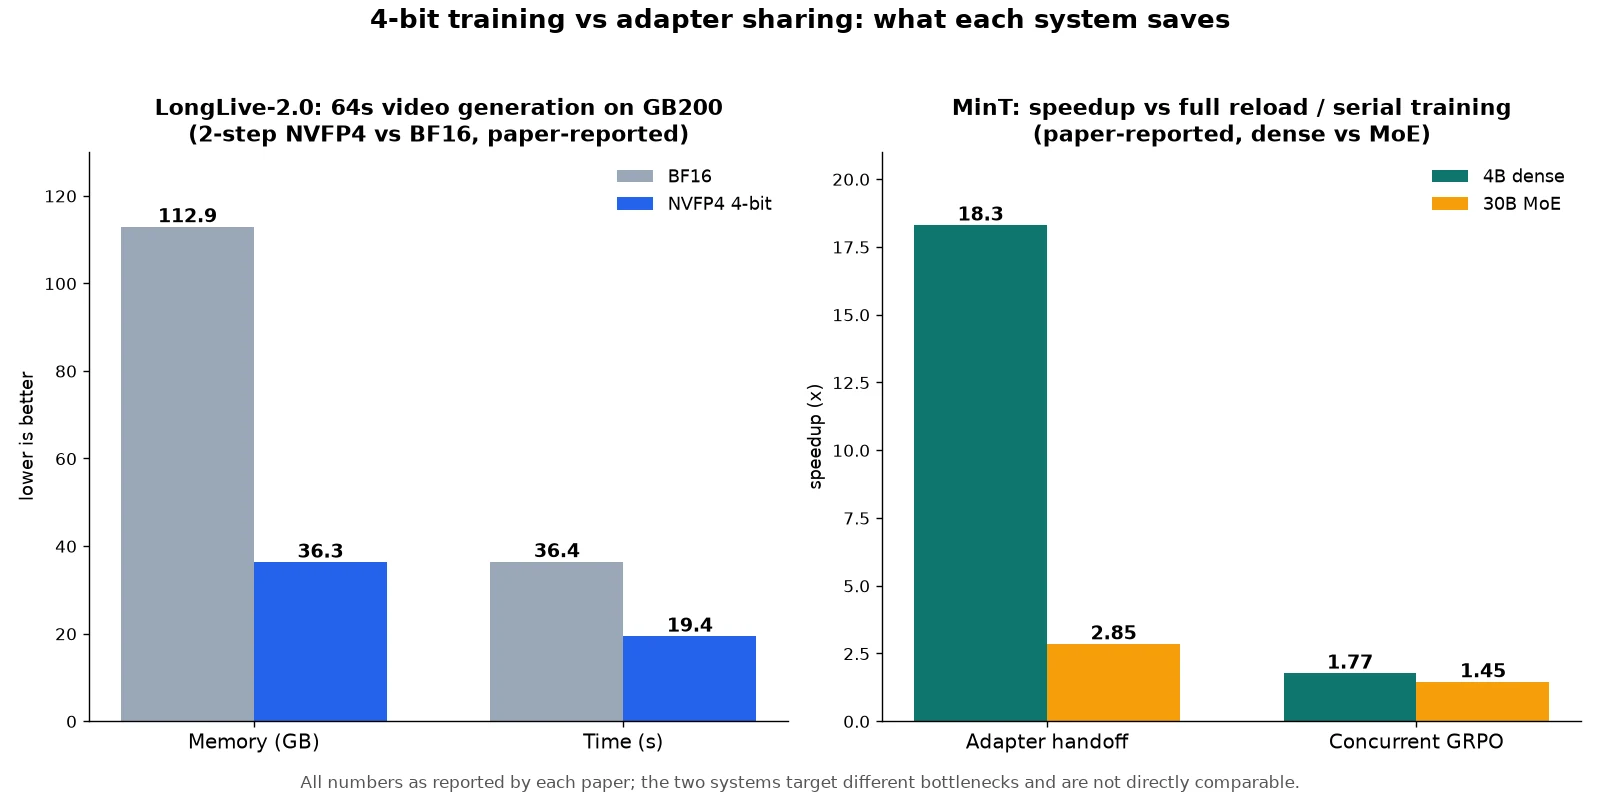
| GB200 上 64 秒生成 | 36.3 GB / 19.4s(2-step NVFP4)对 112.9 GB / 36.4s(BF16) | 不适用(服务基础设施) | 不适用 |
| 吞吐 | 1280x720 下 45.7 FPS(2-step);4-step 29.7 对 BF16 24.8 | 测的是切换不是吞吐 | 不适用 |
| 质量代价 | VBench 总分 85.06 → 84.51(4-step)→ 83.14(2-step) | 基础设施论文,不测质量 | LongLive 内部 |
| 64 秒片段训练迭代 | 1196.5s → 639.5s;BF16 无 SP 直接 OOM | 并发 GRPO 墙钟 1.77x(稠密)/ 1.45x(MoE) | 各内部 |
| 配套技巧 | KV 缓存约 3.6x 压缩、开销不足 2%;流式 VAE | MoE 适配器打包加载提速 8.5-8.7x | 各内部 |
| 成立的前提 | Blackwell 的 4-bit Tensor Core | 所有租户共享同一基座 | 不适用 |
| 退路 | A100/H100 退回序列并行,没有 4-bit 加速 | 整体重载,即基线本身 | 不适用 |
这张表的价值恰恰在于它没有什么:没有共享基准、没有共享任务、没有共享硬件。两个系统不是竞品,任何给它们排座次的页面都是在编造对比。可比的是省钱的形状和假设的形状。
各自动的到底是什么手术
LongLive-2.0 的难点是误差累积。长视频扩散按块自回归,每块都以上一块的输出为条件,4-bit 舍入的小误差会在 60 秒片段上滚成漂移、闪烁和身份丢失。整套设计都是为了掐断这条累积链:Balanced SP 均衡各卡负载、NVFP4 层级缩放(FP4 数值、FP8 块刻度、FP32 张量刻度)、直接在 4-bit 下蒸馏、推理端 W4A4 加 KV 缓存独立量化与异步流式 VAE。回报是:VBench-Long 60 秒片段上,主体一致性 NVFP4 反而守在 97.62%,BF16 是 97.48%。
MinT 的难点是簿记。一百万个租户各要”一个模型”,而它们都是同一基座加一枚小小的 LoRA 增量,服务问题就从推理变成了管理:切换活跃适配器要多快、MoE 各专家的适配器怎么打包才不致逐张量慢爬(打包后快 8.5-8.7 倍)、一浪适配器的 GRPO 更新怎么并发跑而不是排队(1.77x / 1.45x)。稠密与 MoE 两行的差距是最诚实的信号:被摊销的基座成本越大,收益越大,MoE 路由会吃掉一部分。
怎么选
- 一个大模型服务大量用户,账单按推理显存算:LongLive-2.0 的刀。在 Blackwell 上,显存砍约 3 倍、质量只差半分,是笔划算的账;训练侧 2.1x 是复利。
- 一个基座的无数微调变体,账单按切换和存储算:MinT 的刀。稠密模型 18.3 倍的切换提速,是”每批请求一个模型”和”每请求一枚适配器”的区别。
- 上规模跑 MoE:读 MinT 的 MoE 行(2.85x、1.45x),别拿稠密的 headline 做预算。
- 想要 LongLive-2.0 的最快模式:记住 45.7 FPS 是 2-step,VBench 总分跌到 83.14,语义子分从 78.63 掉到 74.12。最快的档和最好的质量不是同一个配置。
- 不在 Blackwell 上:LongLive-2.0 只给你工程、不给你 4-bit 加速;MinT 的收益原理上与硬件无关,因为它省的是重载。
还有一个容易被忽略的组合:两篇论文不互斥。一个既做 4-bit 量化、又用共享基座加适配器的服务栈,理论上两篇的账可以一起省,只是这个组合本身还没有论文测过,别把两篇的数字直接相乘当成预期收益。
局限与存疑
LongLive-2.0 的坑是硬件锁死和质量-速度分档;它的赢面是吞吐和显存,不是新能力。MinT 的坑是条件成立:两个用例真需要不同基座时,核心技巧直接失效;而且作为基础设施论文它完全不评估适配器本身够不够好。两者都是系统论文,量的都是自己的经济账,不是最终质量。
两篇论文也没回答一个显然的后续问题:既 4-bit 又共享适配器的组合栈(NVFP4 权重加按租户的 LoRA 增量)是显而易见的下一步,但 4-bit 舍入会不会和小幅适配器更新互相干扰,目前没有数据。
常见问题
4-bit 训练对比 LoRA 服务,哪个更省钱?
省的不是同一行账。LongLive-2.0 把单模型推理显存砍掉约 3 倍(64 秒片段 112.9 GB → 36.3 GB)、训练时间提速 2.1 倍;MinT 把模型间切换提速 18.3 倍(4B 稠密)。账单是大模型占贵卡,用量化;账单是一个基座的无数变体,用适配器共享。
NVFP4 4-bit 训练如何影响生成质量?
按 LongLive-2.0 的测量,4-step 下几乎不伤:VBench 总分 85.06(BF16)对 84.51(NVFP4 4-step),60 秒片段主体一致性 97.62% 对 97.48%。更快的 2-step 代价更大,总分跌到 83.14,语义子分 78.63 → 74.12。
MinT 是在训练一百万个独立模型吗?
不是。它面向的是共享基座上约 10^6 量级的 LoRA 适配器目录,rank-1 时每枚不到基座的 1%。提速以”租户共享基座”为前提;真需要不同基座,技巧就失效了。
为什么 MinT 在 MoE 上的提速比稠密小?
因为收益来自省掉基座重载,而被摊销的基座成本越大、省得越多。30B MoE 每次切换的固定开销比 4B 稠密大,所以切换提速是 2.85x 而不是 18.3x,并发训练收益也从 1.77x 缩到 1.45x。两行是同一个规律。