
专家混合 · Transformer · 高效 AI · 扩散模型
MPI、DAR 与 dMoE:三个 Transformer 路由重设计,用数字对比
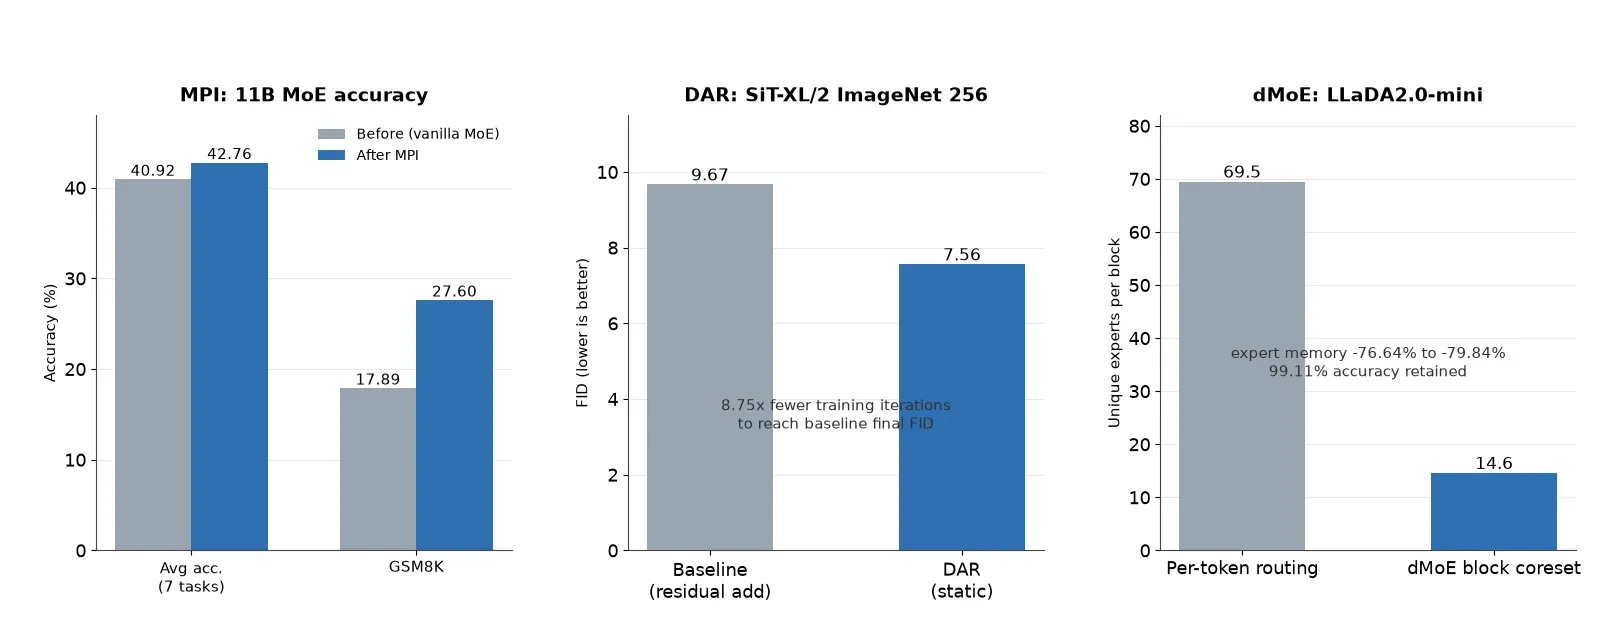
三篇 2026 论文在专家、深度、块三层级重做路由:MPI 11B MoE 均值 42.76,DAR FID 7.56、迭代省 8.75 倍,dMoE 每块专家 14.6。
同一个抱怨,在三个层级上各听到一次
这三篇论文没有一篇的目标是造更大的模型。它们的出发点完全一致:决定信息在 transformer 内部走向的那条路径,是约定俗成定下来的,而这个约定已经和实际负载对不上。约定错在哪一层,修法就落在哪一层。
Manifold Power Iteration(MPI)作用在专家层级。稀疏 MoE 层用一个可学习的路由矩阵给 token 指派专家,矩阵每一行代表一个专家,但标准训练目标并不保证这一行真的编码了该专家自身权重的任何信息。MPI 的做法是把每个路由行朝对应专家权重矩阵的主奇异方向更新一步,再收回到受控尺度的约束面上,让路由均衡不被破坏。每行只做一步幂迭代,成本压得住:作者报告 11B 规模训练只慢 0.2%,推理零开销,因为变换后的路由器可以在加载模型时预先算好。
Diffusion-Adaptive Routing(DAR)作用在深度层级。残差相加 x = x + sublayer(x) 是从语言 transformer 继承来的,DAR 在 SiT-XL/2 的 28 个 block 上实测出三个随深度恶化的毛病:残差流的模长单调膨胀,早层拿到的梯度急剧衰减,相邻 block 算出的更新近乎重复。DAR 保留所有历史子层输出,把每个 block 的输入改成对这段历史的可学习加权组合,权重还随扩散时间步变化。静态变体(固定学习系数)几乎不增加推理成本,但 headline 收益照样拿到。
dMoE作用在解码块层级。扩散语言模型一次并行揭开一整块 token,可 MoE 路由沿用了自回归的做法逐 token 选专家,于是 LLaDA2.0-mini 上单个解码块平均触及 69.5 个不同专家,全部都得驻留显存供这一步并行前向。dMoE 把块内 token 的路由分数加总成块级分布,用 top-p 选出一份共享专家核心集,再把每个 token 的选择限制在核心集内。token 仍然各自路由,只是工作集换成了整块公认重要的那批专家。
关键数字
以下数字全部来自论文作者自报,且每一项都是单篇论文内部的改造前后对比。三篇论文用的模型、任务、指标各不相同,跨论文排名没有意义。
| 测量项 | 改造前 | 改造后 | 场景与出处 | 同口径? |
|---|---|---|---|---|
| 11B MoE 七个下游任务平均准确率 | 40.92 | 42.76 | MPI 中训练结果 | 是,同一模型 |
| 同一 11B 运行的 GSM8K | 17.89 | 27.60 | MPI 论文 | 是,同一模型 |
| 11B validation bits per byte | 0.728 | 0.723 | MPI 论文 | 是,同一模型 |
| 11B Math 集 validation bpb | 1.852 | 1.581 | MPI 论文 | 是,同一模型 |
| 训练吞吐 | 基线每天 34.97B tokens | 加 MPI 慢 0.2% | MPI 论文 11B 设置 | 是 |
| 1B 规模 25 个 benchmark 平均,四种优化器 | 改造前 42.26 到 43.01 | 加 MPI 提升 +0.54 到 +1.34 | MPI 优化器扫描(AdamW、AdamH、Muon、MuonH) | 是 |
| 路由器负载均衡 MaxVio Global,3B | 0.964 | 0.711 | MPI 论文 | 是 |
| ImageNet 256x256 FID,SiT-XL/2 | 9.67 | 7.56 | DAR 静态配置 | 是,同一模型 |
| 达到基线最终 FID 所需训练迭代 | 1x | 少 8.75 倍 | DAR 论文,早中段训练曲线 | 是 |
| 叠在 REPA 上的早期训练加速 | 1x | 约 2 倍加速 | DAR 论文 | 是 |
| LLaDA2.0-mini 每解码块触及的唯一专家数 | 69.5 | 14.6 | dMoE 论文 | 是,同一模型 |
| 核心集路由后的精度保留 | 100% | 99.11% | dMoE,MATH500、GSM8K、ARC-C、MMLU 数学子集 | 是,同一模型 |
| 专家权重显存 | 100% | 降 76.64% 到 79.84% | dMoE 论文 | 是 |
| 端到端延迟 | 1x | 加速 1.14 倍到 1.66 倍 | dMoE 论文,随运行点变化 | 是 |
| 跨论文对比 | 不适用 | 不适用 | 模型、任务、指标全不同 | 否,从未同场 |
两个数字各自撑起了论文的席位。DAR 那边是 8.75 倍迭代缩减:DiT 预训练由算力主导,一个只动残差路径的即插即用改动能更早到达同样的 FID,实验室不用重构管线就能采用。dMoE 那边是 76 到 80% 的显存削减:它把受显存限制的 MoE 扩散 LLM 变成了塞得进更紧服务预算的东西。MPI 的论据不靠单一 benchmark,而在于增益从 1B 到 3B 到 11B、横跨四种优化器都成立。
被重做的到底是什么
三篇论文路由的对象不同,这个差异决定了各自什么时候用得上。MPI 改的是路由行的含义:从自由向量变成跟随专家权重主方向的压缩代理。它是训练期的表示层修正,而且不动 top-k 派发的接口,所以能和其他路由技巧叠加。负载均衡数字(3B 上 MaxVio Global 从 0.964 降到 0.711)说明部分收益来自路由变平稳,不只是对齐更好。
DAR 改的是深度的含义。残差流只会累积,DAR 的历史聚合允许后面的 block 下调甚至跳过前面的贡献,这正是针对测出的模长膨胀和梯度衰减。随时间步变化的版本多了一条轴:扩散在同一网络的许多噪声档位上运行,静态残差做不到每个档位路由得不一样。对工程师来说静态变体更要紧,因为它在推理时几乎免费。
dMoE 改的是解码步的含义。块级并行解码想要小而共享的工作集,逐 token 路由想要每个 token 最大程度的自由,两者方向相反。dMoE 在路由层化解冲突,核心集由模型自己学出的分数导出:高流量专家留下,被一个跑偏 token 带进来的长尾专家被丢掉。值得注意的是,三个方法里只有它属于服务期手段,模型权重一个都不改。
怎么选
如果你在预训练或中训练稀疏语言模型,训练循环里加一行路由器更新就用 MPI。诚实的保留是:它的对照组是 vanilla 路由器,和当前最强的负载均衡损失叠加后还剩多少收益,论文留作开放问题。
如果你在训练 DiT 系图像模型,优化目标是单位训练成本的 FID,用 DAR,先用静态变体。8.75 倍是早中段训练的对比,把它当作开跑的理由,别当成收敛末端的保证。
如果你已经在服务一个 MoE 扩散 LLM,瓶颈是显存而不是质量,用 dMoE。它的评估只有一个开源模型(LLaDA2.0-mini)和一组偏推理的 benchmark,99.11% 这个数要在自己的负载上复验过再信。
局限与存疑
三个结果都是作者自跑,没有公开复现。MPI 和 DAR 是训练期改动,报告的额外成本(慢 0.2%、静态推理近免费)都附带了具体实现条件。dMoE 最窄:一个底座模型、四个 benchmark,平均精度没有拆出哪个任务掉得最多。更大的问题是可叠加性。一个现代扩散 LLM 同时是 MoE 模型、扩散模型和深 transformer,理论上可能同时想要 MPI 的路由对齐、DAR 的深度路由和 dMoE 的块核心集。三者叠加是互补还是互相干扰,这组论文里没有任何实验回答,这是下一步值得跑的实验。
背景阅读:这三篇论文改的是混合专家(Mixture of Experts)的机制,扩散 LLM 那条线的全景见扩散语言模型与自回归语言模型对比。
常见问题
MPI 在 11B MoE 上的结果是多少?
论文的 11B 运行中,七个下游任务平均准确率从 40.92 升到 42.76,GSM8K 从 17.89 升到 27.60,validation bits per byte 从 0.728 降到 0.723,全部是同一模型的改造前后对比。
DAR 在 ImageNet 上的报告结果如何?
在 ImageNet 256x256 上,静态 DAR 配置把 FID 从 9.67 降到 7.56,并用少 8.75 倍的训练迭代追平基线收敛质量;叠在 REPA 上还能带来约 2 倍早期训练加速。
dMoE 的方法能省多少显存?
dMoE 把专家权重显存削减 76.64% 到 79.84%,端到端延迟加速 1.14 到 1.66 倍,在所测基准上保留原模型 99.11% 的精度。
三个方法需要重训模型吗?
MPI 在训练期更新路由行,DAR 和模型一起训练,dMoE 完全属于服务期改动,不需要重训。
三者路由的对象有何不同?
MPI 重定义路由行的含义来给 token 指派专家,DAR 用历史聚合替换残差相加来路由跨深度的子层输出,dMoE 则让整个解码块共享一份专家核心集。
这些论文的数字如何对比才安全?
只对比各篇内部的改造前后数字,上文引用的就是。三篇论文的模型、任务、指标全不同,任何跨论文排名都是编出来的,不是测出来的。