
Flamingo 与 LLaVA 对比:少样本提示 vs 视觉指令微调
Flamingo 冻结双骨干,只靠提示里 32 个示例学新任务;LLaVA 用 GPT-4 写的 15.8 万条指令微调 Vicuna。同一个冻结编码器的思路,两种截然相反的任务接口。
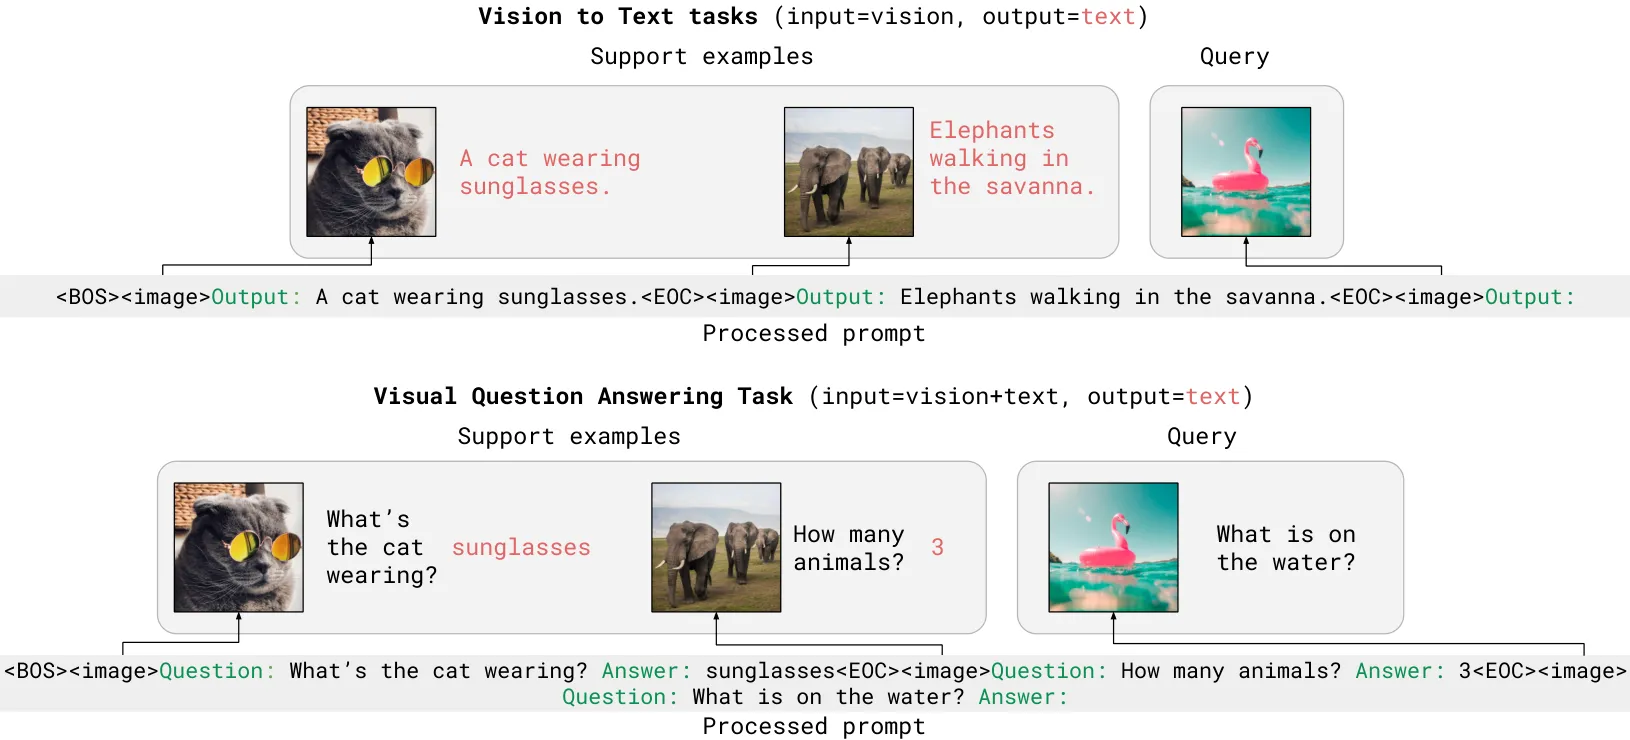
同一个问题的两个答案
两篇论文回答的是同一个问题:怎么让一个强大的文本模型”看见”图像。Flamingo(DeepMind,NeurIPS 2022)的答案是:什么都别微调。冻结视觉编码器和语言模型,只训练连接两者的桥,任务全靠提示词带进去。LLaVA(2023)的答案正相反:让文本版 GPT-4 批量生成图像指令,再拿这些指令把语言模型本身微调成多模态聊天模型。两篇论文相隔约一年,而整个领域的重心在这期间从第一种答案倒向了第二种。想快速看懂今天开源多模态模型的构建方式,搞清这次转向的原因是最快的一条路。
两者真正下注的不是架构细节,而是”任务住在哪里”。Flamingo 赌任务住在提示里:给模型几对「图像→答案」示例,它就会接着往下写,所以同一套冻结权重能做图说、视觉问答、选择题,甚至视频问答,全程零梯度更新。LLaVA 赌用户根本不会去写少样本提示:用户只会敲一句”我冰箱里有什么?“,而只有微调过的模型才能这样聊天。
两个模型分别怎么连接视觉与语言
Flamingo 把两个骨干全部冻结。Perceiver Resampler 把视觉编码器变长的特征网格压成固定数量的视觉 token,再在被冻结的语言模型里穿插若干带门的交叉注意力层,让文本 token 去”看”这些视觉 token。门控初始值接近恒等,模型开局等于原始语言模型,视觉通路在训练中慢慢长出来。最大的 Flamingo-80B 用 70B 的 Chinchilla 语言模型;3B 和 9B 版本分别配 1.4B、7B 骨干。
LLaVA 简单到近乎粗暴:冻结的 CLIP ViT-L/14 编码图像,一个可训练线性投影把特征映进 Vicuna 的词嵌入空间,Vicuna 像读普通文字一样读这些”视觉 token”。训练分两阶段:第一阶段只在 59.5 万对过滤后的 CC3M 图文对上训练投影矩阵;第二阶段放开整个语言模型,在 15.8 万条指令上微调,视觉编码器保持冻结。没有交叉注意力堆栈,没有 resampler,连接器就是一块矩阵。
关键数字
| 测量项 | Flamingo-80B | LLaVA(13B Vicuna) | 备注 |
|---|---|---|---|
| 被训练的连接器 | Perceiver Resampler + 门控交叉注意力 | 单个线性投影 | 一个重、一个轻 |
| 训练时的语言骨干 | 冻结的 70B Chinchilla | 第二阶段放开整个 Vicuna-13B | 策略正相反 |
| 对齐训练数据 | M3W 约 4300 万网页、ALIGN 18 亿对、LTIP 3.12 亿对、VTP 2700 万视频 | 59.5 万 CC3M 图文对 + 15.8 万 GPT-4 指令(对话 5.8 万/详细描述 2.3 万/复杂推理 7.7 万) | GPT-4 全程没看过图 |
| VQAv2 | 0 样本 56.3,4 样本 63.1,32 样本 67.6 | 未报告 | LLaVA 把学术 VQA 留给后续 LLaVA-1.5 |
| OK-VQA | 32 样本 57.8 | 未报告 | 当时微调 SOTA 为 54.4,用了 1 万标注 |
| TextVQA | 32 样本 37.9 | 未报告 | 偏重读文字的 VQA |
| COCO 图说(CIDEr) | 0 样本 84.3,32 样本 113.8 | 未报告 | 微调 SOTA 143.3,训练用了 50 万标注 |
| LLaVA-Bench(COCO),相对 GPT-4 | 不适用 | 85.1;不做指令微调则掉到 21.5 | 对话 83.1、描述 75.3、推理 96.5 |
| ScienceQA 准确率 | 未报告 | 单模型 90.92,加 GPT-4 当裁判 92.53 | 人类 88.40,前 SOTA MM-CoT 91.68,LLaVA 7B 89.84 |
| LLaVA-Bench(In-the-Wild)相对分 | OpenFlamingo 19.1 | 67.3 ± 2.0 | BLIP-2 为 38.1;裁判是文本版 GPT-4 |
| 全量微调后的上限 | VQAv2 82.0、COCO 138.1 | ScienceQA 加 GPT-4 裁判 92.53 | 任务不同,无同环境对照 |
这张表给不了的东西,恰恰是最想要的:没有任何一行是 Flamingo 和 LLaVA 在同一基准、同一条件下正面交手。LLaVA 论文完全没报 VQAv2 和 COCO 图说,作者明确把学术 VQA 留给了后续工作。最接近的一次交叉,是 LLaVA-Bench In-the-Wild 那行:LLaVA 比的是 OpenFlamingo(Flamingo 的开源复现版):67.3 对 19.1。差距真实存在,但那不是 Flamingo-80B 本尊,而本尊从未开源。
少样本提示到底买到了什么
Flamingo 的头条是:能力的增长来自示例数量,而不是梯度步数。VQAv2 从零样本的 56.3 涨到 32 样本的 67.6,OK-VQA 从 50.6 涨到 57.8,COCO 图说从 84.3 涨到 113.8。在 16 个基准中的 6 个上,仅 32 个示例就超过了当时微调式 SOTA;而那个 VQAv2 的 80.2 是用 44.4 万条 VQA 标注训出来的,示例数量是 Flamingo 提示的约 1.4 万倍。更关键的是,同一个冻结模型照单全收全部任务,还包括视频:MSVDQA 32 样本 52.3,VATEX 65.1。
代价也实打实。少样本数字对示例的挑选和顺序敏感,上面每个数都是一种”精心构造的好提示”的产物,不是 guaranteed 的表现。32 样本的提示很长,70B 级模型的推理成本随之水涨船高。而且这套范式教不会模型聊天:Flamingo 是”接着往下写”,不是”听懂一条换着花样提的要求”。论文里全量微调的消融反而泄露了答案:一旦有了标注,微调式 VQAv2 能到 82.0,COCO 到 138.1。
指令微调到底买到了什么
LLaVA 的贡献与其说是架构,不如说是一份普通实验室负担得起的菜谱。15.8 万条指令全部由纯文本 GPT-4 代写,喂给它的是 caption 和边界框,是图像的”符号替身”;视觉编码器是现成的 CLIP;连接器是一块矩阵;两阶段训练在 8 张 A100 上大约跑 14 个小时。数据、权重、代码全部开放,这才是它身后成千上万后续工作的真正原因。
已有的数字很强,但框定得很窄。ScienceQA 上 LLaVA 单模型 90.92,超过人类平均的 88.40,几乎追平前 SOTA MM-CoT 的 91.68;再叠一个 GPT-4 当裁判才到 92.53。LLaVA-Bench 上相对 GPT-4 的 85.1 更像是一致性测量:GPT-4 既是数据老师又当裁判,而这个数在不微调时崩到 21.5,恰恰证明能力来自指令微调阶段,而不是连接器。In-the-Wild 上 67.3 对 OpenFlamingo 的 19.1 是论文对 Flamingo 血脉唯一一次正面出招,也确实打中了,只是裁判来自获胜方的家族。
为什么领域从 Flamingo 走向了 LLaVA
两篇论文并没有互相推翻,它们优化的是不同的东西。Flamingo 优化覆盖率:一个冻结模型不做任何重训能覆盖多少任务,这在标注根本不存在时才是刚需。LLaVA 优化易用性:人和模型说话能有多自然,而市场最终要的正是这个。聊天一旦成为主流交互方式,少样本提示的核心优势就没了:没人想在问一句话之前先贴 32 个示例;而指令微调”需要指令数据”的短板,又被 LLaVA 自己那招”拿 GPT-4 当数据工厂”给补上了。
两条血脉后来是合流的。今天每一个开源 VLM 都在微调自己的语言模型(LLaVA 的选择),同时保持视觉编码器冻结(两篇共同的选择);连接器则从 LLaVA 的线性层一路演进向更复杂的设计,而 Flamingo 的门控交叉注意力正是这些设计的先声。少样本能力也没有消失:它换了个名字回来,成为多模态模型的一项评测方式,Flamingo 的图文交错输入格式也在为任意图文序列设计的模型里活了下来。
怎么选
- **一个模型要覆盖很多视觉任务、且没有任何任务标注:**走 Flamingo 路线。标注不存在时,提示是唯一的选项;32 个示例打赢 44 万条标注训出的模型,就是它能用的证据。
- **在做面向用户的图像助手、要听懂开放式指令:**走 LLaVA 路线。“用警察笔录的风格描述这张照片”这种要求,只有指令微调接得住,没法靠提示模板。
- **算力有限、要可复现:**LLaVA,毫无悬念。一块投影矩阵、8 张消费级显卡一天跑完,数据权重代码全开放。
- **要视频问答、或单次前向处理交错的图文序列:**Flamingo 的架构原生支持交错输入,论文也带了视频基准;LLaVA v1 只处理单图单轮。
- **要可信的基准数字:**两张表都要带着裁判和环境来读:Flamingo 的数怕提示挑样,LLaVA 的数由 GPT-4 当裁判。
局限与存疑
这个对比的结构缺陷是:两篇论文从未在任何基准上碰过面。LLaVA 没报 VQAv2,意味着世上不存在一个数能回答”普通视觉问答到底谁强”;唯一重叠的 In-the-Wild 评测,用的是 Flamingo 的复现版,裁判又来自获胜方的家族。Flamingo 的少样本数字天然带着选例敏感性,67.6 应读作上限而非期望。LLaVA 的 92.53 混合了模型能力和裁判质量:GPT-4 在回路里才有的数,单模型是 90.92。而且两篇都是 2022–2023 年的结果,今天的 VLM 与两者都已不同:这个对比解释的是设计空间的来历,不是照抄哪份菜谱去造前沿模型。
常见问题
Flamingo 和 LLaVA 的根本区别是什么?
Flamingo 只训练冻结视觉编码器与冻结语言模型之间的连接器,任务用提示里的少样本示例指定;LLaVA 在 15.8 万条 GPT-4 生成的图像指令上微调语言模型本身,连接器只有一块线性投影。同样是冻结视觉编码器,对”任务住在哪里”给出了相反的回答。
Flamingo 是少样本、LLaVA 是微调,对吗?
对,正是如此。Flamingo 在 VQAv2 上用 32 个上下文示例拿到 67.6,不做任何权重更新;LLaVA 的 Vicuna 骨干在第二阶段被完整微调,不做指令微调的版本在 LLaVA-Bench 上从 85.1 掉到 21.5。
基准上到底谁更强?
没有诚实答案,因为两者从没在同一基准上被测过。Flamingo-80B 报的是 VQAv2 32 样本 67.6、OK-VQA 57.8、COCO 113.8;LLaVA 报的是 ScienceQA 单模型 90.92、LLaVA-Bench 相对 GPT-4 得 85.1。唯一有交集的 In-the-Wild 评测里,LLaVA 67.3,OpenFlamingo 19.1。
为什么 LLaVA 复现起来比 Flamingo 便宜那么多?
连接器只有一块线性层,指令数据靠 GPT-4 生成,不需要 18 亿对网页图文和 2700 万视频;训练约 14 小时、8 张 A100 搞定。LLaVA 把数据、权重、代码全开放了,而 Flamingo-80B 从未开源。
LLaVA 那个 85.1% 对 GPT-4 的分数可信吗?
部分可信。它的含义是:在 LLaVA-Bench 上,LLaVA 的回答被判为达到”拿着标准 caption 的纯文本 GPT-4”的 85.1%。但 GPT-4 既写了训练数据又当裁判,这个数里掺了同一家族内部一致性。更扎实的发现是 21.5:不做指令微调就崩掉,说明能力来自微调阶段。