
视频编辑模型对比:SANA、LoomVideo 与 CoVEBench
SANA-Streaming RTX 5090 上 24 FPS 流式编辑;LoomVideo 5B 模型 VBench 63.15、快 5.41 倍;CoVEBench 揭组合指令硬伤。
一个领域,三个不同的问题
2026 年说「AI 视频编辑」,底下其实压着至少三个不同的工程问题,而 2026 年年中的三篇论文各自单挑了其中一个。SANA-Streaming 问:视频到视频的编辑能不能在单张消费级显卡上跟住直播帧流?LoomVideo 问:一个小模型能不能同时做生成和编辑,还不付 token 拼接的税?CoVEBench 问的是最不舒服的那个:当一条提示里捆着好几个互相耦合的编辑时,模型到底做全了没有?
三篇论文方法几乎不重叠,也从不共享基准,这正是本篇对比的意义所在。速度、统一成本、指令可靠性是三笔不可兑换的账,一个模型赢了其中一笔,可能另两笔全输。如果你在 2026 年做或买视频编辑系统,诚实的问题不是「哪个编辑器最好」,而是「我的瓶颈是三者中的哪一个」。
关键数字
第一张表是并排总览,把它当地图看,别当排名看:没有任何一行是在三套系统同一协议下测出来的。
| 维度 | SANA-Streaming | LoomVideo | CoVEBench |
|---|---|---|---|
| 角色 | 实时流式 V2V 编辑系统 | 5B 统一生成加编辑模型 | 组合式编辑基准 |
| 招牌声明 | 单张 RTX 5090 上 1280x704 分辨率 24 端到端 FPS | 5B 模型 VBench 63.15,编辑比 OmniWeaving 快 5.41 倍 | 416 个视频上 626 条多点指令,9990 个检查项评分 |
| 核心机制 | 混合 DiT(线性注意力加一个 softmax 块)、循环反向正则、Blackwell 内核加混合精度量化 | Scale-and-Add 条件化:把缩放后的源隐变量直接相加,不拼接 token | MLLM 评判指令遵从与保真度,辅以自动化质量指标 |
| 同口径证据 | 仅论文内部(24 对 58 FPS,管线对 DiT 核心) | 论文内部基准表(VBench、编辑耗时、RefVIE-Bench、FashionVideoBench) | 仅论文内部(摘要未公布逐模型分数) |
| 已知盲区 | 未公布时序一致性指标与对标基线 | 缺隔离 Scale-and-Add 与 MLLM 编码器、Deepstack 的干净消融 | 检查项能说清哪里失败,给不出全场最佳 |
第二张表收集真正同口径的行,全部来自单篇论文内部,因为每行比较的两边跑的是同一协议。
| 同口径对比 | 数字 |
|---|---|
| LoomVideo VBench 均值(RL 版) | 63.15,对 UniVideo 13B 的 63.01、Wan 2.2 5B 的 62.50;成像质量 70.92 领先两者 |
| LoomVideo 编辑耗时(480x832x97 视频) | 166.30 秒,对 OmniWeaving 899.32 秒(5.41 倍)与 UniVideo 6140.18 秒(约 37 倍) |
| LoomVideo 文生视频耗时 | 132.23 秒,对 OmniWeaving 824.93 秒(6.24 倍) |
| LoomVideo 生成转编辑的耗时涨幅 | 132.23 秒到 166.30 秒(涨 26%),对 UniVideo 1792 秒到 6140.18 秒(涨 3.4 倍) |
| LoomVideo RefVIE-Bench 总分 | 3.78,对 UniVideo 3.38、Kiwi-Edit 2.96;主体保真 4.50,背景 3.98 |
| LoomVideo FashionVideoBench | 4.59,对 VINO 4.38、UniVideo 4.26、OmniWeaving 3.56 |
| LoomVideo 多图 TIV2V | 均值 4.24,对 OmniWeaving 3.89 |
| SANA-Streaming 吞吐拆分 | 端到端 24 FPS,单 DiT 核心 58 FPS |
| CoVEBench 基准规模 | 416 个源视频、626 条指令、9990 个检查项;摘要未给逐模型分数 |
有两行值得再读一遍。涨 26% 对涨 3.4 倍那一行,是两篇系统论文里最干净的机制证据:LoomVideo 从生成切到编辑,耗时几乎不动,因为 Scale-and-Add 从不让序列变长;而拼接式的 13B 模型在同一次切换上暴涨 3.4 倍。SANA-Streaming 的拆分行则说明模型不是瓶颈:DiT 核心单跑有 58 FPS,是外围管线吃掉了超过一半的帧预算。
SANA-Streaming:跟得住直播的编辑
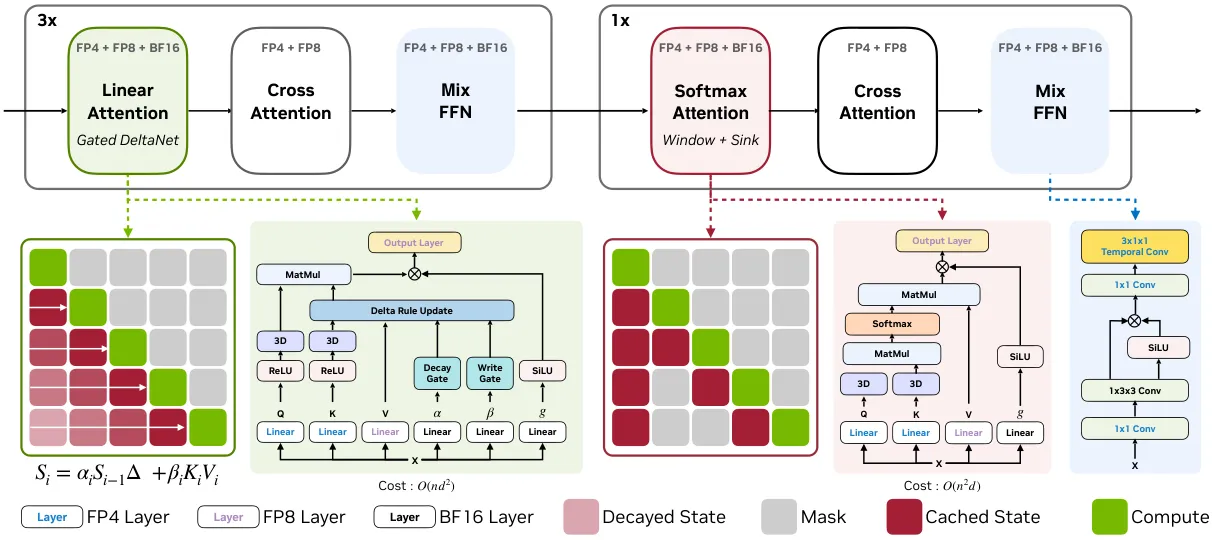
SANA-Streaming 的出发点,是实时 V2V 编辑有两个互相打架的要求:吞吐必须压过进帧速度,时序一致性又要求第 N 帧和第 N-1 帧对得上。此前多数编辑方法在离线片段上优化画质,要么远低于实时,要么在长流上漂移。论文的答案是协同设计:混合扩散 Transformer 让大部分块沿用 SANA 家族便宜的线性注意力,只在一个最吃局部细节的块上付费上 softmax 注意力;Cycle-Reverse Regularization 用「从生成内容反推源帧」的循环监督绕开根本不存在的成对长编辑视频;再配上按真实吞吐剖析调出来的 Blackwell 融合内核与混合精度量化。
已公布的硬数字是:1280x704 分辨率、端到端 24 FPS、DiT 核心单独 58 FPS,全部跑在一张 RTX 5090 上。论文还自称在时序一致性与系统吞吐两个轴上都超过现有 SOTA,但现有材料没点名胜过的基线,也没给出一个一致性指标的具体值,这条只能当方向性结论听。能放心拿走的是吞吐数字和架构论点:实时高分辨率编辑如今是消费级显卡问题,不是数据中心问题,这对直播、游戏等回传服务器不可接受的场景才关键。
LoomVideo:一个 5B 模型通吃生成与编辑
LoomVideo 打的是另一种成本。统一编辑器通常把源片段的隐变量 token 拼到目标序列上,而自注意力对序列长度是平方复杂度,多进一条视频,注意力计算大约翻四倍。LoomVideo 的做法是把干净源视频的隐变量乘一个可学习的系数,直接加进加噪的目标隐变量,序列长度原地不动。论文其余部分都在托住这一招:用 Qwen3-VL 8B 多模态大模型替代 T5 读提示词,Deepstack 把多层 MLLM 特征注进 DiT,Negative Temporal RoPE 把参考帧停在这条片的时间轴之外。
结果是一个 5B 模型编辑 480x832x97 视频只要 166.30 秒,而 8.3B 的 OmniWeaving 要 899.32 秒(公布的 5.41 倍就是对这个对手),13B 的 UniVideo 要 6140.18 秒。VBench 上 RL 版拿到 63.15,压过 UniVideo 的 63.01 和 Wan 2.2 的 62.50,参数量却不到前者一半。要避免的误读是:所有基线都是开源统一系统,论文没和前沿闭源视频生成器比过,63.15 是这一能力档里的强开源分数,不是画质天花板。诚实的声明是效率:把文生视频、指令编辑、参考图编辑、多图生视频折进一个小模型,编辑还很便宜。值得注意的是,论文自己的文生视频对编辑耗时(132.23 秒对 166.30 秒,涨 26%,而 UniVideo 跳 3.4 倍)比标题的 5.41 倍更能证明 Scale-and-Add 有效,因为跨模型倍数里掺了参数量差异。
CoVEBench:排行榜上看不见的指令遵循缺口
第三篇把问题从「多快」「多省」换成「照做了没有」。CoVEBench 的观察是:真实用户的请求是组合式的,一条提示常常同时要求改主体、改动作、改机位,还严格保住建模之外的一切。现有基准围着孤立的单点编辑和粗糙的全局指标转,诊断不了模型怎么处理这种复合活。CoVEBench 补上缺的考题:416 个精选源视频、626 条多点编辑指令、9990 个细粒度检查项,由 MLLM 评委按指令遵从度和视频保真度打分,辅以自动化质量指标。
已公布的发现是定性但尖锐的:多个操作挤进一条提示时,现有模型经常漏做编辑、违反保留约束或引入伪影。摘要没给逐模型分数,本页也不编排名。它的贡献在诊断:9990 项检查清单能说清捆在一起的编辑哪条活了哪条死了,这正是 VBench 均值或编辑耗时表盖住的失败面。对做产品的人,难堪的含义是:两篇系统论文的招牌数字,测的任务都比用户实际输入的简单。
怎么选
按瓶颈选,因为三篇是三个不同问题的答案。
- 瓶颈是延迟(直播流、端上、不能回传服务器): 只有 SANA-Streaming 为这种场景而生,单张 RTX 5090 上 1280x704 的 24 FPS 也是三者中唯一公布的实时锚点。
- 瓶颈是成本和产品面(一个模型既要生成又要编辑): 如果你的编辑器现在在拼接参考片段,LoomVideo 的 Scale-and-Add 几乎是白换的条件化方案,而它生成转编辑几乎平的耗时曲线(涨 26% 对涨 3.4 倍)是最可移植的经验。
- 瓶颈是质量保证(上线了编辑功能,想知道哪里会崩): CoVEBench 的检查项评分能告诉你捆在一起的编辑哪条失败,而不只是输出像不像样。信任何平均分之前先跑它。
认真做产品的团队很可能三个视角都要:SANA-Streaming 的协同设计思路用于服务链路,LoomVideo 的条件化技巧用于模型,CoVEBench 的评测逻辑用于上线前的诚实声明。
局限与存疑
最深的缺口是三篇从未同台。SANA-Streaming 的实时吞吐从没上过 CoVEBench 的组合式检查单,LoomVideo 的 Scale-and-Add 编辑从没在流式分辨率下评过指令可靠性,也没有论文量过一条 626 项指令的提示撞上「每帧必须 42 毫秒内出完」会发生什么。任何把三者排进一张名次的表都是编数据,本页刻意不这么做。
每篇内部还有更小但真实的洞。SANA-Streaming 的时序一致性优势没给指标也没点基线,24 对 58 FPS 的拆分没做归因,数字绑死 Blackwell 硬件,可移植性未知;Cycle-Reverse Regularization 从生成内容反推源帧,原理上可能把编辑往「改动偏小」的方向带。LoomVideo 缺隔离 Scale-and-Add、MLLM 编码器、Deepstack 的干净消融,没做同参数量级的耗时对比,没给额外 8B MLLM 的显存账,训练数据偏电商和时尚(把 FashionVideoBench 的 4.59 抬高了),并自认高动态场景下有眼睛扭曲、肢体不自然等视觉伪影。CoVEBench 的检查清单评委本身是 MLLM,遵从度分数继承了评委偏差;覆盖范围被 416 个源视频框住;没有逐模型分数,外界暂时无法用它跟踪这个领域的进展。
常见问题
SANA-Streaming 的 24 FPS 和 58 FPS 分别是什么口径?
24 FPS 是端到端吞吐,58 FPS 是 DiT 核心单独跑的吞吐,都在 1280x704、单张 RTX 5090 下测得。两者的差说明瓶颈在外围管线而不是模型本身。
LoomVideo 的 5.41 倍加速到底对的是谁?
是编辑耗时对 OmniWeaving(8.3B)的比值,视频规格 480x832x97:166.30 秒对 899.32 秒。对 13B 的 UniVideo 差距约 37 倍(166.30 秒对 6140.18 秒)。由于跨了参数量,同模型内部的信号更可信:文生视频 132.23 秒涨到编辑 166.30 秒,只涨 26%。
CoVEBench 对比 VBench 多测了什么?
VBench 把生成质量摊成一个均值。CoVEBench 把 626 条组合式编辑指令拆成 416 个源视频上的 9990 个可检查项,所以它能报出「第五条编辑漏做了」「违反保留约束」「引入伪影」这类结论,而不只是给整条片段打个分。
这三篇论文里哪个视频编辑模型全面最强?
给不出赢家:三篇协议、硬件、指标全不同,也没有共享基准。各自在自己的轴上领先(吞吐、统一成本、指令可靠性),另两条轴上都没被测过。
工程上如何同时借鉴三个方法?
模型层抄 LoomVideo 的 Scale-and-Add 条件化,服务链路抄 SANA-Streaming 的协同设计(混合注意力、循环正则、按剖析调量化),上线前抄 CoVEBench 的检查项评测。三者各是半个答案,缺的那个实验是把它们装进同一套系统再测。