
CLIP vs DINOv2:要语言对齐的零样本特征,还是冻结即用的自监督特征?
CLIP 用 4 亿图文对训练,靠文本提示做零样本分类;DINOv2 不用标签,在 1.42 亿精选图上自监督训练,冻结特征多数基准超过 OpenCLIP。
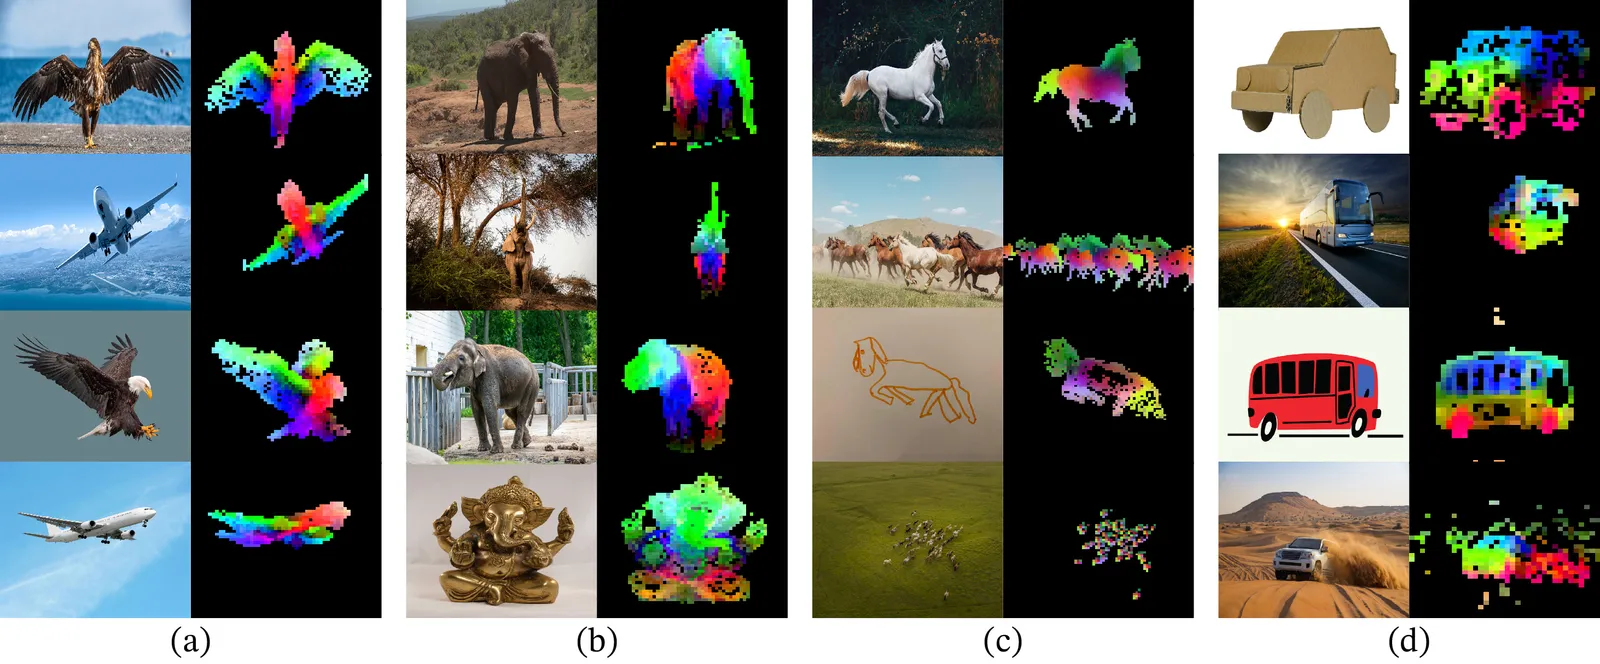
两句话版本
CLIP 和 DINOv2 是视觉基础模型时代复用最多的两个特征提取器,赌的方向完全相反。OpenAI 的 CLIP 从 4 亿互联网图文对里学习,让图像和文本共处同一个嵌入空间,回报是不用重训、写提示词就能零样本分类。Meta AI 的 DINOv2 则完全不用文本和标签:在一个 1.42 亿张精选图像的数据集上自监督训练 10 亿参数的 ViT,产出的冻结特征按论文说法在多数基准上追平甚至超过当时最强的通用特征 OpenCLIP,而且图像级和像素级都成立。所以”CLIP 还是 DINOv2”的真实问题是:任务有没有语言侧?要图像级特征还是像素级特征?
关键数字
下表数字全部来自两篇论文各自的页面;分类行是论文自己声明的设计目标。
| 维度 | CLIP | DINOv2 |
|---|---|---|
| 监督信号 | 4 亿互联网图文对(对比学习) | 无:自监督,无标签,无文本 |
| 训练数据 | 4 亿(图像,文本)互联网图文对 | LVD-142M:1.42 亿张图,自动精选去重 |
| 旗舰模型 | 配对的图像与文本编码器 | 10 亿参数 ViT 教师,蒸馏出更小学生 |
| 预期用法 | 零样本:把类别写成句子算相似度 | 冻结骨干 + 轻量探针(如线性分类器) |
| 语言接口 | 原生:图文共享嵌入空间 | 没有:无文本编码器,无提示机制 |
| 招牌结果 | 零样本追平原始 ResNet-50 的 ImageNet 准确率,且没用其 128 万张标注训练图 | 蒸馏学生在多数图像级和像素级基准上超过当时的 OpenCLIP |
| 声称的任务广度 | 30 多个视觉数据集上实现非平凡迁移:OCR、视频动作识别、地理定位、细粒度分类 | 跨图像分布和任务的通用特征,像素级任务(分割、深度)被点名为难点 |
| 论文自己承认的短板 | 继承未整理网页数据的偏差与噪声;准确率对提示词措辞敏感 | 赢的是”多数基准而非全部”;医学、科学、卫星等远域仍需自行评测 |
值得注意的不对称:CLIP 的招牌数字是单任务等价(ImageNet 上追平 ResNet-50),DINOv2 的招牌数字是广度主张(多数基准、两个任务层级)。这不是巧合。CLIP 的论文要证明”语言监督这条路走得通”,DINOv2 的论文则要主张”自监督特征从此就是默认骨干”。
CLIP 有而 DINOv2 没有的
用语言操作视觉。 CLIP 的图文共享空间意味着用写句子来指挥模型:分类就写 a photo of a {label},检索就写查询语句,内容安全过滤和文生图模型也能架在同一套嵌入上。DINOv2 根本没有文本编码器,没有任何东西可以提示。
零样本部署。 CLIP 换任务只换文本、不换权重:编码候选标签、和图片算相似度、结束。论文的演示刻意做得极端:零样本 CLIP 追平原始 ResNet-50 的 ImageNet 准确率,一张那 128 万张标注图都没用过。对每周上线新类别的产品团队,这个性质比一两个点的准确率值钱。
另一种意义上的脏数据鲁棒。 CLIP 的监督信号就是图片在网页上碰巧配着的标题:噪声大、有偏,但词汇量事实上无限。论文也坦率承认模型继承了网页的分布,且零样本准确率随提示词写法波动(写成 a photo of a {label} 和裸单词结果不同)。这个提示敏感性是真实的运维成本:零样本 CLIP 识别的往往是文本关联而非概念落地,数个数这类系统性任务就很弱。
DINOv2 有而 CLIP 没有的
冻结特征扛住稠密任务。 DINOv2 的设计目标和微调相反:骨干冻结,只在上头训一个轻量探针。让它成为默认骨干的结果是像素级的:论文报告冻结特征好到能直接做分割和深度,而这两类稠密任务通常必须要专门微调的任务网络。CLIP 的嵌入是池化后的图像级描述子,像素级本就不是它的活。
端到端免标注。 训练不要标签,下游不要标签,也不需要调提示词。对文本描述稀缺的领域(显微影像、工业质检、卫星场景),CLIP 的监督信号又薄又不匹配,DINOv2 却只需要图像。但 DINOv2 论文页自己点明了坑:远域仍然要自己做评测,因为自监督特征不保证没有盲区,精选集排除了什么也决定了模型看不见什么。
一条可迁移的数据方法论。 DINOv2 最可复用的想法不在架构,而在”决定可迁移性的是精选而不是堆规模”这个主张:用自动过滤去重流水线从原始来源里筛出 LVD-142M,全程没有任务标签参与。CLIP 教的是同一时代的相反一课:在网页规模上,脏数据会被规模稀释。两课都对,只是指向流水线的不同环节。
怎么选
- **零样本分类、图文检索、内容审核,或任何”类别以文字形式出现”的任务:**CLIP。调提示词比任何训练都便宜。
- **分割、深度估计、对应点匹配等像素级任务:**DINOv2。这是论文的招牌强项,也是 CLIP 的结构短板。
- **想要一个免标注、跨任务复用的冻结特征提取器:**DINOv2,而且选蒸馏学生而不是 10 亿参数教师;论文自己的说法是小学生已超过此前的通用特征。
- **计划微调视觉骨干、产品里又有语言侧:**CLIP 系骨干保住文本通路,DINOv2 出视觉侧。
- **远离网页分布的影像(医学、科学、卫星):**两个都别先信。DINOv2 的页面明说远域要自评,CLIP 按构造就继承网页偏差。先攒一个评测集再定。
- **实际工程中两个都用:**检索和重排系统常同时用两种特征——CLIP 相似度回答”和查询匹不匹配”,DINOv2 特征回答”视觉上是不是同一个东西”。
局限与存疑
两篇论文不共享评测口径,招牌数字不能直接比:CLIP 的”追平 ResNet-50”是单基准等价,DINOv2 的”多数基准”则刻意横跨几十个。两个论文页都没有给出同口径对照表(同一批任务、同一种探针同时评 CLIP 和 DINOv2 特征),所以任何”谁更好”的精确数值排名都是编出来的,不是测出来的。CLIP 的提示敏感性意味着它的零样本分数随提示词设计波动,不纯是模型质量问题。DINOv2 的”多数基准”措辞留了真实的缺口,10 亿教师也贵到几乎所有人都在用蒸馏学生。另外两篇都是 2021-2023 年的血统:新部署请把本页当作特征提取取舍的参照系,再对同时用两种监督训练的当代骨干做验证。
常见问题
DINOv2 比 CLIP 强吗?
得看任务才能说”强”。像素级任务(分割、深度)和免标注的冻结特征提取,明确选 DINOv2:论文报告其蒸馏学生在多数图像级和像素级基准上超过 OpenCLIP。零样本分类和一切带文本接口的任务,CLIP 是两者中唯一做得了的。
CLIP 和 DINOv2 最大的区别是什么?
监督方式。CLIP 从 4 亿图文对里学习,特征天然和语言对齐,可以把类别写成提示词做零样本分类;DINOv2 不用文本也不用标签,在 1.42 亿张精选图(LVD-142M)上自监督训练,产出冻结特征,配一个轻量探针复用。CLIP 的特征能被语言查询,DINOv2 的不能。
DINOv2 能像 CLIP 一样做零样本分类吗?
不能按 CLIP 的意义做。DINOv2 没有文本编码器,没有可以编码标签的提示词。它的用法正好相反:冻结骨干,在你的标注数据上训一个小探针(常常只是线性分类器),让预训练特征干重活。没有探针也没有标签,你得到的是特征,不是预测。
分割任务用 CLIP 还是 DINOv2?
按 DINOv2 论文自己的主张,选 DINOv2。DINOv2 页面上的招牌结果就是冻结特征在像素级任务(分割、深度)上可用,而这正是通常必须微调任务专用网络的场景。CLIP 的架构产出的是池化后的图像级、文本对齐嵌入,不是逐像素的稠密特征。
我需要下 10 亿参数的 DINOv2 吗?
一般不需要。10 亿 ViT 是教师,已经蒸馏成更小的学生,而论文报告学生已超过此前的通用特征。多数应用用蒸馏学生就能拿到质量,不必付教师训练和推理的成本。