
SAM 和 SAM 2 的区别:图像快 6 倍,真正的差异在视频记忆
SAM 2 在同一套图像基准上 1 点击 mIoU 58.9 对 SAM 的 58.1,单卡快 6 倍(21.7 对 130.1 FPS),并用流式记忆库把单次提示变成整段视频的物体追踪。
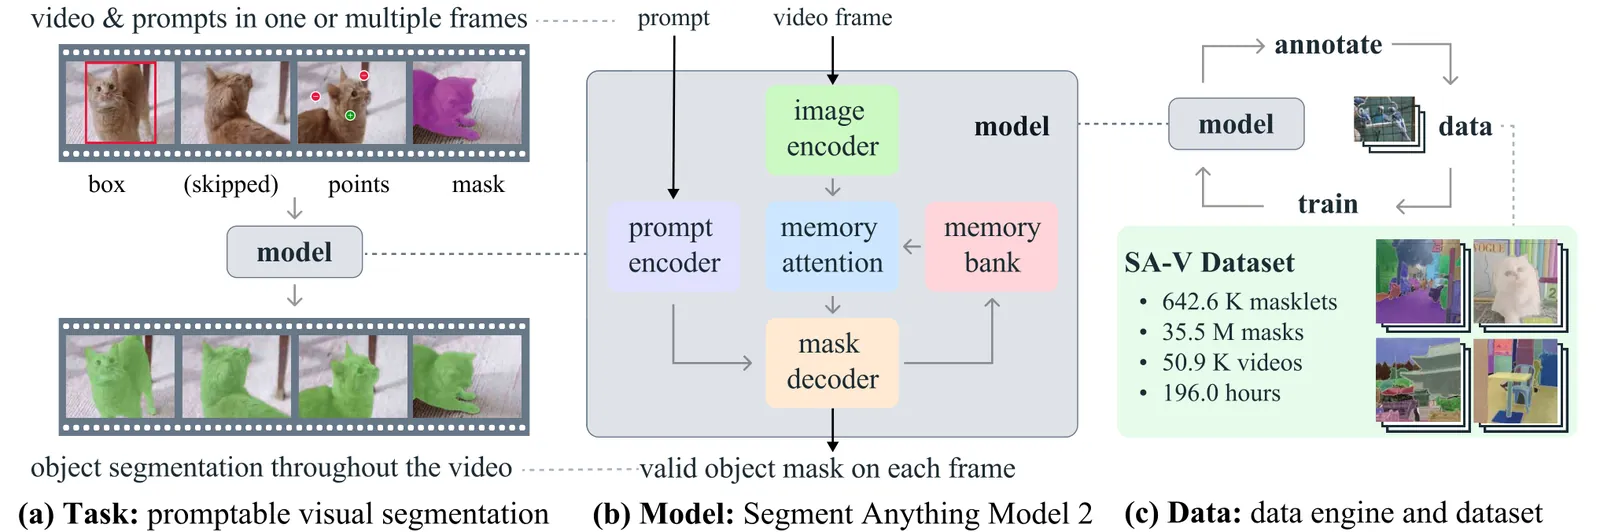
两个模型,两个问题
SAM 解决的是数据问题。这篇论文留给行业的东西,一半是 SA-1B 数据集(1100 万张授权图像上的 11 亿个掩码),一半是模型本身:三级数据引擎让模型和数据互相 bootstrap,最终得到一个可提示的分割器,对没见过的图像和任务零样本迁移。SAM 的思考单位是单帧。给它一个点、一个框或一个粗掩码,它返回那一帧的掩码,到此为止。
SAM 2 解决的是时间问题。视频里的可提示分割意味着:提示可能落在任意一帧,而掩码必须在此后每一帧都保持正确,哪怕物体被遮挡、消失后重新出现、形变或离场。SAM 2 保留了同样的提示方式(点、框、掩码),但把掩码解码器包进了一个流式循环:每一帧的预测写入记忆库(memory bank),当前帧通过记忆注意力模块读取模型已经看过的内容。这就是全部关键架构差异,也正是它把”一次提示”变成了”一条轨迹”。
关键数字
下表里所有 SAM 对 SAM 2 的行,都来自 SAM 2 论文自己的评测,同一团队、同一套评测流程,是目前最接近受控对比的数据。按第一方数字看,不要当成第三方复现。
| 指标 | SAM | SAM 2 | 设置与出处 | 同一套评测? |
|---|---|---|---|---|
| 训练数据 | SA-1B:11M 图像、1.1B 掩码 | SA-1B + SA-V:50.9K 视频、642.6K masklet(3550 万掩码、196 小时) | 两篇论文数据节 | 否,模态不同 |
| 图像零样本,1 点击 mIoU(SA-23 均值) | 58.1 | 仅 SA-1B 训练 58.9;全量数据 61.9 | SAM 2 论文 Table 5 | 是 |
| 图像零样本,5 点击 mIoU(SA-23 均值) | 81.3 | 仅 SA-1B 训练 81.7;全量数据 83.5 | Table 5 | 是 |
| 速度,单张 A100,batch 1 | 21.7 FPS | 130.1 FPS | Table 5 | 是,约 6 倍 |
| 视频零样本,1 点击 J&F(17 个数据集均值) | 外接 XMem++ 56.9;外接 Cutie 56.7 | 64.7 | Table 4 | 是,对手是 SAM 加追踪器管线 |
| 视频零样本,5 点击 J&F(17 个数据集均值) | 70.6(XMem++);72.2(Cutie) | 77.6 | Table 4 | 是 |
| 半监督 VOS,MOSE val J&F | 不适用 | 76.6(Hiera-B+);77.9(Hiera-L);此前最佳 Cutie-base+ 71.7 | Table 6,首帧真值掩码提示 | 是,对手是已发表 VOS 系统 |
| 交互式标注效率 | 不适用 | 达到同等精度所需交互次数比 SAM+XMem++、SAM+Cutie 少 3 倍以上 | 论文 6.1 节,9 个稠密标注数据集,每帧 3 次点击 | 是 |
这张表有两个容易读错的点。第一,图像 mIoU 的差距很小:58.1 对 58.9 只差 0.8,全量训练的 SAM 2 也就 61.9。 workload 是纯静态图像的话,SAM 2 不是质量革命,而是一场恰好附带了小幅质量提升的速度革命。第二,视频各行里 SAM 从来不能以本体身份出现,因为它没有时间机制。“SAM 做视频”最诚实的基线是把 SAM 的掩码喂给 XMem++ 或 Cutie 这类专用视频目标分割追踪器,而这样的两模型管线在 1 点击下落后约 8 个 J&F 点,达到同等精度还需要更多人工交互。
6 倍速度从哪来
这个速度差既不是玄学,也主要不是工程优化。SAM 跑的是 ViT-H 图像编码器;SAM 2 换成了更小的 Hiera-B+ 编码器,论文把吞吐量差异(单卡 A100 上 21.7 对 130.1 FPS)主要归因于此。编码器变小之后,视频记忆模块才有预算在逐帧推理时去 attend 已存储的帧特征。
这个交换里藏着一个代价。只用 SA-1B 训练的 SAM 2,在 14 个新收集的视频数据集”按静态图评估”时其实输给 SAM:1 点击 mIoU 56.6 对 59.1。把它拉到 69.6、并把 SA-23 图像均值推到 61.9 的是视频数据混合训练,也就是 SA-V 的 64.26 万 masklet(19.09 万人工标注,其余由数据引擎生成并质检)。所以还是那个配方:真正干重活的是数据集,和第一篇论文里 SA-1B 的故事一模一样,只是上了一个层级。
SAM 1 仍然够用的场景
SAM 没有过时,数字也没有说它过时。在有充足领域标注的固定图像任务上,专用监督模型(比如 Mask2Former)仍然可以赢过零样本提示模型,SAM 自己的论文也承认这一点。SAM 还有多年生态:标注工具、微调权重、已部署的标注管线、按它的 API 写死的硬件集成。如果你的产品一张张标注商品图、病理切片或地图瓦片,现有管线已经跑得动,那么 0.8 个 mIoU 和 6 倍吞吐本身不足以构成迁移理由。另外 SAM 2 的图像侧换了一套编码器家族,基于 SAM 特征训练过的嵌入和下游头部不能直接搬过去。
怎么选
- 任何视频 workload,标注或推理: 无条件选 SAM 2。SAM 加追踪器曾是最佳实践,而 SAM 2 在精度、交互次数和简洁性(一个模型而非两个)上全面超过这套组合。
- 大规模交互式视频标注: 单为效率也该选 SAM 2。达到同等掩码质量所需交互次数少 3 倍以上,直接乘在标注吞吐上,SA-V 本身就是用这套循环标注出来的。
- 已上线的静态图像管线: 吞吐不难受就留在 SAM。质量提升真实但有限,下次动管线时再迁。
- 要的是稠密特征而不是掩码: 两个都不对,看自监督骨干(如 DINOv2),它为冻结特征而生,不做可提示分割。
局限与存疑
所有同套评测数字都是第一方:Meta 造了 SAM 2,也由它自己评测两个模型。这里没有任何独立复现,而 SAM 1 的社区经验是,第三方结果在分布外图像上有时会与论文数字有出入。视频评测本身很年轻:SAM 2 报告的 17 个零样本视频数据集和 J&F 均值,很大程度上由论文自己引入或汇总,所以”视频上的最优”目前等于”在作者自己组装的基准上最优”。失效侧,论文自己的局限一节点了快速运动、复杂遮挡、消失与重现、小而细的物体,恰恰是记忆库必须跨间隙猜测的场景。最后,SA-V 的 64.26 万 masklet 里有 45.17 万是模型生成而非人工描绘,用于训练没问题,但引用数据集质量数字时要记得这一点。SAM 2 的记忆架构会成为视频感知的默认范式,还是被”分割只是副产品”的原生视频多模态模型取代,是这个对比回答不了的问题。
常见问题
SAM 2 在图像上全面碾压 SAM 吗?
不是。同一套评测下,仅用 SA-1B 训练时 1 点击 mIoU 58.9 对 58.1,5 点击 81.7 对 81.3;换全量数据后是 61.9 和 83.5。图像侧真正决定性的数字是速度:单卡 A100 上 130.1 对 21.7 FPS。输入是静态图像、现有管线速度也够,单为精度不值得迁。
SAM 外接 XMem++ 或 Cutie 这类追踪器能做视频吗?
这曾 经是标准做法,SAM 2 论文也直接量了:SAM 掩码接 XMem++ 或 Cutie,在 17 个零样本视频数据集上 1 点击平均 J&F 分别是 56.9 和 56.7,SAM 2 是 64.7。交互式标注中 SAM 2 达到同等精度所需交互次数少 3 倍以上。两模型管线还要面对双份的集成成本和双份的失效模式,而 SAM 2 的记忆库是内置的。
SAM 2 每帧干的活更多,为什么反而更快?
SAM 2 每帧的活确实更多,但图像编码器更小。SAM 用 ViT-H 编码器,单卡 A100 21.7 FPS;SAM 2 用 Hiera-B+,130.1 FPS,论文把加速主要归因于这个更小更高效的编码器。记忆注意力和记忆库确实引入额外计算,但它们作用在压缩后的存储特征上,净效果即使加上视频机制仍快约 6 倍。
SAM 2 选 Hiera-B+ 还是 Hiera-L?
默认 Hiera-B+:半监督 VOS 协议下 MOSE val 76.6 J&F。Hiera-L 用更高的每帧算力换约一到一个半点(77.9)。交互式标注或接近实时的场景选 Hiera-B+;离线批量处理归档素材、要最高掩码质量就选 Hiera-L。
SA-V 数据集能用来训自己的模型吗?
能。Meta 按 SA-1B 同款开放模式,随模型一起发布了 SA-V 数据集(50.9K 视频、64.26 万 masklet、196 小时)、训练代码和演示。注意构成:19.09 万 masklet 是人工标注,45.17 万是数据引擎生成后质检的,依赖人工精度的场景要掂量这一点。